


 Lar
DeepSeek V4 Flash: Um motor de inferência em pequena escala que quebra a tradição
À medida que a inteligência artificial avança rapidamente, o DeepSeek V4Flash está estabelecendo um novo padrão para motores de inferência local por meio de suas vantagens distintas. Desenvolvido especificamente para a plataforma Metal, este motor leve oferece uma experiência de inferência local mais rápida e adaptável. Em vez de servir como uma ferramenta de uso geral, o DeepSeek V4Flash é otimizado exclusivamente para o modelo DeepSeek V4Flash, garantindo desempenho máximo para seu uso pretendido.
Além da velocidade bruta, o DeepSeek V4Flash se destaca em sua arquitetura de raciocínio. Com menos parâmetros do que modelos comparáveis, ele processa tarefas com maior eficiência. Em seu modo de raciocínio, ele resolve consultas complexas em apenas um quinto do tempo exigido por outros modelos, tornando-o altamente eficaz para cenários exigentes em várias aplicações.
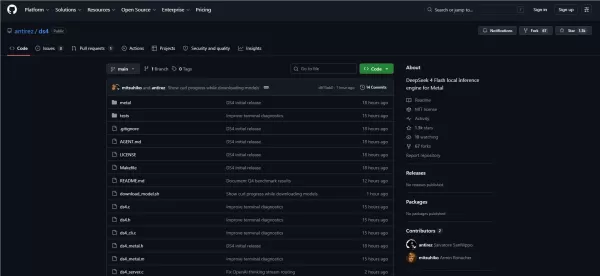
Além disso, o DeepSeek V4Flash possui uma janela de contexto massiva capaz de lidar com até um milhão de tokens. Esse poder de processamento extenso permite que ele navegue por tópicos de ponta sem esforço, seja discutindo programação em italiano ou assuntos políticos, demonstrando uma base de conhecimento robusta.
Quanto à compatibilidade com hardware, o DeepSeek V4Flash suporta quantização de 2 bits em um MacBook com 128 GB de RAM, entregando resultados impressionantes. A equipe do DeepSeek também planeja lançar uma versão mais poderosa no futuro para melhorar ainda mais a experiência do usuário.
Mais do que apenas um motor de inferência, o DeepSeek V4Flash oferece uma solução local abrangente, incluindo uma API HTTP e modelos GGUF especialmente desenvolvidos. Essa integração garante serviço e suporte contínuos para os usuários. No entanto, os usuários devem observar que a versão atual ainda está na fase Alpha e requer refinamento adicional.
Em conclusão, o DeepSeek V4Flash emergiu como uma opção destacada na inferência local graças ao seu design único e capacidades poderosas, com desenvolvimentos promissores no horizonte.
Artigo relacionado
 Tony Fadell explica por que a primeira onda de gadgets de IA falhou — e o que vem a seguir
As Tony Fadell steps onto the stage at the inaugural MIT Future Fest, he displays a slide featuring three discontinued, heavily hyped AI devices: the Rabbit R1, the Humane AI pin, and the Limitless pendant.“Estes representaram a geração inicial de p
Coreia do Sul aprova lei para impulsionar a IA, permitindo o uso limitado de dados pessoais após análise regulatória
O Comitê Coreano de Proteção de Dados Pessoais anunciou recentemente que a Assembleia Nacional aprovou por unanimidade uma emenda à Lei de Proteção de Dados Pessoais, permitindo que desenvolvedores de
Hygon DCU Executa Modelos de Trilhões de Parâmetros com Paralelismo Especializado Kimi K3
A infraestrutura de computação doméstica conseguiu, pela primeira vez, executar um modelo de trilion de parâmetros. A Hai Guang Information confirmou a adaptação completa em pilha de software e a validação de desempenho do Kimi K3 em sua plataforma D
Recomendações de tópicos especiais relacionados
Financiar
 Ferramentas de previsão de fluxo de caixa com IA para as finanças de pequenas empresas
As melhores e mais bem avaliadas ferramentas de previsão de fluxo de caixa com IA para finanças de pequenas empresas em 2026 estão aqui no XIX.AI! Nossa lista selecionada apresenta soluções poderosas e revolucionárias, submetidas a testes práticos, para ajudar os proprietários de pequenas empresas a aumentar a precisão financeira, planejar orçamentos com mais eficácia e evitar problemas de fluxo de caixa. Veja uma comparação entre as versões gratuitas e pagas e explore agora para encontrar a ferramenta perfeita para uma gestão financeira sem complicações.
 7 ferramentas
 xix.ai
código
Os melhores chatbots de programação com IA: depure Python, JS e SQL em um só lugar
Os melhores e mais bem avaliados chatbots de programação com IA de 2026, selecionados especialmente para desenvolvedores! Experimente ferramentas poderosas e revolucionárias que ajudam a depurar rapidamente problemas em Python, JS e SQL. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para encontrar a opção perfeita para aumentar sua produtividade na programação. Experimente o XIX.AI hoje mesmo para explorar o potencial da IA! Explore agora.
12 ferramentas
xix.ai
Incitar
Plataformas de Versionamento de Prompts de IA para Playbooks Reutilizáveis do Claude e ChatGPT
As melhores plataformas de versionamento de prompts de IA mais recentes e com as melhores avaliações de 2026 para playbooks reutilizáveis estão aqui na XIX.AI! Nossa lista curada inclui ferramentas poderosas que mudam o jogo e ajudam você a acompanhar todos os prompts, testar variações de forma eficiente e aumentar a produtividade em escrita, criação de conteúdo e muito mais. Obtenha uma comparação gratuita entre versões gratuitas e pagas, juntamente com testes do mundo real e classificações atualizadas semanalmente. Explore agora para descobrir a ferramenta perfeita para se manter à frente nas tarefas de IA!
9 ferramentas
xix.ai
escrita
Os melhores assistentes de redação com IA para artigos longos: elabore esboços e rascunhos mais rapidamente
Os melhores assistentes de redação com IA de 2026 para artigos longos: elabore esboços e rascunhos mais rapidamente. A XIX.AI seleciona as ferramentas mais bem avaliadas e imperdíveis, que oferecem um suporte poderoso e revolucionário para aumentar significativamente a eficiência na redação. Você encontrará comparações detalhadas entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Explore agora para descobrir sua ferramenta perfeita e comece a criar hoje mesmo para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de estudo do ChatGPT para revisão para provas, cartões de memorização e explicações de tarefas de casa
2026: As melhores e mais recentes ferramentas de estudo do ChatGPT para revisão de provas, flashcards e explicações de lição de casa! A XIX.AI selecionou uma lista das melhores ferramentas revolucionárias, projetadas para aumentar sua produtividade. Essas soluções imperdíveis oferecem comparações entre versões gratuitas e pagas, testes práticos e classificações detalhadas para ajudar você a encontrar a opção perfeita para uma preparação eficiente para provas e apoio nos deveres de casa. Explore agora para aproveitar ao máximo as vantagens da IA!
10 ferramentas
xix.ai
Educação e Aprendizagem
Ferramentas de planejamento de estudos com IA para a preparação para exames
As melhores e mais bem avaliadas ferramentas de planejamento de estudos com IA para preparação para exames em 2026 estão aqui no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que ajudam você a otimizar seu processo de revisão, aumentar o foco e criar cronogramas de estudo personalizados. Realizamos testes práticos para identificar as melhores opções, oferecendo uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Soluções imperdíveis, projetadas para maximizar sua produtividade e ajudá-lo a se sair muito bem em todas as provas. Explore agora para encontrar a ferramenta perfeita para você!
14 ferramentas
xix.ai

 Comentários (0)
À medida que a inteligência artificial avança rapidamente, o DeepSeek V4Flash está estabelecendo um novo padrão para motores de inferência local por meio de suas vantagens distintas. Desenvolvido especificamente para a plataforma Metal, este motor leve oferece uma experiência de inferência local mais rápida e adaptável. Em vez de servir como uma ferramenta de uso geral, o DeepSeek V4Flash é otimizado exclusivamente para o modelo DeepSeek V4Flash, garantindo desempenho máximo para seu uso pretendido.
Além da velocidade bruta, o DeepSeek V4Flash se destaca em sua arquitetura de raciocínio. Com menos parâmetros do que modelos comparáveis, ele processa tarefas com maior eficiência. Em seu modo de raciocínio, ele resolve consultas complexas em apenas um quinto do tempo exigido por outros modelos, tornando-o altamente eficaz para cenários exigentes em várias aplicações.
Além disso, o DeepSeek V4Flash possui uma janela de contexto massiva capaz de lidar com até um milhão de tokens. Esse poder de processamento extenso permite que ele navegue por tópicos de ponta sem esforço, seja discutindo programação em italiano ou assuntos políticos, demonstrando uma base de conhecimento robusta.
Quanto à compatibilidade com hardware, o DeepSeek V4Flash suporta quantização de 2 bits em um MacBook com 128 GB de RAM, entregando resultados impressionantes. A equipe do DeepSeek também planeja lançar uma versão mais poderosa no futuro para melhorar ainda mais a experiência do usuário.
Mais do que apenas um motor de inferência, o DeepSeek V4Flash oferece uma solução local abrangente, incluindo uma API HTTP e modelos GGUF especialmente desenvolvidos. Essa integração garante serviço e suporte contínuos para os usuários. No entanto, os usuários devem observar que a versão atual ainda está na fase Alpha e requer refinamento adicional.
Em conclusão, o DeepSeek V4Flash emergiu como uma opção destacada na inferência local graças ao seu design único e capacidades poderosas, com desenvolvimentos promissores no horizonte.








 Tony Fadell explica por que a primeira onda de gadgets de IA falhou — e o que vem a seguir
As Tony Fadell steps onto the stage at the inaugural MIT Future Fest, he displays a slide featuring three discontinued, heavily hyped AI devices: the Rabbit R1, the Humane AI pin, and the Limitless pendant.“Estes representaram a geração inicial de p
 Coreia do Sul aprova lei para impulsionar a IA, permitindo o uso limitado de dados pessoais após análise regulatória
O Comitê Coreano de Proteção de Dados Pessoais anunciou recentemente que a Assembleia Nacional aprovou por unanimidade uma emenda à Lei de Proteção de Dados Pessoais, permitindo que desenvolvedores de
 Hygon DCU Executa Modelos de Trilhões de Parâmetros com Paralelismo Especializado Kimi K3
A infraestrutura de computação doméstica conseguiu, pela primeira vez, executar um modelo de trilion de parâmetros. A Hai Guang Information confirmou a adaptação completa em pilha de software e a validação de desempenho do Kimi K3 em sua plataforma D
As melhores e mais bem avaliadas ferramentas de previsão de fluxo de caixa com IA para finanças de pequenas empresas em 2026 estão aqui no XIX.AI! Nossa lista selecionada apresenta soluções poderosas e revolucionárias, submetidas a testes práticos, para ajudar os proprietários de pequenas empresas a aumentar a precisão financeira, planejar orçamentos com mais eficácia e evitar problemas de fluxo de caixa. Veja uma comparação entre as versões gratuitas e pagas e explore agora para encontrar a ferramenta perfeita para uma gestão financeira sem complicações.
7 ferramentas
xix.ai
Os melhores e mais bem avaliados chatbots de programação com IA de 2026, selecionados especialmente para desenvolvedores! Experimente ferramentas poderosas e revolucionárias que ajudam a depurar rapidamente problemas em Python, JS e SQL. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e classificações detalhadas, para encontrar a opção perfeita para aumentar sua produtividade na programação. Experimente o XIX.AI hoje mesmo para explorar o potencial da IA! Explore agora.
12 ferramentas
xix.ai
As melhores plataformas de versionamento de prompts de IA mais recentes e com as melhores avaliações de 2026 para playbooks reutilizáveis estão aqui na XIX.AI! Nossa lista curada inclui ferramentas poderosas que mudam o jogo e ajudam você a acompanhar todos os prompts, testar variações de forma eficiente e aumentar a produtividade em escrita, criação de conteúdo e muito mais. Obtenha uma comparação gratuita entre versões gratuitas e pagas, juntamente com testes do mundo real e classificações atualizadas semanalmente. Explore agora para descobrir a ferramenta perfeita para se manter à frente nas tarefas de IA!
9 ferramentas
xix.ai
Os melhores assistentes de redação com IA de 2026 para artigos longos: elabore esboços e rascunhos mais rapidamente. A XIX.AI seleciona as ferramentas mais bem avaliadas e imperdíveis, que oferecem um suporte poderoso e revolucionário para aumentar significativamente a eficiência na redação. Você encontrará comparações detalhadas entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Explore agora para descobrir sua ferramenta perfeita e comece a criar hoje mesmo para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
2026: As melhores e mais recentes ferramentas de estudo do ChatGPT para revisão de provas, flashcards e explicações de lição de casa! A XIX.AI selecionou uma lista das melhores ferramentas revolucionárias, projetadas para aumentar sua produtividade. Essas soluções imperdíveis oferecem comparações entre versões gratuitas e pagas, testes práticos e classificações detalhadas para ajudar você a encontrar a opção perfeita para uma preparação eficiente para provas e apoio nos deveres de casa. Explore agora para aproveitar ao máximo as vantagens da IA!
10 ferramentas
xix.ai
As melhores e mais bem avaliadas ferramentas de planejamento de estudos com IA para preparação para exames em 2026 estão aqui no XIX.AI! Esta coleção cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que ajudam você a otimizar seu processo de revisão, aumentar o foco e criar cronogramas de estudo personalizados. Realizamos testes práticos para identificar as melhores opções, oferecendo uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Soluções imperdíveis, projetadas para maximizar sua produtividade e ajudá-lo a se sair muito bem em todas as provas. Explore agora para encontrar a ferramenta perfeita para você!
14 ferramentas
xix.ai












