


 Maison
DeepSeek V4 Flash : un moteur d’inférence à petite échelle qui brise les conventions
Alors que l'intelligence artificielle progresse rapidement, DeepSeek V4Flash établit une nouvelle norme pour les moteurs d'inférence locale grâce à ses avantages distinctifs. Conçu spécifiquement pour la plateforme Metal, ce moteur léger offre une expérience d'inférence locale plus rapide et plus adaptable. Plutôt que de servir d'outil polyvalent, DeepSeek V4Flash est optimisé exclusivement pour le modèle DeepSeek V4Flash, garantissant des performances maximales pour son utilisation prévue.
Au-delà de la vitesse brute, DeepSeek V4Flash excelle dans son architecture de raisonnement. Avec moins de paramètres que les modèles comparables, il traite les tâches plus efficacement. En mode raisonnement, il résout des requêtes complexes en un cinquième du temps requis par d'autres modèles, ce qui le rend très efficace pour des scénarios exigeants dans diverses applications.
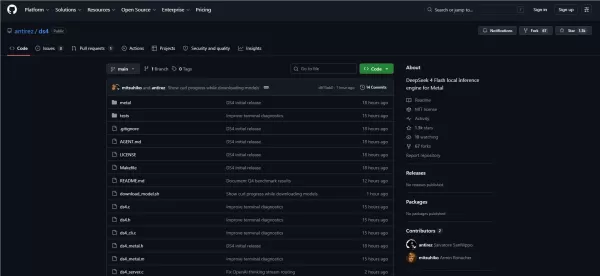
De plus, DeepSeek V4Flash dispose d'une fenêtre de contexte massive capable de gérer jusqu'à un million de jetons. Cette puissance de traitement étendue lui permet de naviguer sans effort dans des sujets de pointe, qu'il s'agisse de discuter de programmation italienne ou d'affaires politiques, démontrant ainsi une base de connaissances robuste.
En ce qui concerne la compatibilité matérielle, DeepSeek V4Flash prend en charge la quantification 2 bits sur un MacBook doté de 128 Go de RAM, offrant des résultats impressionnants. L'équipe DeepSeek prévoit également de publier une version plus puissante à l'avenir afin d'améliorer davantage l'expérience utilisateur.
Plus qu'un simple moteur d'inférence, DeepSeek V4Flash propose une solution locale complète, incluant une API HTTP et des modèles GGUF spécialement conçus. Cette intégration garantit un service et un support fluides pour les utilisateurs. Cependant, les utilisateurs doivent noter que la version actuelle reste au stade Alpha et nécessite encore des améliorations.
En conclusion, DeepSeek V4Flash s'est imposé comme une option remarquable pour l'inférence locale grâce à sa conception unique et ses capacités puissantes, avec des développements prometteurs à l'horizon.
Article connexe
 Tony Fadell explique pourquoi la première vague d’appareils intelligents basés sur l’intelligence artificielle a échoué, et ce qui arrive ensuite
Alors que Tony Fadell monte sur la scène du premier MIT Future Fest, il affiche une diapositive présentant trois appareils d’intelligence artificielle (IA) arrêtés et fortement médiatisés : le Rabbit R1, l’épingle IA Humane et le pendentif Limitless.
La Corée du Sud adopte une loi visant à stimuler le développement de l'IA en autorisant une utilisation limitée des données à caractère personnel après examen réglementaire
Le Comité coréen de protection des données personnelles a récemment annoncé que l’Assemblée nationale avait approuvé à l’unanimité un amendement à la loi sur la protection des données personnelles, au
Hygon DCU exécute des modèles de plusieurs milliards de paramètres avec la parallélisation d'experts Kimi K3
L'infrastructure informatique nationale a réussi à faire fonctionner pour la première fois un modèle de trillion de paramètres. Hai Guang Information a confirmé l'adaptation complète et la validation des performances de Kimi K3 sur sa plateforme DCU,
Recommandations de sujets spéciaux liés
Finance
 Outils d'IA pour la prévision des flux de trésorerie destinés aux petites entreprises
Les meilleurs outils de prévision de trésorerie basés sur l'IA pour la gestion financière des petites entreprises en 2026 sont disponibles sur XIX.AI ! Notre sélection regroupe des solutions puissantes et révolutionnaires, testées en conditions réelles, qui aident les chefs de petites entreprises à améliorer la précision de leurs prévisions financières, à planifier plus efficacement leurs budgets et à éviter les problèmes de trésorerie. Consultez notre comparatif entre les versions gratuites et payantes et découvrez dès maintenant l'outil idéal pour une gestion financière fluide.
 7 outils
 xix.ai
code
Les meilleurs chatbots d'IA pour la programmation : déboguez du Python, du JS et du SQL en un seul endroit
Les meilleurs chatbots d'IA pour le codage en 2026, sélectionnés pour les développeurs ! Découvrez des outils puissants et révolutionnaires qui vous aideront à déboguer rapidement vos problèmes en Python, JS et SQL. Consultez un comparatif entre les versions gratuites et payantes, ainsi que des tests en conditions réelles et des classements détaillés, pour trouver la solution idéale qui boostera votre productivité en programmation. Essayez XIX.AI dès aujourd’hui pour exploiter pleinement le potentiel de l’IA ! Découvrez-le dès maintenant.
12 outils
xix.ai
Rapide
Plateformes de versionnement des invites IA pour des playbooks réutilisables Claude et ChatGPT
Les meilleures plateformes de versionnement des invites IA les plus récentes et les mieux notées pour 2026, conçues pour des playbooks réutilisables, sont disponibles sur XIX.AI ! Notre liste soigneusement sélectionnée comprend des outils puissants qui changent la donne, vous aidant à suivre toutes vos invites, à tester efficacement les variations et à améliorer la productivité dans l’écriture, la création de contenu et bien plus encore. Obtenez une comparaison gratuite entre les versions gratuites et payantes, accompagnée de tests concrets et de classements mis à jour chaque semaine. Explorez dès maintenant pour découvrir l’outil parfait qui vous permettra de rester à la pointe dans vos tâches liées à l’intelligence artificielle !
9 outils
xix.ai
en écrivant
Meilleurs assistants d’écriture par IA pour les articles longs : élaborez des plans et rédigez plus rapidement
2026 Derniers Meilleurs Assistants d’Écriture par IA pour les Articles Longues : Élaborez et Rédigez plus Rapidement. XIX.AI sélectionne les outils les mieux notés, à essayer absolument, offrant un soutien puissant et transformateur pour améliorer considérablement l’efficacité de l’écriture. Vous trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles, ainsi que des classements mis à jour chaque semaine. Explorez dès maintenant pour Découvrir votre outil idéal et Commencez à créer dès aujourd’hui pour Débloquer votre avantage IA.
8 outils
xix.ai
Éducation et apprentissage
Outils d'étude ChatGPT pour la révision des examens, les fiches de révision et les explications de devoirs
2026 : les meilleurs outils d’étude ChatGPT pour la révision des examens, les fiches de révision et les explications de devoirs ! XIX.AI a sélectionné une liste des meilleurs outils révolutionnaires conçus pour booster votre productivité. Ces solutions incontournables proposent une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à trouver l'option idéale pour une préparation efficace aux examens et une aide aux devoirs. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
10 outils
xix.ai
Éducation et apprentissage
Outils de planification d’études en IA pour la préparation aux examens
Les meilleures outils de planification d’études en IA, hautement notés et mis à jour pour 2026, destinés à la préparation aux examens, sont disponibles sur XIX.AI ! Cette sélection rigoureuse regroupe des outils puissants capables de transformer votre façon d’étudier, vous aidant à simplifier votre processus de révision, à améliorer votre concentration et à établir des horaires d’étude personnalisés. Nous effectuons des tests dans des conditions réelles afin de déterminer les meilleures options, en proposant une comparaison entre versions gratuites et payantes ainsi que des classements mis à jour chaque semaine. Il s’agit de solutions incontournables conçues pour maximiser votre productivité et vous aider à réussir tous vos examens. Découvrez-les dès maintenant pour trouver l’outil idéal pour vous !
14 outils
xix.ai

 commentaires (0)
Alors que l'intelligence artificielle progresse rapidement, DeepSeek V4Flash établit une nouvelle norme pour les moteurs d'inférence locale grâce à ses avantages distinctifs. Conçu spécifiquement pour la plateforme Metal, ce moteur léger offre une expérience d'inférence locale plus rapide et plus adaptable. Plutôt que de servir d'outil polyvalent, DeepSeek V4Flash est optimisé exclusivement pour le modèle DeepSeek V4Flash, garantissant des performances maximales pour son utilisation prévue.
Au-delà de la vitesse brute, DeepSeek V4Flash excelle dans son architecture de raisonnement. Avec moins de paramètres que les modèles comparables, il traite les tâches plus efficacement. En mode raisonnement, il résout des requêtes complexes en un cinquième du temps requis par d'autres modèles, ce qui le rend très efficace pour des scénarios exigeants dans diverses applications.
De plus, DeepSeek V4Flash dispose d'une fenêtre de contexte massive capable de gérer jusqu'à un million de jetons. Cette puissance de traitement étendue lui permet de naviguer sans effort dans des sujets de pointe, qu'il s'agisse de discuter de programmation italienne ou d'affaires politiques, démontrant ainsi une base de connaissances robuste.
En ce qui concerne la compatibilité matérielle, DeepSeek V4Flash prend en charge la quantification 2 bits sur un MacBook doté de 128 Go de RAM, offrant des résultats impressionnants. L'équipe DeepSeek prévoit également de publier une version plus puissante à l'avenir afin d'améliorer davantage l'expérience utilisateur.
Plus qu'un simple moteur d'inférence, DeepSeek V4Flash propose une solution locale complète, incluant une API HTTP et des modèles GGUF spécialement conçus. Cette intégration garantit un service et un support fluides pour les utilisateurs. Cependant, les utilisateurs doivent noter que la version actuelle reste au stade Alpha et nécessite encore des améliorations.
En conclusion, DeepSeek V4Flash s'est imposé comme une option remarquable pour l'inférence locale grâce à sa conception unique et ses capacités puissantes, avec des développements prometteurs à l'horizon.








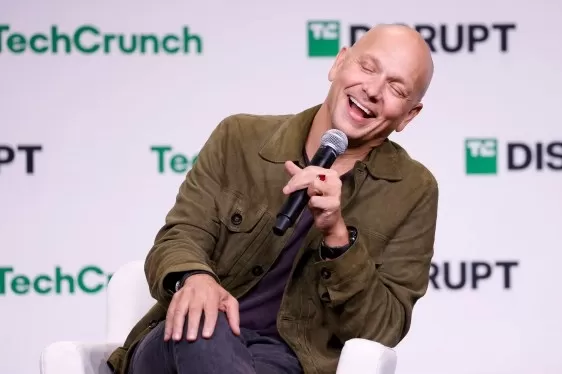 Tony Fadell explique pourquoi la première vague d’appareils intelligents basés sur l’intelligence artificielle a échoué, et ce qui arrive ensuite
Alors que Tony Fadell monte sur la scène du premier MIT Future Fest, il affiche une diapositive présentant trois appareils d’intelligence artificielle (IA) arrêtés et fortement médiatisés : le Rabbit R1, l’épingle IA Humane et le pendentif Limitless.
 La Corée du Sud adopte une loi visant à stimuler le développement de l'IA en autorisant une utilisation limitée des données à caractère personnel après examen réglementaire
Le Comité coréen de protection des données personnelles a récemment annoncé que l’Assemblée nationale avait approuvé à l’unanimité un amendement à la loi sur la protection des données personnelles, au
 Hygon DCU exécute des modèles de plusieurs milliards de paramètres avec la parallélisation d'experts Kimi K3
L'infrastructure informatique nationale a réussi à faire fonctionner pour la première fois un modèle de trillion de paramètres. Hai Guang Information a confirmé l'adaptation complète et la validation des performances de Kimi K3 sur sa plateforme DCU,
Les meilleurs outils de prévision de trésorerie basés sur l'IA pour la gestion financière des petites entreprises en 2026 sont disponibles sur XIX.AI ! Notre sélection regroupe des solutions puissantes et révolutionnaires, testées en conditions réelles, qui aident les chefs de petites entreprises à améliorer la précision de leurs prévisions financières, à planifier plus efficacement leurs budgets et à éviter les problèmes de trésorerie. Consultez notre comparatif entre les versions gratuites et payantes et découvrez dès maintenant l'outil idéal pour une gestion financière fluide.
7 outils
xix.ai
Les meilleurs chatbots d'IA pour le codage en 2026, sélectionnés pour les développeurs ! Découvrez des outils puissants et révolutionnaires qui vous aideront à déboguer rapidement vos problèmes en Python, JS et SQL. Consultez un comparatif entre les versions gratuites et payantes, ainsi que des tests en conditions réelles et des classements détaillés, pour trouver la solution idéale qui boostera votre productivité en programmation. Essayez XIX.AI dès aujourd’hui pour exploiter pleinement le potentiel de l’IA ! Découvrez-le dès maintenant.
12 outils
xix.ai
Les meilleures plateformes de versionnement des invites IA les plus récentes et les mieux notées pour 2026, conçues pour des playbooks réutilisables, sont disponibles sur XIX.AI ! Notre liste soigneusement sélectionnée comprend des outils puissants qui changent la donne, vous aidant à suivre toutes vos invites, à tester efficacement les variations et à améliorer la productivité dans l’écriture, la création de contenu et bien plus encore. Obtenez une comparaison gratuite entre les versions gratuites et payantes, accompagnée de tests concrets et de classements mis à jour chaque semaine. Explorez dès maintenant pour découvrir l’outil parfait qui vous permettra de rester à la pointe dans vos tâches liées à l’intelligence artificielle !
9 outils
xix.ai
2026 Derniers Meilleurs Assistants d’Écriture par IA pour les Articles Longues : Élaborez et Rédigez plus Rapidement. XIX.AI sélectionne les outils les mieux notés, à essayer absolument, offrant un soutien puissant et transformateur pour améliorer considérablement l’efficacité de l’écriture. Vous trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles, ainsi que des classements mis à jour chaque semaine. Explorez dès maintenant pour Découvrir votre outil idéal et Commencez à créer dès aujourd’hui pour Débloquer votre avantage IA.
8 outils
xix.ai
2026 : les meilleurs outils d’étude ChatGPT pour la révision des examens, les fiches de révision et les explications de devoirs ! XIX.AI a sélectionné une liste des meilleurs outils révolutionnaires conçus pour booster votre productivité. Ces solutions incontournables proposent une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à trouver l'option idéale pour une préparation efficace aux examens et une aide aux devoirs. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
10 outils
xix.ai
Les meilleures outils de planification d’études en IA, hautement notés et mis à jour pour 2026, destinés à la préparation aux examens, sont disponibles sur XIX.AI ! Cette sélection rigoureuse regroupe des outils puissants capables de transformer votre façon d’étudier, vous aidant à simplifier votre processus de révision, à améliorer votre concentration et à établir des horaires d’étude personnalisés. Nous effectuons des tests dans des conditions réelles afin de déterminer les meilleures options, en proposant une comparaison entre versions gratuites et payantes ainsi que des classements mis à jour chaque semaine. Il s’agit de solutions incontournables conçues pour maximiser votre productivité et vous aider à réussir tous vos examens. Découvrez-les dès maintenant pour trouver l’outil idéal pour vous !
14 outils
xix.ai












