


 Hogar
DeepSeek V4 Flash: Un motor de inferencia a pequeña escala que rompe con la tradición
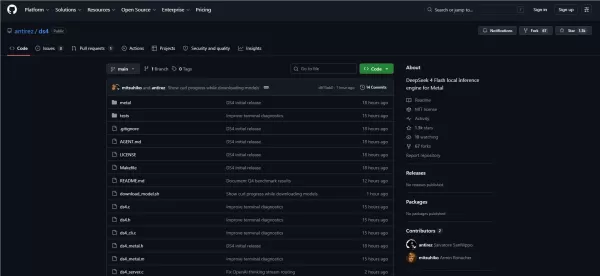
A medida que la inteligencia artificial avanza rápidamente, DeepSeek V4Flash está estableciendo un nuevo estándar para los motores de inferencia local mediante sus ventajas distintivas. Diseñado específicamente para la plataforma Metal, este motor ligero ofrece una experiencia de inferencia local más rápida y adaptable. En lugar de servir como una herramienta de propósito general, DeepSeek V4Flash está optimizado exclusivamente para el modelo DeepSeek V4Flash, garantizando un rendimiento máximo para su uso previsto.
Más allá de la velocidad bruta, DeepSeek V4Flash destaca por su arquitectura de razonamiento. Con menos parámetros que modelos comparables, procesa tareas con mayor eficiencia. En su modo de razonamiento, resuelve consultas complejas en solo una quinta parte del tiempo requerido por otros modelos, lo que lo hace altamente efectivo para escenarios exigentes en diversas aplicaciones.
Además, DeepSeek V4Flash cuenta con una ventana de contexto masiva capaz de manejar hasta un millón de tokens. Este amplio poder de procesamiento le permite navegar sin esfuerzo por temas de vanguardia, ya sea discutiendo programación en italiano o asuntos políticos, mostrando una base de conocimientos sólida.
En cuanto a la compatibilidad con el hardware, DeepSeek V4Flash admite la cuantización de 2 bits en un MacBook con 128 GB de RAM, ofreciendo resultados impresionantes. El equipo de DeepSeek también planea lanzar una versión más potente en el futuro para mejorar aún más la experiencia del usuario.
Más que un simple motor de inferencia, DeepSeek V4Flash ofrece una solución local integral, que incluye una API HTTP y modelos GGUF especialmente diseñados. Esta integración garantiza un servicio y soporte fluidos para los usuarios. Sin embargo, los usuarios deben tener en cuenta que la versión actual sigue en etapa Alpha y requiere más refinamiento.
En conclusión, DeepSeek V4Flash se ha destacado como una opción destacada en la inferencia local gracias a su diseño único y capacidades poderosas, con desarrollos prometedores en el horizonte.
Artículo relacionado
 Tony Fadell explica por qué la primera oleada de gadgets de IA fracasó y qué viene a continuación
Cuando Tony Fadell sube al escenario en el inaugural MIT Future Fest, muestra una diapositiva con tres dispositivos de IA descontinuados y muy promocionados: el Rabbit R1, el pin de IA Humane y el colgante Limitless.«Estos representaron la primera g
Corea del Sur aprueba una ley para impulsar la inteligencia artificial al permitir un uso limitado de los datos personales tras una revisión normativa
El Comité Coreano de Protección de Datos Personales ha anunciado recientemente que la Asamblea Nacional ha aprobado por unanimidad una enmienda a la Ley de Protección de Datos Personales, que permite
Hygon DCU ejecuta modelos de billones de parámetros con paralelismo experto de Kimi K3
La infraestructura informática nacional ha logrado, por primera vez, ejecutar un modelo de billones de parámetros. Hai Guang Information confirmó la adaptación completa de la pila tecnológica y la validación del rendimiento de Kimi K3 en su plataform
Recomendaciones de temas especiales relacionados
Finanzas
 Herramientas de previsión de flujo de caja basadas en IA para las finanzas de las pequeñas empresas
¡Ya están aquí, en XIX.AI, las mejores herramientas de previsión de flujo de caja con IA para la gestión financiera de pequeñas empresas de 2026! Nuestra lista seleccionada incluye soluciones potentes y revolucionarias que han superado pruebas en el mundo real para ayudar a los propietarios de pequeñas empresas a mejorar la precisión financiera, planificar presupuestos de forma más eficaz y evitar problemas de flujo de caja. Consulta la comparación entre las versiones gratuitas y de pago y explora ahora mismo la herramienta perfecta para una gestión financiera sin complicaciones.
 7 herramientas
 xix.ai
código
Los mejores chatbots de programación con IA: depura código en Python, JS y SQL en un solo sitio
¡Los mejores chatbots de programación con IA de 2026, seleccionados para desarrolladores! Descubre potentes herramientas revolucionarias que te ayudarán a depurar rápidamente errores en Python, JS y SQL. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas reales y clasificaciones detalladas, para encontrar la opción perfecta que impulse tu productividad a la hora de programar. ¡Prueba XIX.AI hoy mismo para sacar partido a tu ventaja con la IA! Explora ahora.
12 herramientas
xix.ai
Inmediato
Plataformas de versionado de prompts de IA para playbooks reutilizables de Claude y ChatGPT
¡Aquí están las mejores plataformas de versionado de prompts de IA más destacadas y mejor valoradas de 2026 para playbooks reutilizables en XIX.AI! Nuestra lista curada incluye herramientas poderosas que cambian las reglas del juego y te ayudan a llevar un registro de todos los prompts, probar variaciones de manera eficiente y aumentar la productividad en redacción, creación de contenido y más. Obtén una comparación gratuita entre versiones gratuitas y de pago junto con pruebas del mundo real y clasificaciones actualizadas cada semana. ¡Explora ahora para descubrir la herramienta perfecta que te mantendrá a la vanguardia en tareas de IA!
9 herramientas
xix.ai
escribiendo
Mejores asistentes de escritura con IA para artículos largos: Esquematiza y redacta más rápido
2026 Últimas Mejores Asistentes de Escritura con IA para Artículos Largos: Esquema y Borrador Más Rápido. XIX.AI selecciona las herramientas mejor valoradas y obligatorias de probar que ofrecen un apoyo poderoso y transformador para aumentar significativamente la eficiencia de escritura. Encontrarás una comparación detallada entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Explora ahora para Descubrir tu herramienta perfecta y Comienza a crear hoy para Desbloquear tu ventaja con IA.
8 herramientas
xix.ai
Educación y aprendizaje
Herramientas de estudio de ChatGPT para la preparación de exámenes, fichas de repaso y explicaciones de los deberes
¡Las mejores herramientas de estudio de ChatGPT de 2026 para repasar exámenes, fichas de estudio y explicaciones de deberes! XIX.AI ha elaborado una lista de las herramientas mejor valoradas, potentes y revolucionarias, diseñadas para aumentar tu productividad. Estas soluciones, que no te puedes perder, ofrecen comparativas entre versiones gratuitas y de pago, pruebas en situaciones reales y clasificaciones detalladas para ayudarte a encontrar la opción perfecta para una preparación eficiente de los exámenes y ayuda con los deberes. ¡Explóralas ahora para sacar el máximo partido a la IA!
10 herramientas
xix.ai
Educación y aprendizaje
Herramientas de planificador de estudios con IA para la preparación de exámenes
¡Los mejores y más recientes planificadores de estudio con inteligencia artificial, altamente calificados, para la preparación de exámenes en 2026, están disponibles aquí en XIX.AI! Esta selección cuidadosamente elaborada incluye herramientas potentes que transforman completamente el proceso de estudio, ayudándolo a simplificar su revisión, mejorar su concentración y crear horarios de estudio personalizados. Realizamos pruebas en condiciones reales para determinar las mejores opciones, ofreciendo una comparación entre versiones gratuitas y de pago, además de clasificaciones actualizadas semanalmente. Son soluciones que debe probar para maximizar su productividad y ayudarlo a superar con éxito cada examen. ¡Explórelas ahora para encontrar la herramienta perfecta para usted!
14 herramientas
xix.ai

 comentario (0)
0/500
A medida que la inteligencia artificial avanza rápidamente, DeepSeek V4Flash está estableciendo un nuevo estándar para los motores de inferencia local mediante sus ventajas distintivas. Diseñado específicamente para la plataforma Metal, este motor ligero ofrece una experiencia de inferencia local más rápida y adaptable. En lugar de servir como una herramienta de propósito general, DeepSeek V4Flash está optimizado exclusivamente para el modelo DeepSeek V4Flash, garantizando un rendimiento máximo para su uso previsto.
Más allá de la velocidad bruta, DeepSeek V4Flash destaca por su arquitectura de razonamiento. Con menos parámetros que modelos comparables, procesa tareas con mayor eficiencia. En su modo de razonamiento, resuelve consultas complejas en solo una quinta parte del tiempo requerido por otros modelos, lo que lo hace altamente efectivo para escenarios exigentes en diversas aplicaciones.
Además, DeepSeek V4Flash cuenta con una ventana de contexto masiva capaz de manejar hasta un millón de tokens. Este amplio poder de procesamiento le permite navegar sin esfuerzo por temas de vanguardia, ya sea discutiendo programación en italiano o asuntos políticos, mostrando una base de conocimientos sólida.
En cuanto a la compatibilidad con el hardware, DeepSeek V4Flash admite la cuantización de 2 bits en un MacBook con 128 GB de RAM, ofreciendo resultados impresionantes. El equipo de DeepSeek también planea lanzar una versión más potente en el futuro para mejorar aún más la experiencia del usuario.
Más que un simple motor de inferencia, DeepSeek V4Flash ofrece una solución local integral, que incluye una API HTTP y modelos GGUF especialmente diseñados. Esta integración garantiza un servicio y soporte fluidos para los usuarios. Sin embargo, los usuarios deben tener en cuenta que la versión actual sigue en etapa Alpha y requiere más refinamiento.
En conclusión, DeepSeek V4Flash se ha destacado como una opción destacada en la inferencia local gracias a su diseño único y capacidades poderosas, con desarrollos prometedores en el horizonte.








 Tony Fadell explica por qué la primera oleada de gadgets de IA fracasó y qué viene a continuación
Cuando Tony Fadell sube al escenario en el inaugural MIT Future Fest, muestra una diapositiva con tres dispositivos de IA descontinuados y muy promocionados: el Rabbit R1, el pin de IA Humane y el colgante Limitless.«Estos representaron la primera g
 Corea del Sur aprueba una ley para impulsar la inteligencia artificial al permitir un uso limitado de los datos personales tras una revisión normativa
El Comité Coreano de Protección de Datos Personales ha anunciado recientemente que la Asamblea Nacional ha aprobado por unanimidad una enmienda a la Ley de Protección de Datos Personales, que permite
 Hygon DCU ejecuta modelos de billones de parámetros con paralelismo experto de Kimi K3
La infraestructura informática nacional ha logrado, por primera vez, ejecutar un modelo de billones de parámetros. Hai Guang Information confirmó la adaptación completa de la pila tecnológica y la validación del rendimiento de Kimi K3 en su plataform
¡Ya están aquí, en XIX.AI, las mejores herramientas de previsión de flujo de caja con IA para la gestión financiera de pequeñas empresas de 2026! Nuestra lista seleccionada incluye soluciones potentes y revolucionarias que han superado pruebas en el mundo real para ayudar a los propietarios de pequeñas empresas a mejorar la precisión financiera, planificar presupuestos de forma más eficaz y evitar problemas de flujo de caja. Consulta la comparación entre las versiones gratuitas y de pago y explora ahora mismo la herramienta perfecta para una gestión financiera sin complicaciones.
7 herramientas
xix.ai
¡Los mejores chatbots de programación con IA de 2026, seleccionados para desarrolladores! Descubre potentes herramientas revolucionarias que te ayudarán a depurar rápidamente errores en Python, JS y SQL. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas reales y clasificaciones detalladas, para encontrar la opción perfecta que impulse tu productividad a la hora de programar. ¡Prueba XIX.AI hoy mismo para sacar partido a tu ventaja con la IA! Explora ahora.
12 herramientas
xix.ai
¡Aquí están las mejores plataformas de versionado de prompts de IA más destacadas y mejor valoradas de 2026 para playbooks reutilizables en XIX.AI! Nuestra lista curada incluye herramientas poderosas que cambian las reglas del juego y te ayudan a llevar un registro de todos los prompts, probar variaciones de manera eficiente y aumentar la productividad en redacción, creación de contenido y más. Obtén una comparación gratuita entre versiones gratuitas y de pago junto con pruebas del mundo real y clasificaciones actualizadas cada semana. ¡Explora ahora para descubrir la herramienta perfecta que te mantendrá a la vanguardia en tareas de IA!
9 herramientas
xix.ai
2026 Últimas Mejores Asistentes de Escritura con IA para Artículos Largos: Esquema y Borrador Más Rápido. XIX.AI selecciona las herramientas mejor valoradas y obligatorias de probar que ofrecen un apoyo poderoso y transformador para aumentar significativamente la eficiencia de escritura. Encontrarás una comparación detallada entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Explora ahora para Descubrir tu herramienta perfecta y Comienza a crear hoy para Desbloquear tu ventaja con IA.
8 herramientas
xix.ai
¡Las mejores herramientas de estudio de ChatGPT de 2026 para repasar exámenes, fichas de estudio y explicaciones de deberes! XIX.AI ha elaborado una lista de las herramientas mejor valoradas, potentes y revolucionarias, diseñadas para aumentar tu productividad. Estas soluciones, que no te puedes perder, ofrecen comparativas entre versiones gratuitas y de pago, pruebas en situaciones reales y clasificaciones detalladas para ayudarte a encontrar la opción perfecta para una preparación eficiente de los exámenes y ayuda con los deberes. ¡Explóralas ahora para sacar el máximo partido a la IA!
10 herramientas
xix.ai
¡Los mejores y más recientes planificadores de estudio con inteligencia artificial, altamente calificados, para la preparación de exámenes en 2026, están disponibles aquí en XIX.AI! Esta selección cuidadosamente elaborada incluye herramientas potentes que transforman completamente el proceso de estudio, ayudándolo a simplificar su revisión, mejorar su concentración y crear horarios de estudio personalizados. Realizamos pruebas en condiciones reales para determinar las mejores opciones, ofreciendo una comparación entre versiones gratuitas y de pago, además de clasificaciones actualizadas semanalmente. Son soluciones que debe probar para maximizar su productividad y ayudarlo a superar con éxito cada examen. ¡Explórelas ahora para encontrar la herramienta perfecta para usted!
14 herramientas
xix.ai












