


 Heim
DeepSeek V4 Flash: Eine kleine Inferenz-Engine, die Traditionen durchbricht
Während die künstliche Intelligenz rasante Fortschritte macht, setzt DeepSeek V4Flash durch seine einzigartigen Vorteile einen neuen Standard für lokale Inferenz-Engines. Diese speziell für die Metal-Plattform entwickelte, leichte Engine bietet ein schnelleres und anpassungsfähigeres lokales Inferenzerlebnis. Anstatt als Allzweckwerkzeug zu dienen, ist DeepSeek V4Flash ausschließlich für das DeepSeek V4Flash-Modell optimiert, um die Höchstleistung für den vorgesehenen Einsatz zu gewährleisten.
Neben der reinen Geschwindigkeit überzeugt DeepSeek V4Flash durch seine Reasoning-Architektur. Mit weniger Parametern als vergleichbare Modelle verarbeitet es Aufgaben effizienter. Im Reasoning-Modus löst es komplexe Anfragen in nur einem Fünftel der Zeit, die andere Modelle benötigen, was es für anspruchsvolle Szenarien in verschiedenen Anwendungsbereichen äußerst effektiv macht.
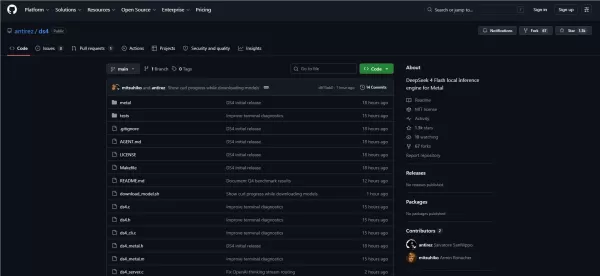
Darüber hinaus verfügt DeepSeek V4Flash über ein massives Kontextfenster, das bis zu eine Million Token verarbeiten kann. Diese umfassende Verarbeitungskraft ermöglicht es ihm, mühelos aktuelle Themen zu bewältigen, sei es bei der Diskussion über italienische Programmierung oder politische Angelegenheiten, und zeigt so eine robuste Wissensbasis auf.
Hinsichtlich der Hardware-Kompatibilität unterstützt DeepSeek V4Flash die 2-Bit-Quantisierung auf einem MacBook mit 128 GB RAM und liefert beeindruckende Ergebnisse. Das DeepSeek-Team plant zudem, in Zukunft eine leistungsfähigere Version herauszubringen, um die Benutzererfahrung weiter zu verbessern.
Mehr als nur eine Inferenz-Engine bietet DeepSeek V4Flash eine umfassende lokale Lösung, einschließlich einer HTTP-API und speziell entwickelter GGUF-Modelle. Diese Integration gewährleistet einen nahtlosen Service und Support für die Benutzer. Nutzer sollten jedoch beachten, dass die aktuelle Version noch im Alpha-Stadium ist und weiterer Verfeinerung bedarf.
Zusammenfassend lässt sich sagen, dass DeepSeek V4Flash dank seines einzigartigen Designs und seiner leistungsstarken Fähigkeiten als herausragende Option für lokale Inferenz hervorgetreten ist, wobei vielversprechende Entwicklungen in der Zukunft zu erwarten sind.
Verwandter Artikel
 Tony Fadell darüber, warum die erste Welle der KI-Gadgets scheiterte – und was als Nächstes kommt
Als Tony Fadell die Bühne beim ersten MIT Future Fest betritt, zeigt er eine Folie mit drei eingestellten, stark beworbenen KI-Geräten: dem Rabbit R1, dem Humane AI Pin und dem Limitless Pendant.„Diese repräsentierten die erste Generation von KI-Pro
Südkorea verabschiedet Gesetz zur Förderung der KI, das nach einer behördlichen Prüfung die begrenzte Nutzung personenbezogener Daten erlaubt
Der koreanische Ausschuss für den Schutz personenbezogener Daten gab kürzlich bekannt, dass die Nationalversammlung einstimmig eine Novelle des Gesetzes zum Schutz personenbezogener Daten verabschiede
Hygon DCU führt Trillion-Parameter-Modelle mit Kimi K3 Expert Parallelism aus
Die inländische Recheninfrastruktur hat erfolgreich ein Modell mit einer Billion Parametern zum ersten Mal betrieben. Hai Guang Information bestätigte die vollumfängliche Anpassung und Leistungsvalidierung von Kimi K3 auf seiner DCU-Plattform und zei
Empfehlungen zu verwandten Spezialthemen
Finanzen
 KI-Tools zur Cashflow-Prognose für die Finanzplanung kleiner Unternehmen
Die neuesten, besten und am besten bewerteten KI-Tools zur Cashflow-Prognose für die Finanzen kleiner Unternehmen im Jahr 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in der Praxis getestet wurden, um Inhabern kleiner Unternehmen dabei zu helfen, die Genauigkeit ihrer Finanzdaten zu verbessern, Budgets effektiver zu planen und Cashflow-Probleme zu vermeiden. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten an und entdecken Sie jetzt das perfekte Tool für ein reibungsloses Finanzmanagement.
 7 Tools
 xix.ai
Code
Die besten KI-Chatbots zum Programmieren: Python, JS und SQL an einem Ort debuggen
Die besten und am besten bewerteten KI-Programmier-Chatbots des Jahres 2026 – speziell für Entwickler zusammengestellt! Erleben Sie leistungsstarke, bahnbrechende Tools, mit denen Sie Probleme in Python, JS und SQL schnell beheben können. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, um die perfekte Lösung zur Steigerung Ihrer Programmierproduktivität zu finden. Probieren Sie XIX.AI noch heute aus und nutzen Sie Ihren KI-Vorteil! Jetzt entdecken.
12 Tools
xix.ai
Prompt
Plattformen zur Versionsverwaltung von KI-Prompts für wiederverwendbare Claude- und ChatGPT-Spielpläne
2026 Neueste Besten Top-bewerteten KI-Prompt-Versionierungsplattformen für wiederverwendbare Spielpläne sind hier auf XIX.AI! Unsere kuratierte Liste umfasst leistungsstarke, spielverändernde Tools, die Ihnen helfen, alle Prompts im Auge zu behalten, Variationen effizient zu testen und die Produktivität beim Schreiben, Content-Erstellung und mehr zu steigern. Erhalten Sie einen kostenlosen vs. kostenpflichtigen Vergleich sowie echte Tests und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt Ihr perfektes Tool, um bei KI-Aufgaben immer einen Schritt voraus zu sein!
9 Tools
xix.ai
Schreiben
Die besten KI-Schreibassistenten für lange Artikel: Gliederung und Entwurf schneller erstellen
2026 Neueste Beste KI-Schreibassistenten für lange Artikel: Gliederung und Entwurf schneller erstellen. XIX.AI kuratiert die am besten bewerteten, unbedingt auszuprobierenden Tools, die leistungsstarke, bahnbrechende Unterstützung bieten, um die Schreibeffizienz erheblich zu steigern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt Ihr perfektes Tool und beginnen Sie noch heute mit dem Erstellen, um Ihren KI-Vorteil zu nutzen.
8 Tools
xix.ai
Bildung und Lernen
ChatGPT-Lernhilfen für die Prüfungsvorbereitung, Lernkarten und Erklärungen zu Hausaufgaben
2026: Die besten ChatGPT-Lernhilfen für Prüfungsvorbereitung, Lernkarten und Hausaufgaben-Erklärungen! XIX.AI hat eine Liste der besten, bahnbrechenden Tools zusammengestellt, die Ihre Produktivität steigern sollen. Diese Lösungen, die Sie unbedingt ausprobieren sollten, bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und detaillierte Rankings, damit Sie die perfekte Option für eine effiziente Prüfungsvorbereitung und Hausaufgabenhilfe finden. Entdecken Sie sie jetzt und nutzen Sie den Vorteil der KI!
10 Tools
xix.ai
Bildung und Lernen
Tools zum Planen von AI-Studien für die Prüfungsvorbereitung
Die neuesten, besten und am höchsten bewerteten AI-basierten Lernplaner für die Prüfungsvorbereitung im Jahr 2026 sind jetzt auf XIX.AI verfügbar! Diese sorgfältig ausgewählte Sammlung umfasst leistungsstarke Tools, die Ihrem Lernprozess mehr Struktur verleihen, Ihre Konzentration steigern und individuelle Lernpläne erstellen helfen. Wir führen praktische Tests durch, um die besten Optionen auszuwählen, und bieten sowohl einen Vergleich zwischen kostenloser und kostenpflichtiger Variante als auch wöchentlich aktualisierte Ranglisten an. Es handelt sich dabei um Lösungen, die Sie unbedingt ausprobieren sollten, um Ihre Produktivität zu maximieren und bei jeder Prüfung erfolgreich abzuschneiden. Entdecken Sie jetzt die perfekten Tools für Sie!
14 Tools
xix.ai

 Kommentare (0)
Während die künstliche Intelligenz rasante Fortschritte macht, setzt DeepSeek V4Flash durch seine einzigartigen Vorteile einen neuen Standard für lokale Inferenz-Engines. Diese speziell für die Metal-Plattform entwickelte, leichte Engine bietet ein schnelleres und anpassungsfähigeres lokales Inferenzerlebnis. Anstatt als Allzweckwerkzeug zu dienen, ist DeepSeek V4Flash ausschließlich für das DeepSeek V4Flash-Modell optimiert, um die Höchstleistung für den vorgesehenen Einsatz zu gewährleisten.
Neben der reinen Geschwindigkeit überzeugt DeepSeek V4Flash durch seine Reasoning-Architektur. Mit weniger Parametern als vergleichbare Modelle verarbeitet es Aufgaben effizienter. Im Reasoning-Modus löst es komplexe Anfragen in nur einem Fünftel der Zeit, die andere Modelle benötigen, was es für anspruchsvolle Szenarien in verschiedenen Anwendungsbereichen äußerst effektiv macht.
Darüber hinaus verfügt DeepSeek V4Flash über ein massives Kontextfenster, das bis zu eine Million Token verarbeiten kann. Diese umfassende Verarbeitungskraft ermöglicht es ihm, mühelos aktuelle Themen zu bewältigen, sei es bei der Diskussion über italienische Programmierung oder politische Angelegenheiten, und zeigt so eine robuste Wissensbasis auf.
Hinsichtlich der Hardware-Kompatibilität unterstützt DeepSeek V4Flash die 2-Bit-Quantisierung auf einem MacBook mit 128 GB RAM und liefert beeindruckende Ergebnisse. Das DeepSeek-Team plant zudem, in Zukunft eine leistungsfähigere Version herauszubringen, um die Benutzererfahrung weiter zu verbessern.
Mehr als nur eine Inferenz-Engine bietet DeepSeek V4Flash eine umfassende lokale Lösung, einschließlich einer HTTP-API und speziell entwickelter GGUF-Modelle. Diese Integration gewährleistet einen nahtlosen Service und Support für die Benutzer. Nutzer sollten jedoch beachten, dass die aktuelle Version noch im Alpha-Stadium ist und weiterer Verfeinerung bedarf.
Zusammenfassend lässt sich sagen, dass DeepSeek V4Flash dank seines einzigartigen Designs und seiner leistungsstarken Fähigkeiten als herausragende Option für lokale Inferenz hervorgetreten ist, wobei vielversprechende Entwicklungen in der Zukunft zu erwarten sind.








 Tony Fadell darüber, warum die erste Welle der KI-Gadgets scheiterte – und was als Nächstes kommt
Als Tony Fadell die Bühne beim ersten MIT Future Fest betritt, zeigt er eine Folie mit drei eingestellten, stark beworbenen KI-Geräten: dem Rabbit R1, dem Humane AI Pin und dem Limitless Pendant.„Diese repräsentierten die erste Generation von KI-Pro
 Südkorea verabschiedet Gesetz zur Förderung der KI, das nach einer behördlichen Prüfung die begrenzte Nutzung personenbezogener Daten erlaubt
Der koreanische Ausschuss für den Schutz personenbezogener Daten gab kürzlich bekannt, dass die Nationalversammlung einstimmig eine Novelle des Gesetzes zum Schutz personenbezogener Daten verabschiede
 Hygon DCU führt Trillion-Parameter-Modelle mit Kimi K3 Expert Parallelism aus
Die inländische Recheninfrastruktur hat erfolgreich ein Modell mit einer Billion Parametern zum ersten Mal betrieben. Hai Guang Information bestätigte die vollumfängliche Anpassung und Leistungsvalidierung von Kimi K3 auf seiner DCU-Plattform und zei
Die neuesten, besten und am besten bewerteten KI-Tools zur Cashflow-Prognose für die Finanzen kleiner Unternehmen im Jahr 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in der Praxis getestet wurden, um Inhabern kleiner Unternehmen dabei zu helfen, die Genauigkeit ihrer Finanzdaten zu verbessern, Budgets effektiver zu planen und Cashflow-Probleme zu vermeiden. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten an und entdecken Sie jetzt das perfekte Tool für ein reibungsloses Finanzmanagement.
7 Tools
xix.ai
Die besten und am besten bewerteten KI-Programmier-Chatbots des Jahres 2026 – speziell für Entwickler zusammengestellt! Erleben Sie leistungsstarke, bahnbrechende Tools, mit denen Sie Probleme in Python, JS und SQL schnell beheben können. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, um die perfekte Lösung zur Steigerung Ihrer Programmierproduktivität zu finden. Probieren Sie XIX.AI noch heute aus und nutzen Sie Ihren KI-Vorteil! Jetzt entdecken.
12 Tools
xix.ai
2026 Neueste Besten Top-bewerteten KI-Prompt-Versionierungsplattformen für wiederverwendbare Spielpläne sind hier auf XIX.AI! Unsere kuratierte Liste umfasst leistungsstarke, spielverändernde Tools, die Ihnen helfen, alle Prompts im Auge zu behalten, Variationen effizient zu testen und die Produktivität beim Schreiben, Content-Erstellung und mehr zu steigern. Erhalten Sie einen kostenlosen vs. kostenpflichtigen Vergleich sowie echte Tests und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt Ihr perfektes Tool, um bei KI-Aufgaben immer einen Schritt voraus zu sein!
9 Tools
xix.ai
2026 Neueste Beste KI-Schreibassistenten für lange Artikel: Gliederung und Entwurf schneller erstellen. XIX.AI kuratiert die am besten bewerteten, unbedingt auszuprobierenden Tools, die leistungsstarke, bahnbrechende Unterstützung bieten, um die Schreibeffizienz erheblich zu steigern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings. Entdecken Sie jetzt Ihr perfektes Tool und beginnen Sie noch heute mit dem Erstellen, um Ihren KI-Vorteil zu nutzen.
8 Tools
xix.ai
2026: Die besten ChatGPT-Lernhilfen für Prüfungsvorbereitung, Lernkarten und Hausaufgaben-Erklärungen! XIX.AI hat eine Liste der besten, bahnbrechenden Tools zusammengestellt, die Ihre Produktivität steigern sollen. Diese Lösungen, die Sie unbedingt ausprobieren sollten, bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und detaillierte Rankings, damit Sie die perfekte Option für eine effiziente Prüfungsvorbereitung und Hausaufgabenhilfe finden. Entdecken Sie sie jetzt und nutzen Sie den Vorteil der KI!
10 Tools
xix.ai
Die neuesten, besten und am höchsten bewerteten AI-basierten Lernplaner für die Prüfungsvorbereitung im Jahr 2026 sind jetzt auf XIX.AI verfügbar! Diese sorgfältig ausgewählte Sammlung umfasst leistungsstarke Tools, die Ihrem Lernprozess mehr Struktur verleihen, Ihre Konzentration steigern und individuelle Lernpläne erstellen helfen. Wir führen praktische Tests durch, um die besten Optionen auszuwählen, und bieten sowohl einen Vergleich zwischen kostenloser und kostenpflichtiger Variante als auch wöchentlich aktualisierte Ranglisten an. Es handelt sich dabei um Lösungen, die Sie unbedingt ausprobieren sollten, um Ihre Produktivität zu maximieren und bei jeder Prüfung erfolgreich abzuschneiden. Entdecken Sie jetzt die perfekten Tools für Sie!
14 Tools
xix.ai












