


 Lar
Novo benchmark questiona a preparação dos agentes de IA para o ambiente de trabalho
Há quase dois anos, o CEO da Microsoft, Satya Nadella, previu que a IA iria remodelar o trabalho intelectual — o domínio dos advogados, banqueiros de investimento, bibliotecários, contadores, profissionais de TI e funções semelhantes de colarinho branco.
No entanto, apesar dos avanços significativos nos modelos básicos, a transformação no trabalho intelectual tem demorado a se concretizar. Embora os modelos sejam excelentes em pesquisas aprofundadas e planejamento agênico, a maioria das profissões de colarinho branco tem sofrido relativamente poucas mudanças, por razões que ainda não estão claras.
Isso é um dos grandes enigmas da IA. Uma nova pesquisa da Mercor, líder em dados de treinamento, agora está fornecendo insights cruciais.
O estudo avalia como os principais modelos de IA lidam com tarefas genuínas de colarinho branco, como consultoria, banco de investimento e direito. Isso levou à criação do benchmark APEX-Agents — e, atualmente, todos os laboratórios de IA estão falhando. Quando apresentados a consultas de profissionais reais, mesmo os melhores modelos responderam corretamente a menos de um quarto delas. Na maioria das vezes, eles retornaram uma resposta incorreta ou nenhuma resposta.
De acordo com o CEO da Mercor, Brendan Foody, que contribuiu para a pesquisa, a principal fraqueza dos modelos era sintetizar informações em vários domínios — um componente essencial do trabalho de conhecimento humano.
“Uma inovação importante neste benchmark é que construímos um ambiente completo modelado em serviços profissionais reais”, explicou Foody ao TechCrunch. “Nosso trabalho não envolve uma única pessoa nos fornecendo todo o contexto em um único lugar. Na realidade, você opera no Slack, no Google Drive e em várias outras ferramentas.” Para muitos modelos de IA agênica, esse tipo de raciocínio entre domínios permanece inconsistente.
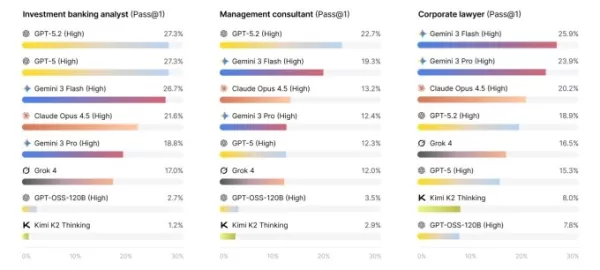
Captura de tela Os cenários de teste foram obtidos de profissionais reais no mercado especializado da Mercor, que projetaram as consultas e definiram os critérios para uma resposta bem-sucedida. A análise das perguntas disponíveis publicamente no Hugging Face revela a complexidade dessas tarefas.
Evento Techcrunch Ingressos para o Disrupt 2026: oferta única
Os ingressos já estão disponíveis! Economize até US$ 680 durante esta oferta por tempo limitado e esteja entre os primeiros 500 inscritos para receber 50% de desconto em um passe +1. O TechCrunch Disrupt reúne os principais líderes do Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face e muito mais para mais de 250 sessões destinadas a impulsionar o crescimento e aprimorar sua vantagem competitiva. Conecte-se com centenas de startups inovadoras e participe de um networking selecionado que gera negócios, insights e inspiração.
Ingressos para o Disrupt 2026: oferta única
Os ingressos já estão disponíveis! Economize até US$ 680 durante esta oferta por tempo limitado e esteja entre os primeiros 500 inscritos para receber 50% de desconto em um passe +1. O TechCrunch Disrupt reúne os principais líderes do Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face e muito mais para mais de 250 sessões destinadas a impulsionar o crescimento e aprimorar sua vantagem competitiva. Conecte-se com centenas de startups inovadoras e participe de um networking selecionado que gera negócios, insights e inspiração.
São Francisco | 13 a 15 de outubro de 2026 INSCRIVA-SE AGORA Um exemplo da seção “Lei” pergunta:
Durante os primeiros 48 minutos de uma interrupção na produção da UE, a equipe de engenharia da Northstar exportou um ou dois conjuntos agrupados de logs de eventos de produção da UE contendo dados pessoais para um fornecedor de análise dos EUA... De acordo com as próprias políticas da Northstar, ela pode razoavelmente tratar essas uma ou duas exportações de logs como estando em conformidade com o Artigo 49?
A resposta correta é sim, mas chegar a ela requer uma análise detalhada das políticas internas da empresa e dos regulamentos de privacidade relevantes da UE.
Tal questão poderia desafiar até mesmo um humano experiente, mas os pesquisadores tiveram como objetivo simular o trabalho profissional real. Um LLM capaz de responder com confiabilidade a essas consultas poderia substituir muitos advogados atuantes. “Este é sem dúvida o tema econômico mais significativo da atualidade”, disse Foody ao TechCrunch. “O benchmark reflete com precisão o trabalho real que esses profissionais realizam.”
A OpenAI já havia tentado avaliar as habilidades profissionais com seu benchmark GDPval, mas o teste APEX-Agents difere significativamente. Enquanto o GDPval avalia conhecimentos gerais amplos em muitas áreas, o APEX-Agents mede a capacidade de um sistema de executar tarefas sustentadas em algumas profissões de alto valor. Isso torna o teste mais desafiador para os modelos e mais diretamente relevante para o potencial de automação do trabalho.
Embora nenhum modelo esteja pronto para assumir o papel de banqueiro de investimentos, alguns claramente chegaram mais perto do que outros. O Gemini 3 Flash liderou o grupo com 24% de precisão em uma única tentativa, seguido de perto pelo GPT-5.2 com 23%. O Opus 4.5, o Gemini 3 Pro e o GPT-5 obtiveram pontuações em torno de 18%.
Embora esses resultados iniciais sejam decepcionantes, o campo da IA tem um histórico de superar rapidamente benchmarks difíceis. Com o teste APEX-Agents agora público, ele representa um desafio aberto para os laboratórios de IA confiantes de que podem melhorar — um resultado que Foody antecipa totalmente nos próximos meses.
“O ritmo de melhoria é notavelmente rápido”, disse ele ao TechCrunch. “Atualmente, é justo comparar a tecnologia a um estagiário que acerta um quarto das vezes, mas no ano passado era um estagiário que acertava 5 ou 10% das vezes. Essa taxa de progresso ano a ano pode criar um impacto substancial muito rapidamente.”
Artigo relacionado
 A Besxar constrói fábrica de semicondutores orbital com foguetes da SpaceX
Atualmente, a fabricação no espaço e o retorno de produtos à Terra dependem de um conjunto restrito de abordagens: aguardar o acesso à Estação Espacial Internacional ou estabelecer parcerias com start
Liang Wenfeng sobre o código aberto: 6x lucros sem horas extras, ganhos 100x vinculados ao código aberto
Após um recente vazamento de discussões internas da bolsa de investidores da DeepSeek, o fundador Liang Wenfeng esclareceu o raciocínio estratégico por trás de sua abordagem de código aberto. Ele afirmou categoricamente: “Nós definitivamente faremos
Como corrigir problemas comuns de drenagem de bateria no Android?
O seu smartphone continua a falhar. Os ecrãs racham sem aviso prévio. A duração da bateria desaparece durante a noite. A carga deixa de funcionar completamente. O áudio corta inesperadamente. Os custos de reparação acumulam-se rapidamente. As reparaç
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
Há quase dois anos, o CEO da Microsoft, Satya Nadella, previu que a IA iria remodelar o trabalho intelectual — o domínio dos advogados, banqueiros de investimento, bibliotecários, contadores, profissionais de TI e funções semelhantes de colarinho branco.
No entanto, apesar dos avanços significativos nos modelos básicos, a transformação no trabalho intelectual tem demorado a se concretizar. Embora os modelos sejam excelentes em pesquisas aprofundadas e planejamento agênico, a maioria das profissões de colarinho branco tem sofrido relativamente poucas mudanças, por razões que ainda não estão claras.
Isso é um dos grandes enigmas da IA. Uma nova pesquisa da Mercor, líder em dados de treinamento, agora está fornecendo insights cruciais.
O estudo avalia como os principais modelos de IA lidam com tarefas genuínas de colarinho branco, como consultoria, banco de investimento e direito. Isso levou à criação do benchmark APEX-Agents — e, atualmente, todos os laboratórios de IA estão falhando. Quando apresentados a consultas de profissionais reais, mesmo os melhores modelos responderam corretamente a menos de um quarto delas. Na maioria das vezes, eles retornaram uma resposta incorreta ou nenhuma resposta.
De acordo com o CEO da Mercor, Brendan Foody, que contribuiu para a pesquisa, a principal fraqueza dos modelos era sintetizar informações em vários domínios — um componente essencial do trabalho de conhecimento humano.
“Uma inovação importante neste benchmark é que construímos um ambiente completo modelado em serviços profissionais reais”, explicou Foody ao TechCrunch. “Nosso trabalho não envolve uma única pessoa nos fornecendo todo o contexto em um único lugar. Na realidade, você opera no Slack, no Google Drive e em várias outras ferramentas.” Para muitos modelos de IA agênica, esse tipo de raciocínio entre domínios permanece inconsistente.
Os cenários de teste foram obtidos de profissionais reais no mercado especializado da Mercor, que projetaram as consultas e definiram os critérios para uma resposta bem-sucedida. A análise das perguntas disponíveis publicamente no Hugging Face revela a complexidade dessas tarefas.
Evento TechcrunchIngressos para o Disrupt 2026: oferta única
Os ingressos já estão disponíveis! Economize até US$ 680 durante esta oferta por tempo limitado e esteja entre os primeiros 500 inscritos para receber 50% de desconto em um passe +1. O TechCrunch Disrupt reúne os principais líderes do Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face e muito mais para mais de 250 sessões destinadas a impulsionar o crescimento e aprimorar sua vantagem competitiva. Conecte-se com centenas de startups inovadoras e participe de um networking selecionado que gera negócios, insights e inspiração.
Ingressos para o Disrupt 2026: oferta única
Os ingressos já estão disponíveis! Economize até US$ 680 durante esta oferta por tempo limitado e esteja entre os primeiros 500 inscritos para receber 50% de desconto em um passe +1. O TechCrunch Disrupt reúne os principais líderes do Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face e muito mais para mais de 250 sessões destinadas a impulsionar o crescimento e aprimorar sua vantagem competitiva. Conecte-se com centenas de startups inovadoras e participe de um networking selecionado que gera negócios, insights e inspiração.
São Francisco | 13 a 15 de outubro de 2026 INSCRIVA-SE AGORAUm exemplo da seção “Lei” pergunta:
Durante os primeiros 48 minutos de uma interrupção na produção da UE, a equipe de engenharia da Northstar exportou um ou dois conjuntos agrupados de logs de eventos de produção da UE contendo dados pessoais para um fornecedor de análise dos EUA... De acordo com as próprias políticas da Northstar, ela pode razoavelmente tratar essas uma ou duas exportações de logs como estando em conformidade com o Artigo 49?
A resposta correta é sim, mas chegar a ela requer uma análise detalhada das políticas internas da empresa e dos regulamentos de privacidade relevantes da UE.
Tal questão poderia desafiar até mesmo um humano experiente, mas os pesquisadores tiveram como objetivo simular o trabalho profissional real. Um LLM capaz de responder com confiabilidade a essas consultas poderia substituir muitos advogados atuantes. “Este é sem dúvida o tema econômico mais significativo da atualidade”, disse Foody ao TechCrunch. “O benchmark reflete com precisão o trabalho real que esses profissionais realizam.”
A OpenAI já havia tentado avaliar as habilidades profissionais com seu benchmark GDPval, mas o teste APEX-Agents difere significativamente. Enquanto o GDPval avalia conhecimentos gerais amplos em muitas áreas, o APEX-Agents mede a capacidade de um sistema de executar tarefas sustentadas em algumas profissões de alto valor. Isso torna o teste mais desafiador para os modelos e mais diretamente relevante para o potencial de automação do trabalho.
Embora nenhum modelo esteja pronto para assumir o papel de banqueiro de investimentos, alguns claramente chegaram mais perto do que outros. O Gemini 3 Flash liderou o grupo com 24% de precisão em uma única tentativa, seguido de perto pelo GPT-5.2 com 23%. O Opus 4.5, o Gemini 3 Pro e o GPT-5 obtiveram pontuações em torno de 18%.
Embora esses resultados iniciais sejam decepcionantes, o campo da IA tem um histórico de superar rapidamente benchmarks difíceis. Com o teste APEX-Agents agora público, ele representa um desafio aberto para os laboratórios de IA confiantes de que podem melhorar — um resultado que Foody antecipa totalmente nos próximos meses.
“O ritmo de melhoria é notavelmente rápido”, disse ele ao TechCrunch. “Atualmente, é justo comparar a tecnologia a um estagiário que acerta um quarto das vezes, mas no ano passado era um estagiário que acertava 5 ou 10% das vezes. Essa taxa de progresso ano a ano pode criar um impacto substancial muito rapidamente.”








 A Besxar constrói fábrica de semicondutores orbital com foguetes da SpaceX
Atualmente, a fabricação no espaço e o retorno de produtos à Terra dependem de um conjunto restrito de abordagens: aguardar o acesso à Estação Espacial Internacional ou estabelecer parcerias com start
 Liang Wenfeng sobre o código aberto: 6x lucros sem horas extras, ganhos 100x vinculados ao código aberto
Após um recente vazamento de discussões internas da bolsa de investidores da DeepSeek, o fundador Liang Wenfeng esclareceu o raciocínio estratégico por trás de sua abordagem de código aberto. Ele afirmou categoricamente: “Nós definitivamente faremos
 Como corrigir problemas comuns de drenagem de bateria no Android?
O seu smartphone continua a falhar. Os ecrãs racham sem aviso prévio. A duração da bateria desaparece durante a noite. A carga deixa de funcionar completamente. O áudio corta inesperadamente. Os custos de reparação acumulam-se rapidamente. As reparaç

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












