


 Heim
Neue Benchmark-Fragen zur Einsatzbereitschaft von KI-Agenten am Arbeitsplatz
Vor fast zwei Jahren prognostizierte Satya Nadella, CEO von Microsoft, dass KI die Wissensarbeit neu gestalten würde – also den Bereich von Anwälten, Investmentbankern, Bibliothekaren, Buchhaltern, IT-Fachleuten und ähnlichen Angestelltenberufen.
Trotz bedeutender Fortschritte bei den Grundmodellen hat sich eine Transformation der Wissensarbeit jedoch nur langsam vollzogen. Während die Modelle sich durch tiefgreifende Forschung und agentenbasierte Planung auszeichnen, haben die meisten Angestelltenberufe aus noch unklaren Gründen relativ wenig Veränderungen erfahren.
Dies ist eines der großen Rätsel der KI. Neue Forschungsergebnisse des führenden Anbieters von Trainingsdaten Mercor liefern nun wichtige Erkenntnisse.
Die Studie bewertet, wie führende KI-Modelle echte Angestelltenaufgaben aus den Bereichen Beratung, Investmentbanking und Recht bewältigen. Dies führte zur Erstellung des APEX-Agents-Benchmarks – und derzeit scheitern alle KI-Labore. Bei der Beantwortung von Fragen echter Fachleute konnten selbst die besten Modelle weniger als ein Viertel richtig beantworten. Meistens gaben sie eine falsche Antwort oder gar keine Antwort.
Laut Brendan Foody, CEO von Mercor, der an der Studie mitgewirkt hat, lag die größte Schwäche der Modelle in der Synthese von Informationen aus mehreren Bereichen – einer Kernkomponente der menschlichen Wissensarbeit.
„Eine wichtige Innovation dieses Benchmarks besteht darin, dass wir eine vollständige Umgebung nach dem Vorbild realer professioneller Dienstleistungen geschaffen haben“, erklärte Foody gegenüber TechCrunch. „Bei unserer Arbeit gibt es nicht eine einzige Person, die uns den gesamten Kontext an einem Ort zur Verfügung stellt. In der Realität arbeitet man mit Slack, Google Drive und verschiedenen anderen Tools.“ Bei vielen agentenbasierten KI-Modellen ist diese Art des domänenübergreifenden Denkens nach wie vor inkonsistent.
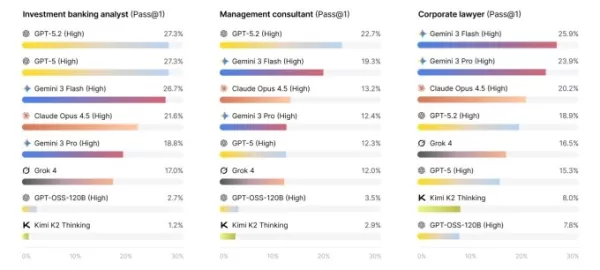
Screenshot Die Testszenarien stammen von tatsächlichen Fachleuten auf dem Expertenmarktplatz von Mercor, die die Fragen entworfen und die Kriterien für eine erfolgreiche Antwort definiert haben. Ein Blick auf die öffentlich zugänglichen Fragen auf Hugging Face zeigt die Komplexität dieser Aufgaben.
Techcrunch-Veranstaltung Disrupt 2026 Tickets: Einmaliges Angebot
Tickets sind jetzt erhältlich! Sparen Sie bis zu 680 $ während dieses zeitlich begrenzten Angebots und gehören Sie zu den ersten 500 Anmeldern, die 50 % Rabatt auf einen +1-Pass erhalten. TechCrunch Disrupt versammelt führende Persönlichkeiten von Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face und anderen für mehr als 250 Sessions, die darauf abzielen, Ihr Wachstum anzukurbeln und Ihren Wettbewerbsvorteil zu schärfen. Treffen Sie Hunderte innovativer Startups und nehmen Sie an einem kuratierten Networking teil, das Geschäfte, Einblicke und Inspiration fördert.
Disrupt 2026-Tickets: Einmaliges Angebot
Tickets sind jetzt erhältlich! Sparen Sie bis zu 680 $ während dieses zeitlich begrenzten Angebots und gehören Sie zu den ersten 500 Anmeldern, die 50 % Rabatt auf einen +1-Pass erhalten. TechCrunch Disrupt versammelt Top-Führungskräfte von Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face und anderen für über 250 Sessions, die darauf abzielen, Wachstum zu fördern und Ihre Wettbewerbsfähigkeit zu steigern. Treffen Sie Hunderte innovativer Startups und nehmen Sie an einem kuratierten Networking teil, das Geschäfte, Einblicke und Inspiration fördert.
San Francisco | 13. bis 15. Oktober 2026 JETZT REGISTRIEREN Ein Beispiel aus dem Abschnitt „Recht” lautet:
Während der ersten 48 Minuten eines Produktionsausfalls in der EU exportierte das Engineering-Team von Northstar ein oder zwei gebündelte Sätze von EU-Produktionsereignisprotokollen, die personenbezogene Daten enthielten, an einen US-amerikanischen Analyseanbieter... Kann Northstar gemäß seinen eigenen Richtlinien diese ein oder zwei Protokollexporte vernünftigerweise als konform mit Artikel 49 behandeln?
Die richtige Antwort lautet „Ja“, aber um zu diesem Ergebnis zu gelangen, ist eine detaillierte Analyse sowohl der internen Richtlinien des Unternehmens als auch der relevanten EU-Datenschutzbestimmungen erforderlich.
Eine solche Frage könnte selbst einen sachkundigen Menschen vor eine Herausforderung stellen, aber die Forscher wollten reale berufliche Arbeit simulieren. Ein LLM, das diese Fragen zuverlässig beantworten kann, könnte möglicherweise viele praktizierende Anwälte ersetzen. „Dies ist wohl das derzeit wichtigste wirtschaftliche Thema“, sagte Foody gegenüber TechCrunch. „Der Benchmark spiegelt genau die tatsächliche Arbeit wider, die diese Fachleute leisten.“
OpenAI hat zuvor versucht, berufliche Fähigkeiten mit seinem GDPval-Benchmark zu messen, aber der APEX-Agents-Test unterscheidet sich erheblich davon. Während GDPval allgemeine Kenntnisse in vielen Bereichen bewertet, misst APEX-Agents die Fähigkeit eines Systems, nachhaltige Aufgaben in einigen ausgewählten hochkarätigen Berufen auszuführen. Dies macht es für Modelle schwieriger und für das Potenzial der Jobautomatisierung relevanter.
Obwohl noch kein Modell bereit ist, als Investmentbanker einzuspringen, kamen einige Modelle anderen deutlich näher als andere. Gemini 3 Flash führte die Gruppe mit einer One-Shot-Genauigkeit von 24 % an, dicht gefolgt von GPT-5.2 mit 23 %. Opus 4.5, Gemini 3 Pro und GPT-5 erzielten alle etwa 18 %.
Auch wenn diese ersten Ergebnisse nicht gerade überwältigend sind, hat der Bereich der KI in der Vergangenheit gezeigt, dass er schwierige Benchmarks schnell überwinden kann. Mit der Veröffentlichung des APEX-Agents-Tests stellt sich nun eine offene Herausforderung für KI-Labore, die von ihrer Fähigkeit zur Verbesserung überzeugt sind – ein Ergebnis, das Foody in den kommenden Monaten voll und ganz erwartet.
„Das Tempo der Verbesserungen ist bemerkenswert schnell“, sagte er gegenüber TechCrunch. „Derzeit kann man die Technologie mit einem Praktikanten vergleichen, der in einem Viertel der Fälle alles richtig macht, aber letztes Jahr war es ein Praktikant, der in 5 oder 10 % der Fälle erfolgreich war. Diese jährliche Fortschrittsrate kann sehr schnell erhebliche Auswirkungen haben.“
Verwandter Artikel
 Wichtige KI-Diskussionen, die die Agenda der AI LIVE London prägen
Der Gipfel bringt Führungskräfte aus der ganzen Welt zusammen, um drängende Herausforderungen in verschiedenen Branchen weltweit zu erörtern – von KI-getriebenen Umbrüchen bis hin zu wirtschaftlicher
Google stellt Veo 3.1 Lite vor, sein günstigstes Videomodell, das die Penny-pro-Sekunde-Videogenerierung vorantreibt
Google hat offiziell die neueste Ergänzung seiner Video-Generierungsserie vorgestellt — Veo3.1Lite — die darauf abzielt, die Erstellung hochwertiger Videos zu demokratisieren, indem die Rechenkosten drastisch gesenkt werden. Dieses Modell hält Google
Xiaoyunque AI stellt Kurzfilm-Agent vor, der auf Seedance 2.0 basiert und die Umwandlung in einen Film mit einem Klick ermöglicht
Am 19. März hat ByteDances all-in-one-KI-Plattform für die Erstellung von Inhalten Little Swallow AI offiziell die Funktion „Short Drama Agent“ vorgestellt. Als der erste intelligente Agent der Branche, der auf dem Seedance-2.0-Algorithmus basiert, a
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Vor fast zwei Jahren prognostizierte Satya Nadella, CEO von Microsoft, dass KI die Wissensarbeit neu gestalten würde – also den Bereich von Anwälten, Investmentbankern, Bibliothekaren, Buchhaltern, IT-Fachleuten und ähnlichen Angestelltenberufen.
Trotz bedeutender Fortschritte bei den Grundmodellen hat sich eine Transformation der Wissensarbeit jedoch nur langsam vollzogen. Während die Modelle sich durch tiefgreifende Forschung und agentenbasierte Planung auszeichnen, haben die meisten Angestelltenberufe aus noch unklaren Gründen relativ wenig Veränderungen erfahren.
Dies ist eines der großen Rätsel der KI. Neue Forschungsergebnisse des führenden Anbieters von Trainingsdaten Mercor liefern nun wichtige Erkenntnisse.
Die Studie bewertet, wie führende KI-Modelle echte Angestelltenaufgaben aus den Bereichen Beratung, Investmentbanking und Recht bewältigen. Dies führte zur Erstellung des APEX-Agents-Benchmarks – und derzeit scheitern alle KI-Labore. Bei der Beantwortung von Fragen echter Fachleute konnten selbst die besten Modelle weniger als ein Viertel richtig beantworten. Meistens gaben sie eine falsche Antwort oder gar keine Antwort.
Laut Brendan Foody, CEO von Mercor, der an der Studie mitgewirkt hat, lag die größte Schwäche der Modelle in der Synthese von Informationen aus mehreren Bereichen – einer Kernkomponente der menschlichen Wissensarbeit.
„Eine wichtige Innovation dieses Benchmarks besteht darin, dass wir eine vollständige Umgebung nach dem Vorbild realer professioneller Dienstleistungen geschaffen haben“, erklärte Foody gegenüber TechCrunch. „Bei unserer Arbeit gibt es nicht eine einzige Person, die uns den gesamten Kontext an einem Ort zur Verfügung stellt. In der Realität arbeitet man mit Slack, Google Drive und verschiedenen anderen Tools.“ Bei vielen agentenbasierten KI-Modellen ist diese Art des domänenübergreifenden Denkens nach wie vor inkonsistent.
Die Testszenarien stammen von tatsächlichen Fachleuten auf dem Expertenmarktplatz von Mercor, die die Fragen entworfen und die Kriterien für eine erfolgreiche Antwort definiert haben. Ein Blick auf die öffentlich zugänglichen Fragen auf Hugging Face zeigt die Komplexität dieser Aufgaben.
Techcrunch-VeranstaltungDisrupt 2026 Tickets: Einmaliges Angebot
Tickets sind jetzt erhältlich! Sparen Sie bis zu 680 $ während dieses zeitlich begrenzten Angebots und gehören Sie zu den ersten 500 Anmeldern, die 50 % Rabatt auf einen +1-Pass erhalten. TechCrunch Disrupt versammelt führende Persönlichkeiten von Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face und anderen für mehr als 250 Sessions, die darauf abzielen, Ihr Wachstum anzukurbeln und Ihren Wettbewerbsvorteil zu schärfen. Treffen Sie Hunderte innovativer Startups und nehmen Sie an einem kuratierten Networking teil, das Geschäfte, Einblicke und Inspiration fördert.
Disrupt 2026-Tickets: Einmaliges Angebot
Tickets sind jetzt erhältlich! Sparen Sie bis zu 680 $ während dieses zeitlich begrenzten Angebots und gehören Sie zu den ersten 500 Anmeldern, die 50 % Rabatt auf einen +1-Pass erhalten. TechCrunch Disrupt versammelt Top-Führungskräfte von Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face und anderen für über 250 Sessions, die darauf abzielen, Wachstum zu fördern und Ihre Wettbewerbsfähigkeit zu steigern. Treffen Sie Hunderte innovativer Startups und nehmen Sie an einem kuratierten Networking teil, das Geschäfte, Einblicke und Inspiration fördert.
San Francisco | 13. bis 15. Oktober 2026 JETZT REGISTRIERENEin Beispiel aus dem Abschnitt „Recht” lautet:
Während der ersten 48 Minuten eines Produktionsausfalls in der EU exportierte das Engineering-Team von Northstar ein oder zwei gebündelte Sätze von EU-Produktionsereignisprotokollen, die personenbezogene Daten enthielten, an einen US-amerikanischen Analyseanbieter... Kann Northstar gemäß seinen eigenen Richtlinien diese ein oder zwei Protokollexporte vernünftigerweise als konform mit Artikel 49 behandeln?
Die richtige Antwort lautet „Ja“, aber um zu diesem Ergebnis zu gelangen, ist eine detaillierte Analyse sowohl der internen Richtlinien des Unternehmens als auch der relevanten EU-Datenschutzbestimmungen erforderlich.
Eine solche Frage könnte selbst einen sachkundigen Menschen vor eine Herausforderung stellen, aber die Forscher wollten reale berufliche Arbeit simulieren. Ein LLM, das diese Fragen zuverlässig beantworten kann, könnte möglicherweise viele praktizierende Anwälte ersetzen. „Dies ist wohl das derzeit wichtigste wirtschaftliche Thema“, sagte Foody gegenüber TechCrunch. „Der Benchmark spiegelt genau die tatsächliche Arbeit wider, die diese Fachleute leisten.“
OpenAI hat zuvor versucht, berufliche Fähigkeiten mit seinem GDPval-Benchmark zu messen, aber der APEX-Agents-Test unterscheidet sich erheblich davon. Während GDPval allgemeine Kenntnisse in vielen Bereichen bewertet, misst APEX-Agents die Fähigkeit eines Systems, nachhaltige Aufgaben in einigen ausgewählten hochkarätigen Berufen auszuführen. Dies macht es für Modelle schwieriger und für das Potenzial der Jobautomatisierung relevanter.
Obwohl noch kein Modell bereit ist, als Investmentbanker einzuspringen, kamen einige Modelle anderen deutlich näher als andere. Gemini 3 Flash führte die Gruppe mit einer One-Shot-Genauigkeit von 24 % an, dicht gefolgt von GPT-5.2 mit 23 %. Opus 4.5, Gemini 3 Pro und GPT-5 erzielten alle etwa 18 %.
Auch wenn diese ersten Ergebnisse nicht gerade überwältigend sind, hat der Bereich der KI in der Vergangenheit gezeigt, dass er schwierige Benchmarks schnell überwinden kann. Mit der Veröffentlichung des APEX-Agents-Tests stellt sich nun eine offene Herausforderung für KI-Labore, die von ihrer Fähigkeit zur Verbesserung überzeugt sind – ein Ergebnis, das Foody in den kommenden Monaten voll und ganz erwartet.
„Das Tempo der Verbesserungen ist bemerkenswert schnell“, sagte er gegenüber TechCrunch. „Derzeit kann man die Technologie mit einem Praktikanten vergleichen, der in einem Viertel der Fälle alles richtig macht, aber letztes Jahr war es ein Praktikant, der in 5 oder 10 % der Fälle erfolgreich war. Diese jährliche Fortschrittsrate kann sehr schnell erhebliche Auswirkungen haben.“








 Wichtige KI-Diskussionen, die die Agenda der AI LIVE London prägen
Der Gipfel bringt Führungskräfte aus der ganzen Welt zusammen, um drängende Herausforderungen in verschiedenen Branchen weltweit zu erörtern – von KI-getriebenen Umbrüchen bis hin zu wirtschaftlicher
 Google stellt Veo 3.1 Lite vor, sein günstigstes Videomodell, das die Penny-pro-Sekunde-Videogenerierung vorantreibt
Google hat offiziell die neueste Ergänzung seiner Video-Generierungsserie vorgestellt — Veo3.1Lite — die darauf abzielt, die Erstellung hochwertiger Videos zu demokratisieren, indem die Rechenkosten drastisch gesenkt werden. Dieses Modell hält Google
 Xiaoyunque AI stellt Kurzfilm-Agent vor, der auf Seedance 2.0 basiert und die Umwandlung in einen Film mit einem Klick ermöglicht
Am 19. März hat ByteDances all-in-one-KI-Plattform für die Erstellung von Inhalten Little Swallow AI offiziell die Funktion „Short Drama Agent“ vorgestellt. Als der erste intelligente Agent der Branche, der auf dem Seedance-2.0-Algorithmus basiert, a

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












