


 Maison
Une nouvelle étude remet en question la préparation des agents IA au monde du travail
Il y a près de deux ans, Satya Nadella, PDG de Microsoft, prévoyait que l'IA allait transformer le travail intellectuel, domaine réservé aux avocats, banquiers d'affaires, bibliothécaires, comptables, professionnels de l'informatique et autres professions similaires.
Cependant, malgré des progrès significatifs dans les modèles de base, la transformation du travail intellectuel a été lente à se concrétiser. Alors que les modèles excellent dans la recherche approfondie et la planification agentique, la plupart des professions intellectuelles ont connu relativement peu de bouleversements pour des raisons qui restent floues.
Cela reste l'une des grandes énigmes de l'IA. De nouvelles recherches menées par Mercor, leader dans le domaine des données d'entraînement, fournissent désormais des informations cruciales.
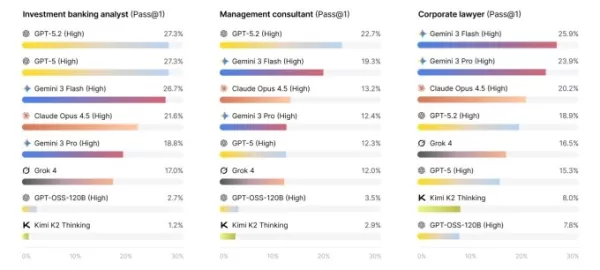
L'étude évalue la manière dont les meilleurs modèles d'IA traitent les tâches réelles des cols blancs dans les domaines du conseil, de la banque d'investissement et du droit. Cela a conduit à la création du benchmark APEX-Agents — et actuellement, tous les laboratoires d'IA échouent. Lorsqu'ils sont confrontés à des questions posées par de vrais professionnels, même les meilleurs modèles répondent correctement à moins d'un quart d'entre elles. Le plus souvent, ils renvoient une réponse incorrecte ou aucune réponse.
Selon Brendan Foody, PDG de Mercor, qui a contribué à cette étude, la principale faiblesse des modèles réside dans leur capacité à synthétiser des informations provenant de plusieurs domaines, une composante essentielle du travail intellectuel humain.
« Une innovation clé de ce benchmark est que nous avons construit un environnement complet inspiré des services professionnels réels », a expliqué M. Foody à TechCrunch. « Notre travail n'implique pas qu'une seule personne nous fournisse tout le contexte en un seul endroit. En réalité, vous travaillez sur Slack, Google Drive et divers autres outils. » Pour de nombreux modèles d'IA agentique, ce type de raisonnement interdomaines reste incohérent.
Capture d'écran Les scénarios de test ont été fournis par de véritables professionnels du marché des experts Mercor, qui ont conçu les requêtes et défini les critères d'une réponse réussie. L'examen des questions accessibles au public sur Hugging Face révèle la complexité de ces tâches.
Événement Techcrunch Billets Disrupt 2026 : offre unique
Les billets sont désormais disponibles ! Économisez jusqu'à 680 $ grâce à cette offre à durée limitée et faites partie des 500 premiers inscrits pour bénéficier d'une réduction de 50 % sur un pass +1. TechCrunch Disrupt rassemble les principaux dirigeants de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face et bien d'autres pour plus de 250 sessions visant à stimuler la croissance et à affiner votre avantage concurrentiel. Entrez en contact avec des centaines de startups innovantes et participez à un réseau sélectionné qui favorise les transactions, les idées et l'inspiration.
Billets Disrupt 2026 : offre unique
Les billets sont désormais disponibles ! Économisez jusqu'à 680 $ grâce à cette offre à durée limitée et faites partie des 500 premiers inscrits pour bénéficier d'une réduction de 50 % sur un pass +1. TechCrunch Disrupt rassemble les principaux dirigeants de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face et bien d'autres pour plus de 250 sessions visant à stimuler la croissance et à affiner votre avantage concurrentiel. Entrez en contact avec des centaines de startups innovantes et participez à un réseau sélectionné qui favorise les transactions, les idées et l'inspiration.
San Francisco | 13-15 octobre 2026 INSCRIVEZ-VOUS DÈS MAINTENANT Un exemple tiré de la section « Droit » pose la question suivante :
Au cours des 48 premières minutes d'une interruption de la production dans l'UE, l'équipe d'ingénieurs de Northstar a exporté un ou deux ensembles groupés de journaux d'événements de production dans l'UE contenant des données à caractère personnel vers un fournisseur d'analyses américain... Selon les propres politiques de Northstar, peut-elle raisonnablement considérer que ces exportations de journaux sont conformes à l'article 49 ?
La réponse correcte est oui, mais pour y parvenir, il faut analyser en détail à la fois les politiques internes de l'entreprise et les réglementations européennes pertinentes en matière de confidentialité.
Une telle question pourrait poser problème même à une personne bien informée, mais les chercheurs ont cherché à simuler un travail professionnel réel. Un LLM capable de répondre de manière fiable à ces questions pourrait potentiellement remplacer de nombreux avocats en exercice. « C'est sans doute le sujet économique le plus important aujourd'hui », a déclaré M. Foody à TechCrunch. « Le benchmark reflète fidèlement le travail réel effectué par ces professionnels. »
OpenAI avait déjà tenté d'évaluer les compétences professionnelles avec son benchmark GDPval, mais le test APEX-Agents est très différent. Alors que GDPval évalue les connaissances générales dans de nombreux domaines, APEX-Agents mesure la capacité d'un système à exécuter des tâches soutenues dans quelques professions à forte valeur ajoutée. Cela rend le test plus difficile pour les modèles et plus directement pertinent pour le potentiel d'automatisation des emplois.
Bien qu'aucun modèle ne soit prêt à remplacer un banquier d'investissement, certains s'en sont clairement rapprochés plus que d'autres. Gemini 3 Flash arrive en tête du groupe avec une précision de 24 % en un seul essai, suivi de près par GPT-5.2 avec 23 %. Opus 4.5, Gemini 3 Pro et GPT-5 ont tous obtenu un score d'environ 18 %.
Si ces premiers résultats sont décevants, le domaine de l'IA a déjà fait ses preuves en matière de dépassement rapide des benchmarks difficiles. Le test APEX-Agents étant désormais public, il représente un défi ouvert pour les laboratoires d'IA convaincus de pouvoir s'améliorer, un résultat que M. Foody anticipe pleinement dans les mois à venir.
« Le rythme des progrès est remarquablement rapide », a-t-il déclaré à TechCrunch. « Actuellement, on peut comparer cette technologie à un stagiaire qui réussit un quart du temps, mais l'année dernière, ce stagiaire ne réussissait que 5 à 10 % du temps. Ce rythme de progression d'une année sur l'autre peut avoir un impact considérable très rapidement. »
Article connexe
 L'ancien chef scientifique d'OpenAI, Ilya, dévoile son premier modèle SSI
L’intelligence artificielle a atteint un autre jalon majeur. Après son départ d’OpenAI, l’ancien scientifique en chef Ilya Sutskever a fondé Safe Superintelligence Inc. (SSI), qui a récemment dévoilé les détails de son premier modèle. Selon des rappo
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Le 14 mai 2026, la plateforme de développement d’applications d’IA Lovable a annoncé sa participation à une levée de fonds amorce de 800 000 $ pour la startup danoise de matériel Atech. Pilotée par Lovable, cette levée de fonds a attiré des sociétés
Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
Recommandations de sujets spéciaux liés
chatbot
 Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
 12 outils
 xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

 commentaires (0)
Il y a près de deux ans, Satya Nadella, PDG de Microsoft, prévoyait que l'IA allait transformer le travail intellectuel, domaine réservé aux avocats, banquiers d'affaires, bibliothécaires, comptables, professionnels de l'informatique et autres professions similaires.
Cependant, malgré des progrès significatifs dans les modèles de base, la transformation du travail intellectuel a été lente à se concrétiser. Alors que les modèles excellent dans la recherche approfondie et la planification agentique, la plupart des professions intellectuelles ont connu relativement peu de bouleversements pour des raisons qui restent floues.
Cela reste l'une des grandes énigmes de l'IA. De nouvelles recherches menées par Mercor, leader dans le domaine des données d'entraînement, fournissent désormais des informations cruciales.
L'étude évalue la manière dont les meilleurs modèles d'IA traitent les tâches réelles des cols blancs dans les domaines du conseil, de la banque d'investissement et du droit. Cela a conduit à la création du benchmark APEX-Agents — et actuellement, tous les laboratoires d'IA échouent. Lorsqu'ils sont confrontés à des questions posées par de vrais professionnels, même les meilleurs modèles répondent correctement à moins d'un quart d'entre elles. Le plus souvent, ils renvoient une réponse incorrecte ou aucune réponse.
Selon Brendan Foody, PDG de Mercor, qui a contribué à cette étude, la principale faiblesse des modèles réside dans leur capacité à synthétiser des informations provenant de plusieurs domaines, une composante essentielle du travail intellectuel humain.
« Une innovation clé de ce benchmark est que nous avons construit un environnement complet inspiré des services professionnels réels », a expliqué M. Foody à TechCrunch. « Notre travail n'implique pas qu'une seule personne nous fournisse tout le contexte en un seul endroit. En réalité, vous travaillez sur Slack, Google Drive et divers autres outils. » Pour de nombreux modèles d'IA agentique, ce type de raisonnement interdomaines reste incohérent.
Les scénarios de test ont été fournis par de véritables professionnels du marché des experts Mercor, qui ont conçu les requêtes et défini les critères d'une réponse réussie. L'examen des questions accessibles au public sur Hugging Face révèle la complexité de ces tâches.
Événement TechcrunchBillets Disrupt 2026 : offre unique
Les billets sont désormais disponibles ! Économisez jusqu'à 680 $ grâce à cette offre à durée limitée et faites partie des 500 premiers inscrits pour bénéficier d'une réduction de 50 % sur un pass +1. TechCrunch Disrupt rassemble les principaux dirigeants de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face et bien d'autres pour plus de 250 sessions visant à stimuler la croissance et à affiner votre avantage concurrentiel. Entrez en contact avec des centaines de startups innovantes et participez à un réseau sélectionné qui favorise les transactions, les idées et l'inspiration.
Billets Disrupt 2026 : offre unique
Les billets sont désormais disponibles ! Économisez jusqu'à 680 $ grâce à cette offre à durée limitée et faites partie des 500 premiers inscrits pour bénéficier d'une réduction de 50 % sur un pass +1. TechCrunch Disrupt rassemble les principaux dirigeants de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face et bien d'autres pour plus de 250 sessions visant à stimuler la croissance et à affiner votre avantage concurrentiel. Entrez en contact avec des centaines de startups innovantes et participez à un réseau sélectionné qui favorise les transactions, les idées et l'inspiration.
San Francisco | 13-15 octobre 2026 INSCRIVEZ-VOUS DÈS MAINTENANTUn exemple tiré de la section « Droit » pose la question suivante :
Au cours des 48 premières minutes d'une interruption de la production dans l'UE, l'équipe d'ingénieurs de Northstar a exporté un ou deux ensembles groupés de journaux d'événements de production dans l'UE contenant des données à caractère personnel vers un fournisseur d'analyses américain... Selon les propres politiques de Northstar, peut-elle raisonnablement considérer que ces exportations de journaux sont conformes à l'article 49 ?
La réponse correcte est oui, mais pour y parvenir, il faut analyser en détail à la fois les politiques internes de l'entreprise et les réglementations européennes pertinentes en matière de confidentialité.
Une telle question pourrait poser problème même à une personne bien informée, mais les chercheurs ont cherché à simuler un travail professionnel réel. Un LLM capable de répondre de manière fiable à ces questions pourrait potentiellement remplacer de nombreux avocats en exercice. « C'est sans doute le sujet économique le plus important aujourd'hui », a déclaré M. Foody à TechCrunch. « Le benchmark reflète fidèlement le travail réel effectué par ces professionnels. »
OpenAI avait déjà tenté d'évaluer les compétences professionnelles avec son benchmark GDPval, mais le test APEX-Agents est très différent. Alors que GDPval évalue les connaissances générales dans de nombreux domaines, APEX-Agents mesure la capacité d'un système à exécuter des tâches soutenues dans quelques professions à forte valeur ajoutée. Cela rend le test plus difficile pour les modèles et plus directement pertinent pour le potentiel d'automatisation des emplois.
Bien qu'aucun modèle ne soit prêt à remplacer un banquier d'investissement, certains s'en sont clairement rapprochés plus que d'autres. Gemini 3 Flash arrive en tête du groupe avec une précision de 24 % en un seul essai, suivi de près par GPT-5.2 avec 23 %. Opus 4.5, Gemini 3 Pro et GPT-5 ont tous obtenu un score d'environ 18 %.
Si ces premiers résultats sont décevants, le domaine de l'IA a déjà fait ses preuves en matière de dépassement rapide des benchmarks difficiles. Le test APEX-Agents étant désormais public, il représente un défi ouvert pour les laboratoires d'IA convaincus de pouvoir s'améliorer, un résultat que M. Foody anticipe pleinement dans les mois à venir.
« Le rythme des progrès est remarquablement rapide », a-t-il déclaré à TechCrunch. « Actuellement, on peut comparer cette technologie à un stagiaire qui réussit un quart du temps, mais l'année dernière, ce stagiaire ne réussissait que 5 à 10 % du temps. Ce rythme de progression d'une année sur l'autre peut avoir un impact considérable très rapidement. »








 L'ancien chef scientifique d'OpenAI, Ilya, dévoile son premier modèle SSI
L’intelligence artificielle a atteint un autre jalon majeur. Après son départ d’OpenAI, l’ancien scientifique en chef Ilya Sutskever a fondé Safe Superintelligence Inc. (SSI), qui a récemment dévoilé les détails de son premier modèle. Selon des rappo
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Le 14 mai 2026, la plateforme de développement d’applications d’IA Lovable a annoncé sa participation à une levée de fonds amorce de 800 000 $ pour la startup danoise de matériel Atech. Pilotée par Lovable, cette levée de fonds a attiré des sociétés
 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai












