


 Hogar
Nuevo punto de referencia cuestiona la preparación de los agentes de IA para el lugar de trabajo
Hace casi dos años, el director ejecutivo de Microsoft, Satya Nadella, pronosticó que la IA transformaría el trabajo intelectual, es decir, el ámbito de los abogados, los banqueros de inversión, los bibliotecarios, los contables, los profesionales de TI y otros puestos similares de oficina.
Sin embargo, a pesar de los importantes avances en los modelos básicos, la transformación del trabajo intelectual ha tardado en materializarse. Si bien los modelos destacan en la investigación profunda y la planificación agencial, la mayoría de las profesiones de cuello blanco han experimentado relativamente pocos cambios por razones que siguen sin estar claras.
Esto supone uno de los grandes enigmas de la IA. Una nueva investigación del líder en datos de entrenamiento Mercor está proporcionando ahora información crucial.
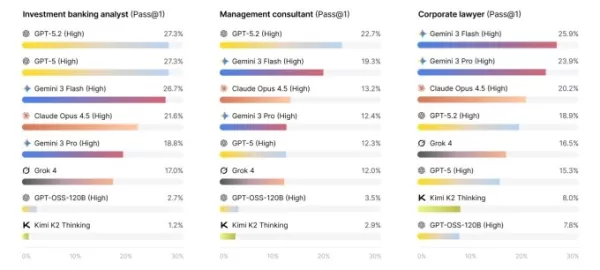
El estudio evalúa cómo los principales modelos de IA manejan tareas reales de cuello blanco de consultoría, banca de inversión y derecho. Esto condujo a la creación del índice de referencia APEX-Agents y, actualmente, todos los laboratorios de IA están fallando. Cuando se les presentaron consultas de profesionales reales, incluso los mejores modelos respondieron correctamente a menos de una cuarta parte. En la mayoría de los casos, dieron una respuesta incorrecta o no dieron ninguna.
Según Brendan Foody, director ejecutivo de Mercor, que contribuyó a la investigación, la principal debilidad de los modelos era la síntesis de información de múltiples ámbitos, un componente fundamental del trabajo intelectual humano.
«Una innovación clave en este índice de referencia es que hemos construido un entorno completo basado en servicios profesionales reales», explicó Foody a TechCrunch. «Nuestro trabajo no consiste en que una sola persona nos proporcione todo el contexto en un solo lugar. En realidad, se trabaja con Slack, Google Drive y otras herramientas diversas». Para muchos modelos de IA agencial, ese tipo de razonamiento entre dominios sigue siendo inconsistente.
Captura de pantalla Los escenarios de prueba procedían de profesionales reales del mercado de expertos de Mercor, que diseñaron las consultas y definieron los criterios para una respuesta satisfactoria. La revisión de las preguntas disponibles públicamente en Hugging Face revela la complejidad de estas tareas.
Evento Techcrunch Entradas para Disrupt 2026: oferta única
¡Ya están disponibles las entradas! Ahorre hasta 680 $ durante esta oferta por tiempo limitado y sea uno de los primeros 500 inscritos en recibir un 50 % de descuento en un pase +1. TechCrunch Disrupt reúne a los principales líderes de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face y muchos más en más de 250 sesiones destinadas a impulsar el crecimiento y afinar su ventaja competitiva. Conecta con cientos de startups innovadoras y participa en una red de contactos seleccionada que impulsa acuerdos, conocimientos e inspiración.
Entradas para Disrupt 2026: oferta única.
¡Las entradas ya están disponibles! Ahorre hasta 680 $ durante esta oferta por tiempo limitado y sea uno de los primeros 500 inscritos en recibir un 50 % de descuento en un pase +1. TechCrunch Disrupt reúne a los principales líderes de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face y muchos más en más de 250 sesiones destinadas a impulsar el crecimiento y afinar su ventaja competitiva. Conecta con cientos de startups innovadoras y participa en una red de contactos seleccionada que impulsa acuerdos, conocimientos e inspiración.
San Francisco | 13-15 de octubre de 2026 INSCRÍBETE AHORA Un ejemplo de la sección «Ley» pregunta:
Durante los primeros 48 minutos de una interrupción de la producción de la UE, el equipo de ingeniería de Northstar exportó uno o dos conjuntos agrupados de registros de eventos de producción de la UE que contenían datos personales a un proveedor de análisis de EE. UU... Según las propias políticas de Northstar, ¿puede considerar razonablemente que estas una o dos exportaciones de registros cumplen con el artículo 49?
La respuesta correcta es sí, pero para llegar a ella es necesario realizar un análisis detallado tanto de las políticas internas de la empresa como de la normativa de privacidad pertinente de la UE.
Una pregunta de este tipo podría suponer un reto incluso para una persona con conocimientos, pero los investigadores pretendían simular el trabajo profesional real. Un LLM que pueda responder de forma fiable a estas consultas podría sustituir potencialmente a muchos abogados en ejercicio. «Podría decirse que este es el tema económico más importante en la actualidad», declaró Foody a TechCrunch. «El punto de referencia refleja con precisión el trabajo real que realizan estos profesionales».
OpenAI ya había intentado evaluar las habilidades profesionales con su referencia GDPval, pero la prueba APEX-Agents difiere significativamente. Mientras que GDPval evalúa los conocimientos generales en muchos campos, APEX-Agents mide la capacidad de un sistema para ejecutar tareas sostenidas dentro de unas pocas profesiones de alto valor. Esto lo hace más difícil para los modelos y más directamente relevante para el potencial de automatización del trabajo.
Aunque ningún modelo está preparado para sustituir a un banquero de inversiones, algunos se acercaron claramente más que otros. Gemini 3 Flash lideró el grupo con una precisión del 24 % en una sola prueba, seguido de cerca por GPT-5.2 con un 23 %. Opus 4.5, Gemini 3 Pro y GPT-5 obtuvieron una puntuación de alrededor del 18 %.
Aunque estos resultados iniciales son decepcionantes, el campo de la IA tiene un historial de superar rápidamente los retos difíciles. Ahora que la prueba APEX-Agents es pública, supone un reto abierto para los laboratorios de IA que confían en poder mejorar, un resultado que Foody prevé plenamente en los próximos meses.
«El ritmo de mejora es notablemente rápido», declaró a TechCrunch. «Actualmente, es justo comparar la tecnología con un becario que acierta una cuarta parte de las veces, pero el año pasado era un becario que acertaba entre el 5 y el 10 % de las veces. Esa tasa de progreso interanual puede generar un impacto sustancial muy rápidamente».
Artículo relacionado
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz
Recomendaciones de temas especiales relacionados
chatbot
 Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
 10 herramientas
 xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

 comentario (0)
0/500
Hace casi dos años, el director ejecutivo de Microsoft, Satya Nadella, pronosticó que la IA transformaría el trabajo intelectual, es decir, el ámbito de los abogados, los banqueros de inversión, los bibliotecarios, los contables, los profesionales de TI y otros puestos similares de oficina.
Sin embargo, a pesar de los importantes avances en los modelos básicos, la transformación del trabajo intelectual ha tardado en materializarse. Si bien los modelos destacan en la investigación profunda y la planificación agencial, la mayoría de las profesiones de cuello blanco han experimentado relativamente pocos cambios por razones que siguen sin estar claras.
Esto supone uno de los grandes enigmas de la IA. Una nueva investigación del líder en datos de entrenamiento Mercor está proporcionando ahora información crucial.
El estudio evalúa cómo los principales modelos de IA manejan tareas reales de cuello blanco de consultoría, banca de inversión y derecho. Esto condujo a la creación del índice de referencia APEX-Agents y, actualmente, todos los laboratorios de IA están fallando. Cuando se les presentaron consultas de profesionales reales, incluso los mejores modelos respondieron correctamente a menos de una cuarta parte. En la mayoría de los casos, dieron una respuesta incorrecta o no dieron ninguna.
Según Brendan Foody, director ejecutivo de Mercor, que contribuyó a la investigación, la principal debilidad de los modelos era la síntesis de información de múltiples ámbitos, un componente fundamental del trabajo intelectual humano.
«Una innovación clave en este índice de referencia es que hemos construido un entorno completo basado en servicios profesionales reales», explicó Foody a TechCrunch. «Nuestro trabajo no consiste en que una sola persona nos proporcione todo el contexto en un solo lugar. En realidad, se trabaja con Slack, Google Drive y otras herramientas diversas». Para muchos modelos de IA agencial, ese tipo de razonamiento entre dominios sigue siendo inconsistente.
Los escenarios de prueba procedían de profesionales reales del mercado de expertos de Mercor, que diseñaron las consultas y definieron los criterios para una respuesta satisfactoria. La revisión de las preguntas disponibles públicamente en Hugging Face revela la complejidad de estas tareas.
Evento TechcrunchEntradas para Disrupt 2026: oferta única
¡Ya están disponibles las entradas! Ahorre hasta 680 $ durante esta oferta por tiempo limitado y sea uno de los primeros 500 inscritos en recibir un 50 % de descuento en un pase +1. TechCrunch Disrupt reúne a los principales líderes de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face y muchos más en más de 250 sesiones destinadas a impulsar el crecimiento y afinar su ventaja competitiva. Conecta con cientos de startups innovadoras y participa en una red de contactos seleccionada que impulsa acuerdos, conocimientos e inspiración.
Entradas para Disrupt 2026: oferta única.
¡Las entradas ya están disponibles! Ahorre hasta 680 $ durante esta oferta por tiempo limitado y sea uno de los primeros 500 inscritos en recibir un 50 % de descuento en un pase +1. TechCrunch Disrupt reúne a los principales líderes de Google Cloud, Netflix, Microsoft, Box, a16z, Hugging Face y muchos más en más de 250 sesiones destinadas a impulsar el crecimiento y afinar su ventaja competitiva. Conecta con cientos de startups innovadoras y participa en una red de contactos seleccionada que impulsa acuerdos, conocimientos e inspiración.
San Francisco | 13-15 de octubre de 2026 INSCRÍBETE AHORAUn ejemplo de la sección «Ley» pregunta:
Durante los primeros 48 minutos de una interrupción de la producción de la UE, el equipo de ingeniería de Northstar exportó uno o dos conjuntos agrupados de registros de eventos de producción de la UE que contenían datos personales a un proveedor de análisis de EE. UU... Según las propias políticas de Northstar, ¿puede considerar razonablemente que estas una o dos exportaciones de registros cumplen con el artículo 49?
La respuesta correcta es sí, pero para llegar a ella es necesario realizar un análisis detallado tanto de las políticas internas de la empresa como de la normativa de privacidad pertinente de la UE.
Una pregunta de este tipo podría suponer un reto incluso para una persona con conocimientos, pero los investigadores pretendían simular el trabajo profesional real. Un LLM que pueda responder de forma fiable a estas consultas podría sustituir potencialmente a muchos abogados en ejercicio. «Podría decirse que este es el tema económico más importante en la actualidad», declaró Foody a TechCrunch. «El punto de referencia refleja con precisión el trabajo real que realizan estos profesionales».
OpenAI ya había intentado evaluar las habilidades profesionales con su referencia GDPval, pero la prueba APEX-Agents difiere significativamente. Mientras que GDPval evalúa los conocimientos generales en muchos campos, APEX-Agents mide la capacidad de un sistema para ejecutar tareas sostenidas dentro de unas pocas profesiones de alto valor. Esto lo hace más difícil para los modelos y más directamente relevante para el potencial de automatización del trabajo.
Aunque ningún modelo está preparado para sustituir a un banquero de inversiones, algunos se acercaron claramente más que otros. Gemini 3 Flash lideró el grupo con una precisión del 24 % en una sola prueba, seguido de cerca por GPT-5.2 con un 23 %. Opus 4.5, Gemini 3 Pro y GPT-5 obtuvieron una puntuación de alrededor del 18 %.
Aunque estos resultados iniciales son decepcionantes, el campo de la IA tiene un historial de superar rápidamente los retos difíciles. Ahora que la prueba APEX-Agents es pública, supone un reto abierto para los laboratorios de IA que confían en poder mejorar, un resultado que Foody prevé plenamente en los próximos meses.
«El ritmo de mejora es notablemente rápido», declaró a TechCrunch. «Actualmente, es justo comparar la tecnología con un becario que acierta una cuarta parte de las veces, pero el año pasado era un becario que acertaba entre el 5 y el 10 % de las veces. Esa tasa de progreso interanual puede generar un impacto sustancial muy rápidamente».








 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai












