
option
Maison
Flash info
Contenu
JerryGonzalez
JerryGonzalez
27 juillet 2026

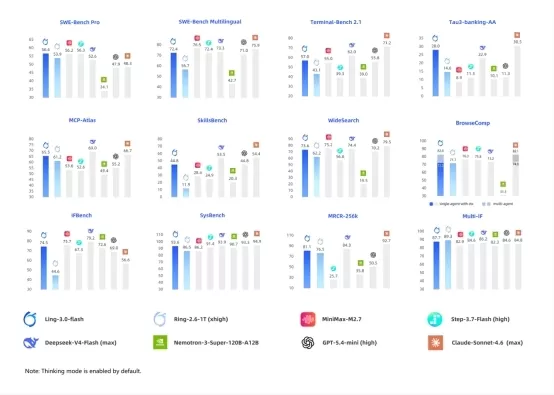
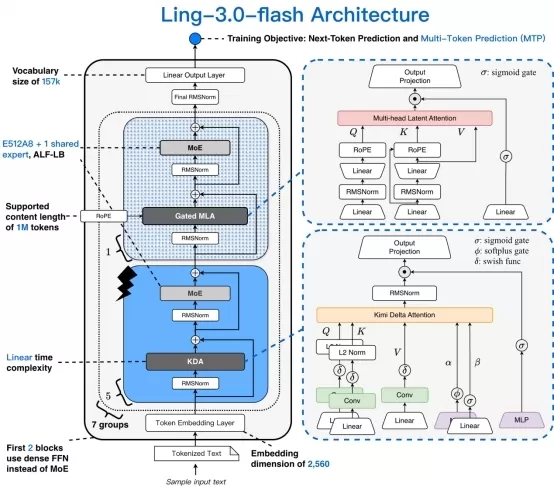
Ant Bailing a lancé Ling-3.0-Flash, un modèle de raisonnement hybride disposant d’un total de 124 milliards de paramètres dont 5,1 milliards sont activés, et qui atteint ou dépasse en performances les modèles deux à trois fois plus volumineux dans les tâches de raisonnement et sur de longs textes. Il intègre une architecture d’attention hybride 5:1 (couche linéaire KDA et couches MLA) ainsi qu’un taux d’activation des experts de 1/64 afin d’améliorer l’efficacité. Optimisé pour les applications d’agents grâce à plus de 10 000 scénarios d’entraînement, il réduit le temps de latence lié au premier token de 60 à 80 % grâce à un système de mise en cache hiérarchique. Il est désormais disponible gratuitement sur OpenRouter pendant une semaine avant d’être mis sous licence open source.
Ant Bailing a lancé Ling-3.0-Flash, un modèle de raisonnement hybride disposant d’un total de 124 milliards de paramètres dont 5,1 milliards sont activés, et qui atteint ou dépasse en performances les modèles deux à trois fois plus volumineux dans les tâches de raisonnement et sur de longs textes. Il intègre une architecture d’attention hybride 5:1 (couche linéaire KDA et couches MLA) ainsi qu’un taux d’activation des experts de 1/64 afin d’améliorer l’efficacité. Optimisé pour les applications d’agents grâce à plus de 10 000 scénarios d’entraînement, il réduit le temps de latence lié au premier token de 60 à 80 % grâce à un système de mise en cache hiérarchique. Il est désormais disponible gratuitement sur OpenRouter pendant une semaine avant d’être mis sous licence open source. Ant Bailing a lancé Ling-3.0-Flash, un modèle de raisonnement hybride disposant d’un total de 124 milliards de paramètres dont 5,1 milliards sont activés, et qui atteint ou dépasse en performances les modèles deux à trois fois plus volumineux dans les tâches de raisonnement et sur de longs textes. Il intègre une architecture d’attention hybride 5:1 (couche linéaire KDA et couches MLA) ainsi qu’un taux d’activation des experts de 1/64 afin d’améliorer l’efficacité. Optimisé pour les applications d’agents grâce à plus de 10 000 scénarios d’entraînement, il réduit le temps de latence lié au premier token de 60 à 80 % grâce à un système de mise en cache hiérarchique. Il est désormais disponible gratuitement sur OpenRouter pendant une semaine avant d’être mis sous licence open source.
commentaires (0)
0/300
OR