
Option
Heim
Eilmeldung
Inhalt
JerryGonzalez
JerryGonzalez
27. Juli 2026

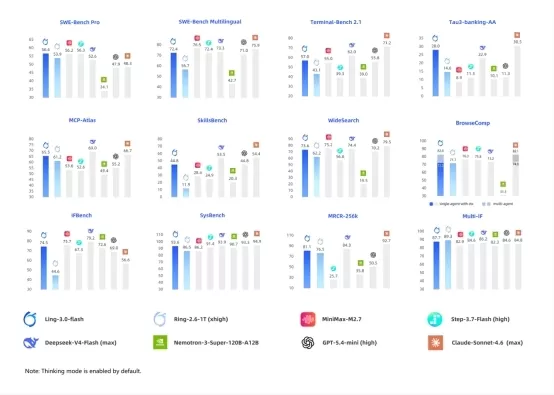
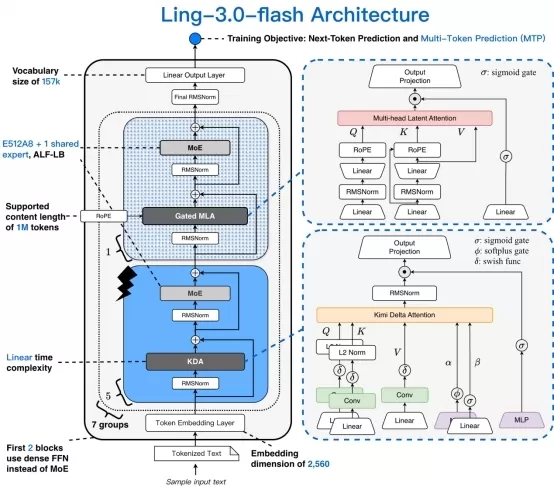
Ant Bailing hat Ling-3.0-Flash veröffentlicht – ein hybrides Reasoning-Modell mit insgesamt 124 Milliarden Parametern, wovon 5,1 Milliarden aktiviert sind. In Aufgaben des logischen Denkens sowie bei der Verarbeitung langer Texte erreicht es Leistungen, die denen von Modellen um das Zwei- bis Dreifache größeren Größen entsprechen oder diese sogar übertreffen. Es verfügt über eine hybride Attention-Architektur im Verhältnis 5:1 (bestehend aus KDA-linearen Schichten sowie MLA-Schichten) sowie ein Experten-Aktivierungsverhältnis von 1/64, um eine höhere Effizienz zu gewährleisten. Für Anwendungen in Agenten-Systemen wurde es anhand von über 10.000 Trainingsszenarien optimiert; durch hierarchisches Caching wird die Latenzzeit beim ersten Token um 60 bis 80 Prozent verringert. Derzeit ist das Modell eine Woche lang kostenlos auf OpenRouter verfügbar, danach wird es unter einer Open-Source-Lizenz bereitgestellt.
Ant Bailing hat Ling-3.0-Flash veröffentlicht – ein hybrides Reasoning-Modell mit insgesamt 124 Milliarden Parametern, wovon 5,1 Milliarden aktiviert sind. In Aufgaben des logischen Denkens sowie bei der Verarbeitung langer Texte erreicht es Leistungen, die denen von Modellen um das Zwei- bis Dreifache größeren Größen entsprechen oder diese sogar übertreffen. Es verfügt über eine hybride Attention-Architektur im Verhältnis 5:1 (bestehend aus KDA-linearen Schichten sowie MLA-Schichten) sowie ein Experten-Aktivierungsverhältnis von 1/64, um eine höhere Effizienz zu gewährleisten. Für Anwendungen in Agenten-Systemen wurde es anhand von über 10.000 Trainingsszenarien optimiert; durch hierarchisches Caching wird die Latenzzeit beim ersten Token um 60 bis 80 Prozent verringert. Derzeit ist das Modell eine Woche lang kostenlos auf OpenRouter verfügbar, danach wird es unter einer Open-Source-Lizenz bereitgestellt. Ant Bailing hat Ling-3.0-Flash veröffentlicht – ein hybrides Reasoning-Modell mit insgesamt 124 Milliarden Parametern, wovon 5,1 Milliarden aktiviert sind. In Aufgaben des logischen Denkens sowie bei der Verarbeitung langer Texte erreicht es Leistungen, die denen von Modellen um das Zwei- bis Dreifache größeren Größen entsprechen oder diese sogar übertreffen. Es verfügt über eine hybride Attention-Architektur im Verhältnis 5:1 (bestehend aus KDA-linearen Schichten sowie MLA-Schichten) sowie ein Experten-Aktivierungsverhältnis von 1/64, um eine höhere Effizienz zu gewährleisten. Für Anwendungen in Agenten-Systemen wurde es anhand von über 10.000 Trainingsszenarien optimiert; durch hierarchisches Caching wird die Latenzzeit beim ersten Token um 60 bis 80 Prozent verringert. Derzeit ist das Modell eine Woche lang kostenlos auf OpenRouter verfügbar, danach wird es unter einer Open-Source-Lizenz bereitgestellt.
Kommentare (0)
0/300
OR