
opção
JerryGonzalez
JerryGonzalez
27 de Julho de 2026

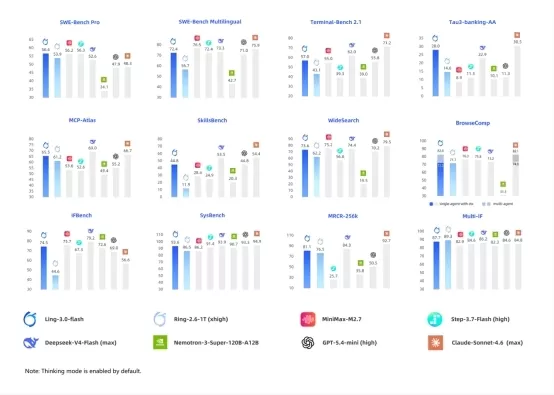
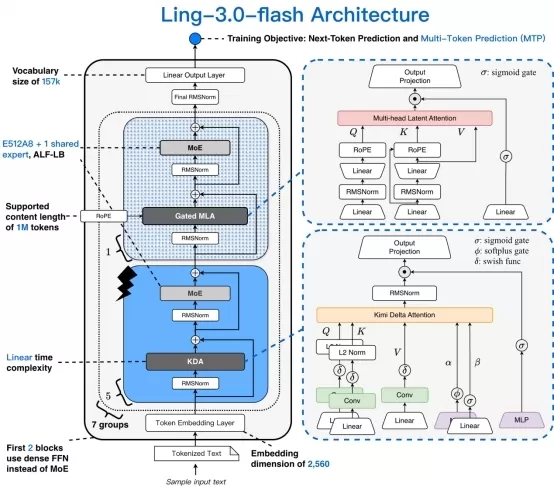
A Ant Bailing lançou o Ling-3.0-Flash, um modelo de raciocínio híbrido com 124 bilhões de parâmetros no total e 5,1 bilhões ativados, capaz de igualar ou superar em desempenho modelos 2 a 3 vezes maiores em tarefas de raciocínio e processamento de textos longos. Ele conta com uma arquitetura de atenção híbrida na proporção de 5:1 (camadas KDA lineares e MLA) e uma taxa de ativação de especialistas de 1/64, o que contribui para maior eficiência. Otimizado para aplicações com agentes, utilizando mais de 10.000 cenários de treinamento, ele reduz o tempo de resposta até o primeiro token em 60 a 80% graças ao armazenamento em cache hierárquico. Está disponível gratuitamente no OpenRouter por uma semana, sendo posteriormente tornado de código aberto.
A Ant Bailing lançou o Ling-3.0-Flash, um modelo de raciocínio híbrido com 124 bilhões de parâmetros no total e 5,1 bilhões ativados, capaz de igualar ou superar em desempenho modelos 2 a 3 vezes maiores em tarefas de raciocínio e processamento de textos longos. Ele conta com uma arquitetura de atenção híbrida na proporção de 5:1 (camadas KDA lineares e MLA) e uma taxa de ativação de especialistas de 1/64, o que contribui para maior eficiência. Otimizado para aplicações com agentes, utilizando mais de 10.000 cenários de treinamento, ele reduz o tempo de resposta até o primeiro token em 60 a 80% graças ao armazenamento em cache hierárquico. Está disponível gratuitamente no OpenRouter por uma semana, sendo posteriormente tornado de código aberto. A Ant Bailing lançou o Ling-3.0-Flash, um modelo de raciocínio híbrido com 124 bilhões de parâmetros no total e 5,1 bilhões ativados, capaz de igualar ou superar em desempenho modelos 2 a 3 vezes maiores em tarefas de raciocínio e processamento de textos longos. Ele conta com uma arquitetura de atenção híbrida na proporção de 5:1 (camadas KDA lineares e MLA) e uma taxa de ativação de especialistas de 1/64, o que contribui para maior eficiência. Otimizado para aplicações com agentes, utilizando mais de 10.000 cenários de treinamento, ele reduz o tempo de resposta até o primeiro token em 60 a 80% graças ao armazenamento em cache hierárquico. Está disponível gratuitamente no OpenRouter por uma semana, sendo posteriormente tornado de código aberto.
Comentários (0)
0/300
OR