
opción
Hogar
Última hora
Contenido
JerryGonzalez
JerryGonzalez
27 de julio de 2026

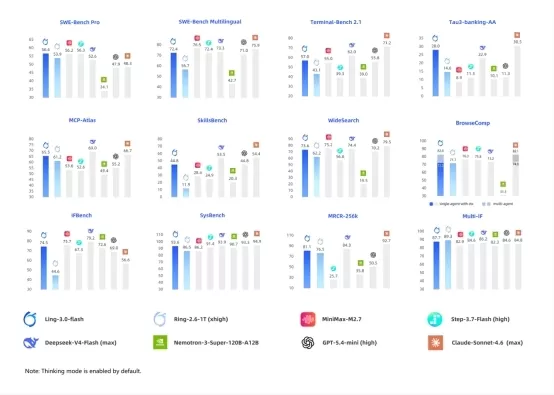
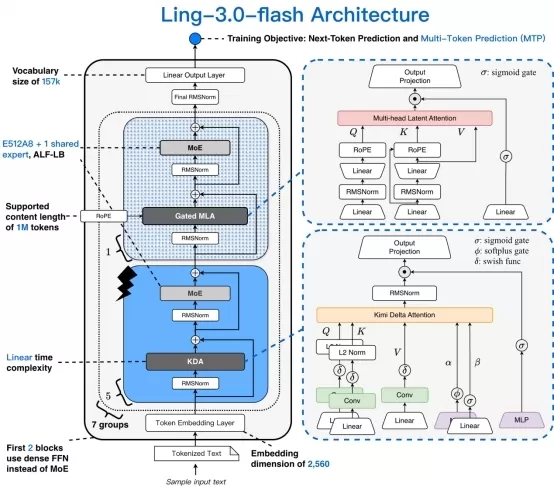
Ant Bailing lanzó Ling-3.0-Flash, un modelo de razonamiento híbrido que cuenta con 124 mil millones de parámetros en total y 5.1 mil millones activos, logrando igualar o superar en rendimiento a modelos hasta 2-3 veces más grandes en tareas de razonamiento y manejo de textos extensos. Este modelo incorpora una arquitectura de atención híbrida de 5:1 (capas lineales KDA y capas MLA), además de una proporción de activación de expertos de 1/64 para mejorar su eficiencia. Optimizado para aplicaciones basadas en agentes que incluyen más de 10,000 escenarios de entrenamiento, reduce la latencia del primer token entre un 60% y un 80% gracias al uso de caché jerárquico. Actualmente está disponible de forma gratuita en OpenRouter durante una semana, tras lo cual pasará a ser de código abierto.
Ant Bailing lanzó Ling-3.0-Flash, un modelo de razonamiento híbrido que cuenta con 124 mil millones de parámetros en total y 5.1 mil millones activos, logrando igualar o superar en rendimiento a modelos hasta 2-3 veces más grandes en tareas de razonamiento y manejo de textos extensos. Este modelo incorpora una arquitectura de atención híbrida de 5:1 (capas lineales KDA y capas MLA), además de una proporción de activación de expertos de 1/64 para mejorar su eficiencia. Optimizado para aplicaciones basadas en agentes que incluyen más de 10,000 escenarios de entrenamiento, reduce la latencia del primer token entre un 60% y un 80% gracias al uso de caché jerárquico. Actualmente está disponible de forma gratuita en OpenRouter durante una semana, tras lo cual pasará a ser de código abierto. Ant Bailing lanzó Ling-3.0-Flash, un modelo de razonamiento híbrido que cuenta con 124 mil millones de parámetros en total y 5.1 mil millones activos, logrando igualar o superar en rendimiento a modelos hasta 2-3 veces más grandes en tareas de razonamiento y manejo de textos extensos. Este modelo incorpora una arquitectura de atención híbrida de 5:1 (capas lineales KDA y capas MLA), además de una proporción de activación de expertos de 1/64 para mejorar su eficiencia. Optimizado para aplicaciones basadas en agentes que incluyen más de 10,000 escenarios de entrenamiento, reduce la latencia del primer token entre un 60% y un 80% gracias al uso de caché jerárquico. Actualmente está disponible de forma gratuita en OpenRouter durante una semana, tras lo cual pasará a ser de código abierto.
comentario (0)
0/300
OR