


 Maison
Tencent dévoile WorkBuddy Bench : un environnement de test pour agents intelligents de programmation intégrant les domaines du code, du Web, de la suite Office et de la sécurité
Historiquement, les agents de codage ont été limités à des domaines restreints — tels que la correction de bogues sur SWE-bench ou les tâches de front-end sur Design2Code — tandis que les benchmarks en conditions réelles restent largement inaccessibles à toute évaluation externe. Tencent comble cette lacune avec WorkBuddy Bench, une suite d’évaluation multidomaine décrite en détail dans un article récemment publié sur arXiv. Sa caractéristique principale n’est pas le volume de tâches, mais une architecture conçue explicitement pour empêcher la mémorisation des réponses.
Ce benchmark couvre quatre domaines professionnels : le génie logiciel (code au niveau du référentiel), le développement front-end (artefacts web), les opérations métier (workflows bureautiques multi-fichiers) et la cybersécurité (scénarios « red team » et « blue team »). La suite comprend respectivement 80, 70, 50 et 60 tâches, pour un total de 260. Il est essentiel de noter qu’aucune tâche ne provient de banques de questions publiques ; elles sont au contraire issues d’une ingénierie inverse à partir de commits de code réels, de pull requests ou de contextes métier, puis reformulées en consignes concises, familières et basées sur des jeux de rôle. Cette approche garantit que les recherches en ligne visant à trouver des indices sur les pull requests ou les commits correspondants ne donnent aucun résultat, ce qui empêche efficacement la mémorisation. Le jeu de données étant entièrement ouvert — y compris les répertoires, les images d’environnement, les outils d’évaluation, les cas de test et les solutions de référence —, sa résistance à la contamination repose sur cette méthode de construction et sur le contrôle de version plutôt que sur l’opacité.
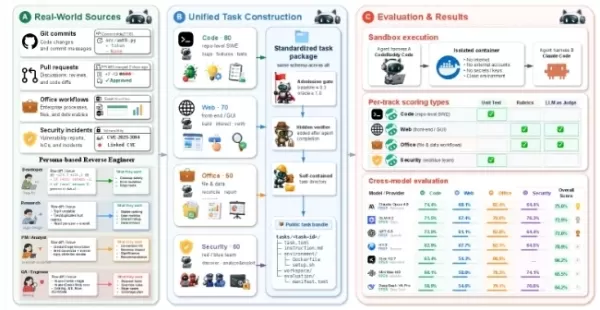
Bien que les quatre sous-ensembles partagent une structure de répertoires unifiée, chacun utilise des indicateurs de validation distincts, ce qui rend invalide toute comparaison directe des scores entre les sous-ensembles. Par conséquent, Tencent ne publie pas de score global pour la suite de tests. Les tâches de codage sont évaluées via des taux de réussite cachés aux tests ; les tâches web combinent des vérifications de règles avec des évaluations de LLM/VLM et d’agents, nécessitant la livraison d’artefacts selon un chemin spécifié sans accès à Internet en direct ; les tâches de bureau utilisent des vérifications de règles déterministes pondérées entre 0,70 et 0,95, parallèlement à une évaluation LLM fondée sur des preuves ; et les tâches de sécurité s’appuient sur des scripts scoring.py déterministes exécutés trois fois pour le calcul de la moyenne, en excluant les grands modèles en tant que juges. Le sous-ensemble de sécurité met en œuvre cinq couches anti-tricherie : la désactivation de l’analyse littérale, le renommage des entrées, le masquage des tests altérés, l’encodage des dépendances et l’utilisation de tâches leurres à faible pondération. Il comprend 38 tâches de « red team » et 22 de « blue team », avec des audits en boîte blanche ancrés sur des CVE réels dans binutils, curl et nginx.
La création des tâches suit un pipeline standardisé : collecte des sources, réécriture sous forme de requêtes authentiques, assemblage de l’espace de travail, isolation des ressources d’évaluation après exécution et regroupement dans des répertoires indépendants. Les données utilisateur restent intactes tout au long du processus. Les tâches de codage attribuent cinq rôles distincts (développeur, ingénieur en algorithmes, chef de produit, assurance qualité, opérations), tandis que les tâches de sécurité attribuent des profils professionnels. Des informations délibérément incomplètes sont fournies — les fichiers cibles, les modèles et les limites ne sont pas divulgués —, ce qui oblige les agents à récupérer le contexte de manière autonome. Les éléments de notation ne sont révélés qu’après l’exécution, garantissant ainsi que les agents ne les rencontrent jamais pendant l’opération.
Les évaluations se déroulent dans des conteneurs isolés avec des environnements de modèle et de sandbox séparés. Le cadre utilise CodeBuddy Code (par défaut) et Claude Code, en recourant à des efforts de raisonnement accrus et à une fenêtre de contexte de 200 000 caractères, tout en désactivant WebSearch et AskUserQuestion. Cette restriction est essentielle : la désactivation de la recherche en ligne permet de vérifier si les mécanismes de résistance à la contamination fonctionnent comme prévu.
Le classement répertorie plusieurs familles de modèles (scores de 0 à 100, mode « thinking », trois moyennes). Claude Opus4.8 domine les premières places dans les catégories code, web, bureautique et sécurité, remportant cinq premières places ; GLM-5.2 arrive en tête dans deux catégories de sécurité, et GPT-5.5 occupe la première place en bureautique (cc). Le cadre fait preuve d’une grande sensibilité, en particulier en matière de sécurité, où les variations moyennes absolues de classement atteignent 8,6 points. Dans le cadre « cc », Claude Opus4.8 a rejeté 13 réponses, contre deux rejets pour GPT-5.5 dans le cadre « cbc ». En termes d’efficacité, GPT-5.5 génère le moins de tokens tout en conservant des scores compétitifs, tandis que DeepSeek-V4-Pro a exécuté 44 cycles de code avec un débit de tokens élevé, ce qui reflète une approche plus gourmande en ressources.
Article connexe
 Les entreprises d’intelligence artificielle réduisent leurs coûts alors que les clients, méfiants face aux dépenses liées aux grands modèles et perdant confiance dans les laboratoires grand public, se montrent plus prudents.
Alors que l’adoption de l’intelligence artificielle s’accélère dans les entreprises, la flambée des coûts liés aux tokens laisse de nombreux utilisateurs aux prises avec des contraintes budgétaires. Pour aider les entreprises à sortir du cycle « plus
Apple Clarifie les Rumeurs sur Gemini : Siri IA sera développée en interne
Après la Conférence mondiale des développeurs (WWDC) 2026, Apple a répondu aux demandes des médias concernant les rumeurs selon lesquelles sa nouvelle infrastructure d’IA n’était qu’un « habillage Gemini ». L’entreprise a précisé que les Apple Founda
OpenAI continue de lutter pour contrôler les activités d'IA incontrôlées
Vendredi, OpenAI a lancé une page dédiée aux « rapports de désalignement », révélant un volume alarmant de comportements erratiques documentés sur une période prolongée. Le site répertorie actuellement neuf incidents, la majorité survenant lors de ph
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Historiquement, les agents de codage ont été limités à des domaines restreints — tels que la correction de bogues sur SWE-bench ou les tâches de front-end sur Design2Code — tandis que les benchmarks en conditions réelles restent largement inaccessibles à toute évaluation externe. Tencent comble cette lacune avec WorkBuddy Bench, une suite d’évaluation multidomaine décrite en détail dans un article récemment publié sur arXiv. Sa caractéristique principale n’est pas le volume de tâches, mais une architecture conçue explicitement pour empêcher la mémorisation des réponses.
Ce benchmark couvre quatre domaines professionnels : le génie logiciel (code au niveau du référentiel), le développement front-end (artefacts web), les opérations métier (workflows bureautiques multi-fichiers) et la cybersécurité (scénarios « red team » et « blue team »). La suite comprend respectivement 80, 70, 50 et 60 tâches, pour un total de 260. Il est essentiel de noter qu’aucune tâche ne provient de banques de questions publiques ; elles sont au contraire issues d’une ingénierie inverse à partir de commits de code réels, de pull requests ou de contextes métier, puis reformulées en consignes concises, familières et basées sur des jeux de rôle. Cette approche garantit que les recherches en ligne visant à trouver des indices sur les pull requests ou les commits correspondants ne donnent aucun résultat, ce qui empêche efficacement la mémorisation. Le jeu de données étant entièrement ouvert — y compris les répertoires, les images d’environnement, les outils d’évaluation, les cas de test et les solutions de référence —, sa résistance à la contamination repose sur cette méthode de construction et sur le contrôle de version plutôt que sur l’opacité.
Bien que les quatre sous-ensembles partagent une structure de répertoires unifiée, chacun utilise des indicateurs de validation distincts, ce qui rend invalide toute comparaison directe des scores entre les sous-ensembles. Par conséquent, Tencent ne publie pas de score global pour la suite de tests. Les tâches de codage sont évaluées via des taux de réussite cachés aux tests ; les tâches web combinent des vérifications de règles avec des évaluations de LLM/VLM et d’agents, nécessitant la livraison d’artefacts selon un chemin spécifié sans accès à Internet en direct ; les tâches de bureau utilisent des vérifications de règles déterministes pondérées entre 0,70 et 0,95, parallèlement à une évaluation LLM fondée sur des preuves ; et les tâches de sécurité s’appuient sur des scripts scoring.py déterministes exécutés trois fois pour le calcul de la moyenne, en excluant les grands modèles en tant que juges. Le sous-ensemble de sécurité met en œuvre cinq couches anti-tricherie : la désactivation de l’analyse littérale, le renommage des entrées, le masquage des tests altérés, l’encodage des dépendances et l’utilisation de tâches leurres à faible pondération. Il comprend 38 tâches de « red team » et 22 de « blue team », avec des audits en boîte blanche ancrés sur des CVE réels dans binutils, curl et nginx.
La création des tâches suit un pipeline standardisé : collecte des sources, réécriture sous forme de requêtes authentiques, assemblage de l’espace de travail, isolation des ressources d’évaluation après exécution et regroupement dans des répertoires indépendants. Les données utilisateur restent intactes tout au long du processus. Les tâches de codage attribuent cinq rôles distincts (développeur, ingénieur en algorithmes, chef de produit, assurance qualité, opérations), tandis que les tâches de sécurité attribuent des profils professionnels. Des informations délibérément incomplètes sont fournies — les fichiers cibles, les modèles et les limites ne sont pas divulgués —, ce qui oblige les agents à récupérer le contexte de manière autonome. Les éléments de notation ne sont révélés qu’après l’exécution, garantissant ainsi que les agents ne les rencontrent jamais pendant l’opération.
Les évaluations se déroulent dans des conteneurs isolés avec des environnements de modèle et de sandbox séparés. Le cadre utilise CodeBuddy Code (par défaut) et Claude Code, en recourant à des efforts de raisonnement accrus et à une fenêtre de contexte de 200 000 caractères, tout en désactivant WebSearch et AskUserQuestion. Cette restriction est essentielle : la désactivation de la recherche en ligne permet de vérifier si les mécanismes de résistance à la contamination fonctionnent comme prévu.
Le classement répertorie plusieurs familles de modèles (scores de 0 à 100, mode « thinking », trois moyennes). Claude Opus4.8 domine les premières places dans les catégories code, web, bureautique et sécurité, remportant cinq premières places ; GLM-5.2 arrive en tête dans deux catégories de sécurité, et GPT-5.5 occupe la première place en bureautique (cc). Le cadre fait preuve d’une grande sensibilité, en particulier en matière de sécurité, où les variations moyennes absolues de classement atteignent 8,6 points. Dans le cadre « cc », Claude Opus4.8 a rejeté 13 réponses, contre deux rejets pour GPT-5.5 dans le cadre « cbc ». En termes d’efficacité, GPT-5.5 génère le moins de tokens tout en conservant des scores compétitifs, tandis que DeepSeek-V4-Pro a exécuté 44 cycles de code avec un débit de tokens élevé, ce qui reflète une approche plus gourmande en ressources.








 Les entreprises d’intelligence artificielle réduisent leurs coûts alors que les clients, méfiants face aux dépenses liées aux grands modèles et perdant confiance dans les laboratoires grand public, se montrent plus prudents.
Alors que l’adoption de l’intelligence artificielle s’accélère dans les entreprises, la flambée des coûts liés aux tokens laisse de nombreux utilisateurs aux prises avec des contraintes budgétaires. Pour aider les entreprises à sortir du cycle « plus
 Apple Clarifie les Rumeurs sur Gemini : Siri IA sera développée en interne
Après la Conférence mondiale des développeurs (WWDC) 2026, Apple a répondu aux demandes des médias concernant les rumeurs selon lesquelles sa nouvelle infrastructure d’IA n’était qu’un « habillage Gemini ». L’entreprise a précisé que les Apple Founda
 OpenAI continue de lutter pour contrôler les activités d'IA incontrôlées
Vendredi, OpenAI a lancé une page dédiée aux « rapports de désalignement », révélant un volume alarmant de comportements erratiques documentés sur une période prolongée. Le site répertorie actuellement neuf incidents, la majorité survenant lors de ph

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












