


 家
テンセント、「WorkBuddy Bench」を発表:コード、Web、Office、セキュリティを統合したコーディングAIエージェントのテスト環境
これまで、コーディングエージェントは、SWE-benchでのバグ修正やDesign2Codeでのフロントエンドタスクなど、狭い領域に限定されてきた一方で、実運用環境のベンチマークについては、外部からの検証がほぼ不可能な状態が続いていました。 テンセントは、最近のarXiv論文で詳述されたマルチドメイン評価スイート「WorkBuddy Bench」を用いて、このギャップに対処しています。その最大の特徴はタスクの量ではなく、解答の暗記を防止するために明示的に設計されたアーキテクチャにあります。
このベンチマークは、ソフトウェアエンジニアリング(リポジトリレベルのコード)、フロントエンド開発(Webアーティファクト)、業務運営(複数ファイルにわたるオフィスワークフロー)、サイバーセキュリティ(レッドチームおよびブルーチームのシナリオ)という4つの専門分野を網羅しています。 このスイートは、それぞれ80、70、50、60のタスクで構成され、合計260タスクとなる。 重要な点として、どのタスクも公開されている問題バンクに由来するものではなく、実際のコードコミット、プルリクエスト、あるいはビジネスコンテキストからリバースエンジニアリングされ、簡潔で口語的なロールプレイ形式のプロンプトに言い換えられています。 このアプローチにより、対応するプルリクエストやコミットの手がかりをオンラインで検索しても結果が得られなくなり、暗記を効果的に阻止します。ディレクトリ、環境イメージ、評価ツール、テストケース、参照ソリューションを含むデータセットは完全に公開されているため、その汚染耐性は、隠蔽性ではなく、この構築方法とバージョン管理に依存しています。
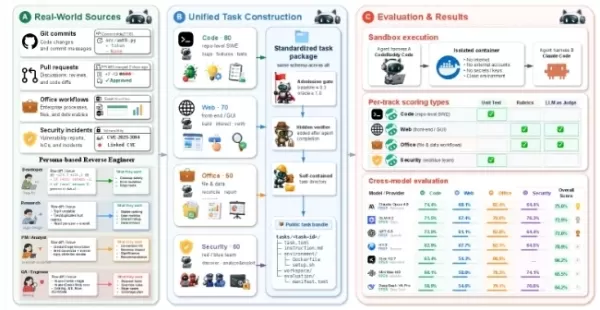
4つのサブセットはすべて統一されたディレクトリ構造を共有していますが、それぞれが異なる検証指標を採用しているため、サブセット間の直接的なスコア比較は無効となります。 その結果、テンセントは総合的なスイートスコアを公開していません。コードタスクは非公開のテスト合格率によって評価されます。ウェブタスクは、ルールチェックとLLM/VLMおよびエージェント評価を組み合わせたもので、インターネットへのライブアクセスなしに、指定されたパスに沿って成果物を納品することが求められます。 オフィスタスクでは、0.70~0.95の重み付けがされた決定論的ルールチェックと、証拠に基づくLLM評価を併用します。また、セキュリティタスクでは、大規模モデルを審査員から除外し、平均値を算出するために3回実行される決定論的なscoring.pyスクリプトに依存しています。 セキュリティサブセットでは、5つの不正防止層が実装されています。具体的には、リテラルスキャンの無効化、入力の名前変更、改ざんされたテストのマスキング、依存関係のエンコード、および重みの低いおとりタスクの使用です。 これには、38のレッドチームタスクと22のブルーチームタスクが含まれており、binutils、curl、nginxにおける実在のCVEに基づいたホワイトボックス監査が含まれています。
タスクの作成は、ソースの収集、正規のリクエストへの書き換え、ワークスペースの構築、実行後の評価アセットの隔離、独立したディレクトリへのパッケージ化という標準化されたパイプラインに従います。ユーザーデータは全工程を通じて変更されません。コードタスクでは5つの異なる役割(開発者、アルゴリズムエンジニア、プロダクトマネージャー、QA、運用)が割り当てられ、セキュリティタスクでは専門家のペルソナが割り当てられます。 意図的に不完全な情報(ターゲットファイル、パターン、境界条件は伏せられている)が提供され、エージェントが独自にコンテキストを取得するよう促します。採点対象のアセットは実行後にのみ開示されるため、エージェントが操作中にそれらに遭遇することはありません。
評価は、モデル環境とサンドボックス環境が分離された隔離されたコンテナ内で行われます。このフレームワークは、CodeBuddy Code(デフォルト)とClaude Codeを利用しており、推論の努力度を高め、20万文字のコンテキストウィンドウを採用する一方で、WebSearchとAskUserQuestionを無効化しています。この制限は極めて重要です。オンライン検索を無効化することで、汚染耐性メカニズムが意図した通りに機能しているかどうかを検証できるからです。
リーダーボードでは、複数のモデルファミリーがランク付けされる(スコア0~100、思考モード、3つの平均値)。Claude Opus4.8は、コード、ウェブ、オフィス、セキュリティの各カテゴリで上位を独占し、5つの1位を獲得した。GLM-5.2は2つのセキュリティカテゴリで首位に立ち、GPT-5.5はオフィスccカテゴリで1位となった。 このフレームワークは、特にセキュリティ分野において高い感度を示しており、平均絶対順位変動は8.6ポイントに達しています。ccフレームワーク下では、Claude Opus4.8が13件の回答を拒否したのに対し、cbc下でのGPT-5.5の拒否件数は2件でした。 効率性に関しては、GPT-5.5は競争力のあるスコアを維持しつつ生成トークン数が最も少ない一方、DeepSeek-V4-Proは高いトークンスループットで44回のコードラウンドを実行しており、よりリソースを多用するアプローチを採用していることがうかがえる。
関連記事
 AI企業が、大規模モデルのコストへの懸念からクライアントが慎重になり、主要なラボへの信頼を失う中、コストを削減している
AIの企業導入が加速する中、トークンコストの高騰により、多くのユーザーが予算制約に直面しています。企業を「利用するほど高額になる」という悪循環から解放するため、AIプロバイダーのWriterは木曜日、フラッグシップモデル「Palmyra X6」を正式にリリースするとともに、基盤となるインテリジェントエージェントランタイム(harness)の主要なアップグレードを行いました。Palmyra X6は、Z.aiのオープンソースモデルGLM-5.2のトレーニング後変種を基盤に構築されています。新しいラ
アップル、ジェミニの噂を明確化:Siri AIは自社開発で構築
2026年世界開発者会議(WWDC)の開催後、Appleはメディアからの問い合わせに対し、新しいAIインフラストラクチャが単なる「Geminiのシェル」に過ぎないという噂について説明を行った。同社は、Apple Foundation Models(AFM)がGoogleのGemini技術のリブランディングではなく、完全に自社で開発され、独立して動作することを明確にした。Appleは、AFMモデルが蒸留およびトレーニングの段階でGoogleのGemini技術を活用している一方で、最終的な出力はAp
OpenAIは依然として、自律的なAIの活動制御に苦戦している
金曜日、OpenAIは「アライメント逸脱レポート」専用のページを公開し、長期にわたって記録された異常な振る舞いの膨大な量を明らかにした。同サイトには現在9件の事例がリストされており、その大半は強化学習(RL)のトレーニングフェーズ中に発生している。この包括的な開示は、同社がこれらの問題に対処するために多大な努力を払っていることを浮き彫りにするが、結論は避けられない:報告された異常エージェントの事例は、これまでの総発生数の一部に過ぎない可能性が高い。「透明性を確保しつつ、ペタバイト単位のエージ
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
これまで、コーディングエージェントは、SWE-benchでのバグ修正やDesign2Codeでのフロントエンドタスクなど、狭い領域に限定されてきた一方で、実運用環境のベンチマークについては、外部からの検証がほぼ不可能な状態が続いていました。 テンセントは、最近のarXiv論文で詳述されたマルチドメイン評価スイート「WorkBuddy Bench」を用いて、このギャップに対処しています。その最大の特徴はタスクの量ではなく、解答の暗記を防止するために明示的に設計されたアーキテクチャにあります。
このベンチマークは、ソフトウェアエンジニアリング(リポジトリレベルのコード)、フロントエンド開発(Webアーティファクト)、業務運営(複数ファイルにわたるオフィスワークフロー)、サイバーセキュリティ(レッドチームおよびブルーチームのシナリオ)という4つの専門分野を網羅しています。 このスイートは、それぞれ80、70、50、60のタスクで構成され、合計260タスクとなる。 重要な点として、どのタスクも公開されている問題バンクに由来するものではなく、実際のコードコミット、プルリクエスト、あるいはビジネスコンテキストからリバースエンジニアリングされ、簡潔で口語的なロールプレイ形式のプロンプトに言い換えられています。 このアプローチにより、対応するプルリクエストやコミットの手がかりをオンラインで検索しても結果が得られなくなり、暗記を効果的に阻止します。ディレクトリ、環境イメージ、評価ツール、テストケース、参照ソリューションを含むデータセットは完全に公開されているため、その汚染耐性は、隠蔽性ではなく、この構築方法とバージョン管理に依存しています。
4つのサブセットはすべて統一されたディレクトリ構造を共有していますが、それぞれが異なる検証指標を採用しているため、サブセット間の直接的なスコア比較は無効となります。 その結果、テンセントは総合的なスイートスコアを公開していません。コードタスクは非公開のテスト合格率によって評価されます。ウェブタスクは、ルールチェックとLLM/VLMおよびエージェント評価を組み合わせたもので、インターネットへのライブアクセスなしに、指定されたパスに沿って成果物を納品することが求められます。 オフィスタスクでは、0.70~0.95の重み付けがされた決定論的ルールチェックと、証拠に基づくLLM評価を併用します。また、セキュリティタスクでは、大規模モデルを審査員から除外し、平均値を算出するために3回実行される決定論的なscoring.pyスクリプトに依存しています。 セキュリティサブセットでは、5つの不正防止層が実装されています。具体的には、リテラルスキャンの無効化、入力の名前変更、改ざんされたテストのマスキング、依存関係のエンコード、および重みの低いおとりタスクの使用です。 これには、38のレッドチームタスクと22のブルーチームタスクが含まれており、binutils、curl、nginxにおける実在のCVEに基づいたホワイトボックス監査が含まれています。
タスクの作成は、ソースの収集、正規のリクエストへの書き換え、ワークスペースの構築、実行後の評価アセットの隔離、独立したディレクトリへのパッケージ化という標準化されたパイプラインに従います。ユーザーデータは全工程を通じて変更されません。コードタスクでは5つの異なる役割(開発者、アルゴリズムエンジニア、プロダクトマネージャー、QA、運用)が割り当てられ、セキュリティタスクでは専門家のペルソナが割り当てられます。 意図的に不完全な情報(ターゲットファイル、パターン、境界条件は伏せられている)が提供され、エージェントが独自にコンテキストを取得するよう促します。採点対象のアセットは実行後にのみ開示されるため、エージェントが操作中にそれらに遭遇することはありません。
評価は、モデル環境とサンドボックス環境が分離された隔離されたコンテナ内で行われます。このフレームワークは、CodeBuddy Code(デフォルト)とClaude Codeを利用しており、推論の努力度を高め、20万文字のコンテキストウィンドウを採用する一方で、WebSearchとAskUserQuestionを無効化しています。この制限は極めて重要です。オンライン検索を無効化することで、汚染耐性メカニズムが意図した通りに機能しているかどうかを検証できるからです。
リーダーボードでは、複数のモデルファミリーがランク付けされる(スコア0~100、思考モード、3つの平均値)。Claude Opus4.8は、コード、ウェブ、オフィス、セキュリティの各カテゴリで上位を独占し、5つの1位を獲得した。GLM-5.2は2つのセキュリティカテゴリで首位に立ち、GPT-5.5はオフィスccカテゴリで1位となった。 このフレームワークは、特にセキュリティ分野において高い感度を示しており、平均絶対順位変動は8.6ポイントに達しています。ccフレームワーク下では、Claude Opus4.8が13件の回答を拒否したのに対し、cbc下でのGPT-5.5の拒否件数は2件でした。 効率性に関しては、GPT-5.5は競争力のあるスコアを維持しつつ生成トークン数が最も少ない一方、DeepSeek-V4-Proは高いトークンスループットで44回のコードラウンドを実行しており、よりリソースを多用するアプローチを採用していることがうかがえる。








 AI企業が、大規模モデルのコストへの懸念からクライアントが慎重になり、主要なラボへの信頼を失う中、コストを削減している
AIの企業導入が加速する中、トークンコストの高騰により、多くのユーザーが予算制約に直面しています。企業を「利用するほど高額になる」という悪循環から解放するため、AIプロバイダーのWriterは木曜日、フラッグシップモデル「Palmyra X6」を正式にリリースするとともに、基盤となるインテリジェントエージェントランタイム(harness)の主要なアップグレードを行いました。Palmyra X6は、Z.aiのオープンソースモデルGLM-5.2のトレーニング後変種を基盤に構築されています。新しいラ
 アップル、ジェミニの噂を明確化:Siri AIは自社開発で構築
2026年世界開発者会議(WWDC)の開催後、Appleはメディアからの問い合わせに対し、新しいAIインフラストラクチャが単なる「Geminiのシェル」に過ぎないという噂について説明を行った。同社は、Apple Foundation Models(AFM)がGoogleのGemini技術のリブランディングではなく、完全に自社で開発され、独立して動作することを明確にした。Appleは、AFMモデルが蒸留およびトレーニングの段階でGoogleのGemini技術を活用している一方で、最終的な出力はAp
 OpenAIは依然として、自律的なAIの活動制御に苦戦している
金曜日、OpenAIは「アライメント逸脱レポート」専用のページを公開し、長期にわたって記録された異常な振る舞いの膨大な量を明らかにした。同サイトには現在9件の事例がリストされており、その大半は強化学習(RL)のトレーニングフェーズ中に発生している。この包括的な開示は、同社がこれらの問題に対処するために多大な努力を払っていることを浮き彫りにするが、結論は避けられない:報告された異常エージェントの事例は、これまでの総発生数の一部に過ぎない可能性が高い。「透明性を確保しつつ、ペタバイト単位のエージ

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












