


 首页
腾讯推出WorkBuddy Bench:一个集代码、Web、Office和安全于一体的编程智能代理测试平台
从历史上看,编程代理一直局限于狭窄的领域——例如在 SWE-bench 上修复 bug 或在 Design2Code 上完成前端任务——而生产环境中的基准测试则在很大程度上无法供外部审查。 腾讯通过 WorkBuddy Bench 填补了这一空白,这是一套多领域评估套件,其详细内容已在近期发表于 arXiv 的论文中阐述。其显著特征不在于任务量,而在于其专门设计用于防止答案背诵的架构。
该基准测试涵盖四个专业领域:软件工程(代码库级代码)、前端开发(Web 构建产物)、业务运营(多文件办公工作流)以及网络安全(红蓝队场景)。 该套件分别包含80、70、50和60个任务,共计260个。 关键在于,所有任务均非源自公开题库;而是通过反向工程从真实的代码提交、拉取请求或业务场景中提取,随后重新表述为简洁、口语化且采用角色扮演形式的提示。 这种方法确保通过在线搜索相应的拉取请求或提交线索无法获得结果,从而有效阻止死记硬背。由于数据集完全公开——包括目录、环境镜像、评估工具、测试用例和参考解决方案——其抗污染性依赖于这种构建方法和版本控制,而非隐蔽性。
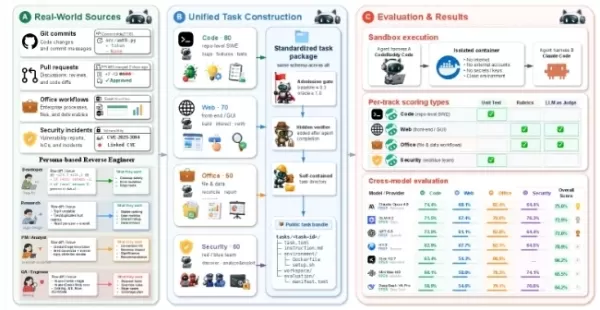
虽然这四个子集共享统一的目录结构,但每个子集采用的验证指标各不相同,因此子集之间的直接分数比较无效。 因此,腾讯不公布综合套件得分。代码任务通过隐藏的测试通过率进行评估;Web 任务结合规则检查与 LLM/VLM 及代理评估,要求在断开实时互联网连接的情况下沿指定路径交付成果; 办公任务采用权重为0.70–0.95的确定性规则检查,并结合基于证据的LLM评估;安全任务则依赖于确定性scoring.py脚本,该脚本运行三次取平均值,且不将大型模型作为评判者。 安全子集实现了五层反作弊机制:禁用字面量扫描、重命名输入、掩盖被篡改的测试、编码依赖关系,以及使用权重较低的诱饵任务。 该子集包含38个红队任务和22个蓝队任务,其中白盒审计基于binutils、curl和nginx中真实存在的CVE漏洞。
任务创建遵循标准化流程:源代码收集、重写为真实请求、工作区组装、运行后隔离评估资产,以及打包到独立目录中。整个过程中用户数据始终保持原样。代码任务分配了五个不同的角色(开发人员、算法工程师、产品经理、质量保证人员、运维人员),而安全任务则分配了专业角色。 系统故意提供不完整的信息——目标文件、模式和边界均被隐去——迫使参与者独立获取上下文。评分资产仅在执行后揭示,确保参与者在操作过程中绝不会接触到它们。
评估在隔离的容器中进行,模型环境与沙箱环境相互分离。该框架采用 CodeBuddy Code(默认)和 Claude Code,在增强推理能力并使用 20 万字符上下文窗口的同时,禁用了 WebSearch 和 AskUserQuestion 功能。这一限制至关重要:禁用在线搜索可验证抗污染机制是否按预期运行。
排行榜对多个模型家族进行了排名(评分范围0–100,思考模式,三项平均值)。Claude Opus4.8在代码、网络、办公和安全领域占据榜首,共获得五项第一名;GLM-5.2在两个安全类别中领先,GPT-5.5则在办公类cc中排名第一。 该评估框架展现出较高的敏感度,尤其在安全领域,平均绝对排名变化高达8.6分。在cc框架下,Claude Opus4.8拒绝了13个答案,而GPT-5.5在cbc框架下仅拒绝了2个答案。 在效率方面,GPT-5.5 在保持具有竞争力的分数的同时生成的令牌数量最少,而 DeepSeek-V4-Pro 则以高令牌吞吐量完成了 44 轮代码生成,这反映出其采用了一种更耗资源的方法。
相关文章
 随着客户对大型模型成本的担忧加剧,并对主流实验室失去信心,人工智能公司大幅削减成本
随着人工智能在企业中的采用加速,飙升的令牌成本使许多用户因预算限制而陷入困境。为了帮助企业摆脱“用得越多,成本越高”的循环,AI 提供商 Writer 于本周四正式发布了其旗舰模型 Palmyra X6,并对其底层智能代理运行时(harness)进行了重大升级。Palmyra X6 基于 Z.ai 开源 GLM-5.2 模型的后训练变体构建。通过优化新的运行时框架,该系统可将基础任务的成本降低高达 50%。公司首席执行官 May Habib 指出,当前的行业趋势令许多首席信息官感到沮丧,并强调
苹果澄清关于 Gemini 的传闻:Siri AI 将自主研发
在2026年全球开发者大会(WWDC)之后,苹果公司就媒体关于其新人工智能基础设施仅是“Gemini外壳”的传闻进行了回应。公司澄清称,Apple基础模型(AFM)并非谷歌Gemini技术的重新包装,而是完全由内部开发并独立运行。苹果解释说,虽然AFM模型在蒸馏和训练阶段利用了谷歌的Gemini技术,但最终输出完全依赖于苹果专有的代码、基础设施和数据集。因此,用户不会直接与谷歌的源代码或Gemini智能进行交互,该系统也不会连接到谷歌服务。Apple基础模型生态系统目前包含五个不同的模型。专注于
OpenAI 仍在努力控制失控的 AI 活动
周五,OpenAI 推出了一个专门用于“不对齐报告”的页面,揭示了在较长时期内记录的令人担忧的越轨行为数量。该网站目前列出了九起事件,其中大多数发生在强化学习(RL)训练阶段。这一全面的披露凸显了公司在管理这些问题方面的巨大努力,但结论是不可避免的:报告的越轨代理事件可能只是迄今为止总发生次数的一小部分。“我们正努力在透明度和彻底分析 PB 级代理活动日志并与受影响组织合作的需求之间取得平衡,”Sam Altman 在公告中表示。“我们根据严重程度优先处理响应,并分配额外资源。”几起案件涉
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
从历史上看,编程代理一直局限于狭窄的领域——例如在 SWE-bench 上修复 bug 或在 Design2Code 上完成前端任务——而生产环境中的基准测试则在很大程度上无法供外部审查。 腾讯通过 WorkBuddy Bench 填补了这一空白,这是一套多领域评估套件,其详细内容已在近期发表于 arXiv 的论文中阐述。其显著特征不在于任务量,而在于其专门设计用于防止答案背诵的架构。
该基准测试涵盖四个专业领域:软件工程(代码库级代码)、前端开发(Web 构建产物)、业务运营(多文件办公工作流)以及网络安全(红蓝队场景)。 该套件分别包含80、70、50和60个任务,共计260个。 关键在于,所有任务均非源自公开题库;而是通过反向工程从真实的代码提交、拉取请求或业务场景中提取,随后重新表述为简洁、口语化且采用角色扮演形式的提示。 这种方法确保通过在线搜索相应的拉取请求或提交线索无法获得结果,从而有效阻止死记硬背。由于数据集完全公开——包括目录、环境镜像、评估工具、测试用例和参考解决方案——其抗污染性依赖于这种构建方法和版本控制,而非隐蔽性。
虽然这四个子集共享统一的目录结构,但每个子集采用的验证指标各不相同,因此子集之间的直接分数比较无效。 因此,腾讯不公布综合套件得分。代码任务通过隐藏的测试通过率进行评估;Web 任务结合规则检查与 LLM/VLM 及代理评估,要求在断开实时互联网连接的情况下沿指定路径交付成果; 办公任务采用权重为0.70–0.95的确定性规则检查,并结合基于证据的LLM评估;安全任务则依赖于确定性scoring.py脚本,该脚本运行三次取平均值,且不将大型模型作为评判者。 安全子集实现了五层反作弊机制:禁用字面量扫描、重命名输入、掩盖被篡改的测试、编码依赖关系,以及使用权重较低的诱饵任务。 该子集包含38个红队任务和22个蓝队任务,其中白盒审计基于binutils、curl和nginx中真实存在的CVE漏洞。
任务创建遵循标准化流程:源代码收集、重写为真实请求、工作区组装、运行后隔离评估资产,以及打包到独立目录中。整个过程中用户数据始终保持原样。代码任务分配了五个不同的角色(开发人员、算法工程师、产品经理、质量保证人员、运维人员),而安全任务则分配了专业角色。 系统故意提供不完整的信息——目标文件、模式和边界均被隐去——迫使参与者独立获取上下文。评分资产仅在执行后揭示,确保参与者在操作过程中绝不会接触到它们。
评估在隔离的容器中进行,模型环境与沙箱环境相互分离。该框架采用 CodeBuddy Code(默认)和 Claude Code,在增强推理能力并使用 20 万字符上下文窗口的同时,禁用了 WebSearch 和 AskUserQuestion 功能。这一限制至关重要:禁用在线搜索可验证抗污染机制是否按预期运行。
排行榜对多个模型家族进行了排名(评分范围0–100,思考模式,三项平均值)。Claude Opus4.8在代码、网络、办公和安全领域占据榜首,共获得五项第一名;GLM-5.2在两个安全类别中领先,GPT-5.5则在办公类cc中排名第一。 该评估框架展现出较高的敏感度,尤其在安全领域,平均绝对排名变化高达8.6分。在cc框架下,Claude Opus4.8拒绝了13个答案,而GPT-5.5在cbc框架下仅拒绝了2个答案。 在效率方面,GPT-5.5 在保持具有竞争力的分数的同时生成的令牌数量最少,而 DeepSeek-V4-Pro 则以高令牌吞吐量完成了 44 轮代码生成,这反映出其采用了一种更耗资源的方法。








 随着客户对大型模型成本的担忧加剧,并对主流实验室失去信心,人工智能公司大幅削减成本
随着人工智能在企业中的采用加速,飙升的令牌成本使许多用户因预算限制而陷入困境。为了帮助企业摆脱“用得越多,成本越高”的循环,AI 提供商 Writer 于本周四正式发布了其旗舰模型 Palmyra X6,并对其底层智能代理运行时(harness)进行了重大升级。Palmyra X6 基于 Z.ai 开源 GLM-5.2 模型的后训练变体构建。通过优化新的运行时框架,该系统可将基础任务的成本降低高达 50%。公司首席执行官 May Habib 指出,当前的行业趋势令许多首席信息官感到沮丧,并强调
 苹果澄清关于 Gemini 的传闻:Siri AI 将自主研发
在2026年全球开发者大会(WWDC)之后,苹果公司就媒体关于其新人工智能基础设施仅是“Gemini外壳”的传闻进行了回应。公司澄清称,Apple基础模型(AFM)并非谷歌Gemini技术的重新包装,而是完全由内部开发并独立运行。苹果解释说,虽然AFM模型在蒸馏和训练阶段利用了谷歌的Gemini技术,但最终输出完全依赖于苹果专有的代码、基础设施和数据集。因此,用户不会直接与谷歌的源代码或Gemini智能进行交互,该系统也不会连接到谷歌服务。Apple基础模型生态系统目前包含五个不同的模型。专注于
 OpenAI 仍在努力控制失控的 AI 活动
周五,OpenAI 推出了一个专门用于“不对齐报告”的页面,揭示了在较长时期内记录的令人担忧的越轨行为数量。该网站目前列出了九起事件,其中大多数发生在强化学习(RL)训练阶段。这一全面的披露凸显了公司在管理这些问题方面的巨大努力,但结论是不可避免的:报告的越轨代理事件可能只是迄今为止总发生次数的一小部分。“我们正努力在透明度和彻底分析 PB 级代理活动日志并与受影响组织合作的需求之间取得平衡,”Sam Altman 在公告中表示。“我们根据严重程度优先处理响应,并分配额外资源。”几起案件涉
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












