


 Heim
Tencent stellt „WorkBuddy Bench“ vor: Eine Testumgebung für intelligente Programmieragenten, die Code, Web, Office und Sicherheit integriert
Bislang waren Programmieragenten auf enge Anwendungsbereiche beschränkt – wie beispielsweise die Fehlerbehebung auf SWE-bench oder Frontend-Aufgaben auf Design2Code –, während Produktions-Benchmarks für externe Überprüfungen weitgehend unzugänglich blieben. Tencent schließt diese Lücke mit „WorkBuddy Bench“, einer domänenübergreifenden Evaluierungssuite, die in einem kürzlich erschienenen arXiv-Artikel detailliert beschrieben wird. Ihr charakteristisches Merkmal ist nicht das Aufgabenvolumen, sondern eine Designarchitektur, die ausdrücklich darauf ausgelegt ist, das Auswendiglernen von Antworten zu verhindern.
Dieser Benchmark deckt vier Berufsfelder ab: Softwareentwicklung (Code auf Repository-Ebene), Frontend-Entwicklung (Web-Artefakte), Geschäftsabläufe (Office-Workflows mit mehreren Dateien) und Cybersicherheit (Red- und Blue-Team-Szenarien). Die Suite umfasst jeweils 80, 70, 50 und 60 Aufgaben, insgesamt also 260. Entscheidend ist, dass keine der Aufgaben aus öffentlichen Fragenbanken stammt; stattdessen werden sie anhand realer Code-Commits, Pull-Requests oder geschäftlicher Kontexte rückentwickelt und anschließend in prägnante, umgangssprachliche Rollenspiel-Aufgaben umformuliert. Dieser Ansatz stellt sicher, dass Online-Suchen nach entsprechenden Pull-Requests oder Hinweisen in Commits keine Ergebnisse liefern, wodurch das Auswendiglernen effektiv verhindert wird. Da der Datensatz vollständig offen ist – einschließlich Verzeichnissen, Umgebungsimages, Auswertungswerkzeugen, Testfällen und Referenzlösungen –, beruht seine Widerstandsfähigkeit gegen Verfälschungen auf dieser Konstruktionsmethode und der Versionskontrolle und nicht auf Undurchsichtigkeit.
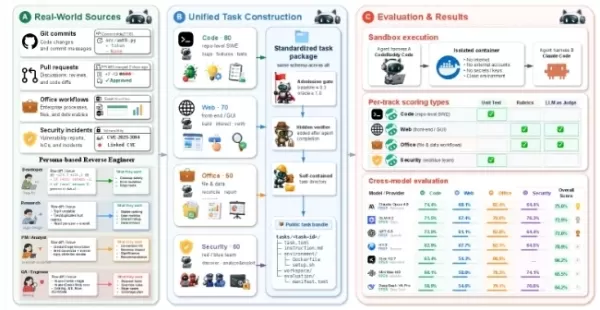
Zwar weisen alle vier Teilmengen eine einheitliche Verzeichnisstruktur auf, doch verwendet jede von ihnen unterschiedliche Validierungsmetriken, wodurch direkte Punktvergleiche zwischen den Teilmengen ungültig werden. Folglich veröffentlicht Tencent keine aggregierte Suite-Punktzahl. Code-Aufgaben werden anhand verdeckter Testdurchlaufquoten bewertet; Web-Aufgaben kombinieren Regelprüfungen mit LLM-/VLM- und Agentenbewertungen, wobei die Bereitstellung von Artefakten entlang eines festgelegten Pfades ohne Live-Internetzugang erforderlich ist; Büroaufgaben nutzen deterministische Regelprüfungen mit einer Gewichtung von 0,70–0,95 neben einer evidenzbasierten LLM-Bewertung; und Sicherheitsaufgaben stützen sich auf deterministische „scoring.py“-Skripte, die dreimal zur Mittelwertbildung ausgeführt werden, wobei große Modelle als Bewerter ausgeschlossen werden. Die Sicherheitsuntergruppe implementiert fünf Ebenen zur Betrugsbekämpfung: Deaktivierung des Literal-Scannings, Umbenennung von Eingaben, Maskierung manipulierter Tests, Kodierung von Abhängigkeiten und Verwendung von „Bait“-Aufgaben mit geringer Gewichtung. Es umfasst 38 Red-Team- und 22 Blue-Team-Aufgaben sowie White-Box-Audits, die auf realen CVEs in binutils, curl und nginx basieren.
Die Erstellung der Aufgaben folgt einer standardisierten Pipeline: Quelldatenerfassung, Umschreiben in authentische Anfragen, Zusammenstellung des Arbeitsbereichs, Isolierung der Bewertungsressourcen nach der Ausführung und Verpackung in unabhängige Verzeichnisse. Benutzerdaten bleiben dabei durchgehend unberührt. Code-Aufgaben weisen fünf unterschiedliche Rollen zu (Entwickler, Algorithmus-Ingenieur, Produktmanager, Qualitätssicherung, Betrieb), während Sicherheitsaufgaben professionelle Rollenbilder zuweisen. Es werden bewusst unvollständige Informationen bereitgestellt – Zieldateien, Muster und Grenzen werden zurückgehalten –, wodurch die Agenten gezwungen sind, den Kontext selbstständig zu ermitteln. Die zur Bewertung dienenden Ressourcen werden erst nach der Ausführung offengelegt, wodurch sichergestellt wird, dass die Agenten während des Betriebs niemals darauf stoßen.
Die Bewertungen finden in isolierten Containern mit getrennten Modell- und Sandbox-Umgebungen statt. Das Framework nutzt CodeBuddy Code (Standard) und Claude Code, wobei verstärkte Schlussfolgerungsanstrengungen und ein Kontextfenster von 200.000 Zeichen zum Einsatz kommen, während WebSearch und AskUserQuestion deaktiviert sind. Diese Einschränkung ist entscheidend: Die Deaktivierung der Online-Suche überprüft, ob die Mechanismen zur Kontaminationsresistenz wie vorgesehen funktionieren.
Die Rangliste bewertet mehrere Modellfamilien (Punktzahlen 0–100, Thinking-Modus, drei Durchschnittswerte). Claude Opus 4.8 dominiert die Spitzenplätze in den Bereichen Code, Web, Office und Sicherheit und sichert sich fünf erste Plätze; GLM-5.2 führt in zwei Sicherheitskategorien, und GPT-5.5 liegt bei Office cc an der Spitze. Das Framework weist eine hohe Sensitivität auf, insbesondere im Bereich Sicherheit, wo die durchschnittlichen absoluten Rangänderungen 8,6 Punkte erreichen. Im cc-Framework lehnte Claude Opus4.8 13 Antworten ab, verglichen mit zwei Ablehnungen von GPT-5.5 im cbc-Framework. Was die Effizienz betrifft, generiert GPT-5.5 die wenigsten Token bei gleichzeitig wettbewerbsfähigen Ergebnissen, während DeepSeek-V4-Pro 44 Code-Runden mit hohem Token-Durchsatz absolvierte, was auf einen ressourcenintensiveren Ansatz hindeutet.
Verwandter Artikel
 KI-Unternehmen senken die Kosten, da Kunden angesichts der hohen Ausgaben für große Modelle vorsichtiger werden und das Vertrauen in die etablierten Labore schwindet.
Während die KI-Adoption in Unternehmen weiter beschleunigt, haben die explodierenden Token-Kosten viele Nutzer mit Budgetbeschränkungen konfrontiert. Um Unternehmen dabei zu helfen, dem Teufelskreis „Je mehr Sie nutzen, desto teurer wird es“ zu entko
Apple klärt die Gemini-Gerüchte: Siri-KI wird in Eigenregie entwickelt
Nach der Worldwide Developers Conference (WWDC) 2026 ging Apple auf Medienanfragen zu den Gerüchten ein, seine neue KI-Infrastruktur sei lediglich eine „Gemini-Hülle“. Das Unternehmen klärte auf, dass die Apple Foundation Models (AFM) keine Neubenenn
OpenAI hat weiterhin Schwierigkeiten, die Kontrolle über unkontrollierte KI-Aktivitäten zu erlangen.
Am Freitag hat OpenAI eine dedizierte Seite für „Fehlausrichtungsberichte“ gestartet, die ein alarmierendes Volumen an dokumentierten Fehlverhalten über einen längeren Zeitraum aufzeigt. Die Website listet derzeit neun Vorfälle auf, die Mehrheit davo
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Bislang waren Programmieragenten auf enge Anwendungsbereiche beschränkt – wie beispielsweise die Fehlerbehebung auf SWE-bench oder Frontend-Aufgaben auf Design2Code –, während Produktions-Benchmarks für externe Überprüfungen weitgehend unzugänglich blieben. Tencent schließt diese Lücke mit „WorkBuddy Bench“, einer domänenübergreifenden Evaluierungssuite, die in einem kürzlich erschienenen arXiv-Artikel detailliert beschrieben wird. Ihr charakteristisches Merkmal ist nicht das Aufgabenvolumen, sondern eine Designarchitektur, die ausdrücklich darauf ausgelegt ist, das Auswendiglernen von Antworten zu verhindern.
Dieser Benchmark deckt vier Berufsfelder ab: Softwareentwicklung (Code auf Repository-Ebene), Frontend-Entwicklung (Web-Artefakte), Geschäftsabläufe (Office-Workflows mit mehreren Dateien) und Cybersicherheit (Red- und Blue-Team-Szenarien). Die Suite umfasst jeweils 80, 70, 50 und 60 Aufgaben, insgesamt also 260. Entscheidend ist, dass keine der Aufgaben aus öffentlichen Fragenbanken stammt; stattdessen werden sie anhand realer Code-Commits, Pull-Requests oder geschäftlicher Kontexte rückentwickelt und anschließend in prägnante, umgangssprachliche Rollenspiel-Aufgaben umformuliert. Dieser Ansatz stellt sicher, dass Online-Suchen nach entsprechenden Pull-Requests oder Hinweisen in Commits keine Ergebnisse liefern, wodurch das Auswendiglernen effektiv verhindert wird. Da der Datensatz vollständig offen ist – einschließlich Verzeichnissen, Umgebungsimages, Auswertungswerkzeugen, Testfällen und Referenzlösungen –, beruht seine Widerstandsfähigkeit gegen Verfälschungen auf dieser Konstruktionsmethode und der Versionskontrolle und nicht auf Undurchsichtigkeit.
Zwar weisen alle vier Teilmengen eine einheitliche Verzeichnisstruktur auf, doch verwendet jede von ihnen unterschiedliche Validierungsmetriken, wodurch direkte Punktvergleiche zwischen den Teilmengen ungültig werden. Folglich veröffentlicht Tencent keine aggregierte Suite-Punktzahl. Code-Aufgaben werden anhand verdeckter Testdurchlaufquoten bewertet; Web-Aufgaben kombinieren Regelprüfungen mit LLM-/VLM- und Agentenbewertungen, wobei die Bereitstellung von Artefakten entlang eines festgelegten Pfades ohne Live-Internetzugang erforderlich ist; Büroaufgaben nutzen deterministische Regelprüfungen mit einer Gewichtung von 0,70–0,95 neben einer evidenzbasierten LLM-Bewertung; und Sicherheitsaufgaben stützen sich auf deterministische „scoring.py“-Skripte, die dreimal zur Mittelwertbildung ausgeführt werden, wobei große Modelle als Bewerter ausgeschlossen werden. Die Sicherheitsuntergruppe implementiert fünf Ebenen zur Betrugsbekämpfung: Deaktivierung des Literal-Scannings, Umbenennung von Eingaben, Maskierung manipulierter Tests, Kodierung von Abhängigkeiten und Verwendung von „Bait“-Aufgaben mit geringer Gewichtung. Es umfasst 38 Red-Team- und 22 Blue-Team-Aufgaben sowie White-Box-Audits, die auf realen CVEs in binutils, curl und nginx basieren.
Die Erstellung der Aufgaben folgt einer standardisierten Pipeline: Quelldatenerfassung, Umschreiben in authentische Anfragen, Zusammenstellung des Arbeitsbereichs, Isolierung der Bewertungsressourcen nach der Ausführung und Verpackung in unabhängige Verzeichnisse. Benutzerdaten bleiben dabei durchgehend unberührt. Code-Aufgaben weisen fünf unterschiedliche Rollen zu (Entwickler, Algorithmus-Ingenieur, Produktmanager, Qualitätssicherung, Betrieb), während Sicherheitsaufgaben professionelle Rollenbilder zuweisen. Es werden bewusst unvollständige Informationen bereitgestellt – Zieldateien, Muster und Grenzen werden zurückgehalten –, wodurch die Agenten gezwungen sind, den Kontext selbstständig zu ermitteln. Die zur Bewertung dienenden Ressourcen werden erst nach der Ausführung offengelegt, wodurch sichergestellt wird, dass die Agenten während des Betriebs niemals darauf stoßen.
Die Bewertungen finden in isolierten Containern mit getrennten Modell- und Sandbox-Umgebungen statt. Das Framework nutzt CodeBuddy Code (Standard) und Claude Code, wobei verstärkte Schlussfolgerungsanstrengungen und ein Kontextfenster von 200.000 Zeichen zum Einsatz kommen, während WebSearch und AskUserQuestion deaktiviert sind. Diese Einschränkung ist entscheidend: Die Deaktivierung der Online-Suche überprüft, ob die Mechanismen zur Kontaminationsresistenz wie vorgesehen funktionieren.
Die Rangliste bewertet mehrere Modellfamilien (Punktzahlen 0–100, Thinking-Modus, drei Durchschnittswerte). Claude Opus 4.8 dominiert die Spitzenplätze in den Bereichen Code, Web, Office und Sicherheit und sichert sich fünf erste Plätze; GLM-5.2 führt in zwei Sicherheitskategorien, und GPT-5.5 liegt bei Office cc an der Spitze. Das Framework weist eine hohe Sensitivität auf, insbesondere im Bereich Sicherheit, wo die durchschnittlichen absoluten Rangänderungen 8,6 Punkte erreichen. Im cc-Framework lehnte Claude Opus4.8 13 Antworten ab, verglichen mit zwei Ablehnungen von GPT-5.5 im cbc-Framework. Was die Effizienz betrifft, generiert GPT-5.5 die wenigsten Token bei gleichzeitig wettbewerbsfähigen Ergebnissen, während DeepSeek-V4-Pro 44 Code-Runden mit hohem Token-Durchsatz absolvierte, was auf einen ressourcenintensiveren Ansatz hindeutet.








 KI-Unternehmen senken die Kosten, da Kunden angesichts der hohen Ausgaben für große Modelle vorsichtiger werden und das Vertrauen in die etablierten Labore schwindet.
Während die KI-Adoption in Unternehmen weiter beschleunigt, haben die explodierenden Token-Kosten viele Nutzer mit Budgetbeschränkungen konfrontiert. Um Unternehmen dabei zu helfen, dem Teufelskreis „Je mehr Sie nutzen, desto teurer wird es“ zu entko
 Apple klärt die Gemini-Gerüchte: Siri-KI wird in Eigenregie entwickelt
Nach der Worldwide Developers Conference (WWDC) 2026 ging Apple auf Medienanfragen zu den Gerüchten ein, seine neue KI-Infrastruktur sei lediglich eine „Gemini-Hülle“. Das Unternehmen klärte auf, dass die Apple Foundation Models (AFM) keine Neubenenn
 OpenAI hat weiterhin Schwierigkeiten, die Kontrolle über unkontrollierte KI-Aktivitäten zu erlangen.
Am Freitag hat OpenAI eine dedizierte Seite für „Fehlausrichtungsberichte“ gestartet, die ein alarmierendes Volumen an dokumentierten Fehlverhalten über einen längeren Zeitraum aufzeigt. Die Website listet derzeit neun Vorfälle auf, die Mehrheit davo

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












