


 Hogar
Tencent presenta WorkBuddy Bench: un entorno de pruebas para agentes inteligentes de programación integrado con Code, Web, Office y Seguridad
Históricamente, los agentes de programación se han limitado a ámbitos muy concretos —como la corrección de errores en SWE-bench o las tareas de front-end en Design2Code—, mientras que las pruebas de rendimiento en entorno de producción siguen siendo, en gran medida, inaccesibles para la revisión externa. Tencent aborda esta carencia con WorkBuddy Bench, un conjunto de pruebas de evaluación multidominio que se detalla en un artículo reciente publicado en arXiv. Su característica definitoria no es el volumen de tareas, sino una arquitectura de diseño concebida expresamente para impedir la memorización de respuestas.
Esta prueba de rendimiento abarca cuatro ámbitos profesionales: ingeniería de software (código a nivel de repositorio), desarrollo front-end (artefactos web), operaciones empresariales (flujos de trabajo de oficina con múltiples archivos) y ciberseguridad (escenarios de equipos rojo y azul). El conjunto comprende 80, 70, 50 y 60 tareas respectivamente, lo que suma un total de 260. Es fundamental destacar que ninguna de las tareas procede de bancos de preguntas públicos; en su lugar, se han obtenido mediante ingeniería inversa a partir de commits de código reales, pull requests o contextos empresariales, y posteriormente se han reformulado en indicaciones concisas, coloquiales y basadas en juegos de rol. Este enfoque garantiza que las búsquedas en línea de las solicitudes de incorporación de cambios (PR) correspondientes o de pistas en las confirmaciones no arrojen resultados, lo que impide de forma efectiva la memorización. Dado que el conjunto de datos es totalmente abierto —incluidos los directorios, las imágenes de entorno, las herramientas de evaluación, los casos de prueba y las soluciones de referencia—, su resistencia a la contaminación se basa en este método de construcción y en el control de versiones, más que en la opacidad.
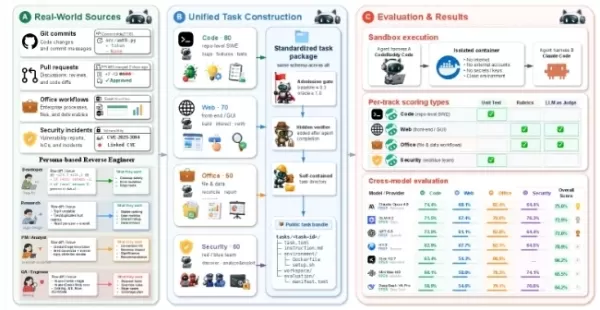
Aunque los cuatro subconjuntos comparten una estructura de directorios unificada, cada uno emplea métricas de validación distintas, lo que hace que las comparaciones directas de puntuaciones entre subconjuntos no sean válidas. En consecuencia, Tencent no publica una puntuación global del conjunto de pruebas. Las tareas de código se evalúan mediante tasas de superación de pruebas ocultas; las tareas web combinan comprobaciones de reglas con evaluaciones de LLM/VLM y de agentes, lo que requiere la entrega de artefactos a lo largo de una ruta especificada sin acceso a Internet en tiempo real; las tareas de oficina utilizan comprobaciones de reglas determinísticas ponderadas entre 0,70 y 0,95, junto con una evaluación de LLM basada en pruebas; y las tareas de seguridad se basan en scripts «scoring.py» determinísticos que se ejecutan tres veces para calcular la media, excluyendo los modelos grandes como evaluadores. El subconjunto de seguridad implementa cinco capas contra las trampas: desactivación del escaneo literal, renombramiento de entradas, enmascaramiento de pruebas manipuladas, codificación de dependencias y uso de tareas «cebo» de baja ponderación. Incluye 38 tareas de equipo rojo y 22 de equipo azul, con auditorías de caja abierta basadas en CVE del mundo real en binutils, curl y nginx.
La creación de tareas sigue un proceso estandarizado: recopilación de fuentes, reescritura en forma de peticiones auténticas, montaje del espacio de trabajo, aislamiento de los activos de evaluación tras la ejecución y empaquetado en directorios independientes. Los datos de los usuarios permanecen intactos en todo momento. Las tareas de código asignan cinco roles distintos (desarrollador, ingeniero de algoritmos, gestor de producto, control de calidad y operaciones), mientras que las tareas de seguridad asignan perfiles profesionales. Se proporciona información deliberadamente incompleta —se ocultan los archivos de destino, los patrones y los límites—, lo que obliga a los agentes a obtener el contexto de forma independiente. Los activos de puntuación solo se revelan tras la ejecución, lo que garantiza que los agentes nunca se encuentren con ellos durante la operación.
Las evaluaciones se llevan a cabo en contenedores aislados con entornos de modelo y sandbox separados. El marco utiliza CodeBuddy Code (por defecto) y Claude Code, empleando mayores esfuerzos de razonamiento y una ventana de contexto de 200 000, al tiempo que desactiva WebSearch y AskUserQuestion. Esta restricción es fundamental: desactivar la búsqueda en línea verifica si los mecanismos de resistencia a la contaminación funcionan según lo previsto.
La tabla de clasificación ordena varias familias de modelos (puntuaciones de 0 a 100, modo de razonamiento, tres medias). Claude Opus4.8 domina las primeras posiciones en las categorías de código, web, oficina y seguridad, consiguiendo cinco primeros puestos; GLM-5.2 lidera dos categorías de seguridad, y GPT-5.5 encabeza la categoría de oficina cc. El marco demuestra una alta sensibilidad, especialmente en seguridad, donde los cambios medios absolutos en la clasificación alcanzan los 8,6 puntos. En el marco «cc», Claude Opus4.8 rechazó 13 respuestas, frente a los dos rechazos de GPT-5.5 en el marco «cbc». En cuanto a la eficiencia, GPT-5.5 genera el menor número de tokens al tiempo que mantiene puntuaciones competitivas, mientras que DeepSeek-V4-Pro ejecutó 44 rondas de código con un alto rendimiento de tokens, lo que refleja un enfoque que consume más recursos.
Artículo relacionado
 Las empresas de inteligencia artificial reducen costos a medida que los clientes se vuelven más cautelosos con los gastos de los grandes modelos y pierden la fe en los laboratorios principales
A medida que la adopción de la inteligencia artificial se acelera en las empresas, los costos elevados de los tokens han dejado a muchos usuarios luchando con restricciones presupuestarias. Para ayudar a las empresas a escapar del ciclo de “cuanto má
Apple aclara los rumores sobre Gemini: Siri AI se desarrollará internamente
Tras la Conferencia Mundial de Desarrolladores (WWDC) de 2026, Apple respondió a las consultas de los medios sobre los rumores que afirmaban que su nueva infraestructura de IA era simplemente un «envoltorio de Gemini». La compañía aclaró que los Mode
OpenAI aún lucha por controlar la actividad de IA descontrolada
El viernes, OpenAI lanzó una página dedicada a los “informes de desalineación”, revelando un volumen alarmante de comportamientos erráticos documentados durante un período prolongado. El sitio actualmente enumera nueve incidentes, la mayoría ocurrido
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Históricamente, los agentes de programación se han limitado a ámbitos muy concretos —como la corrección de errores en SWE-bench o las tareas de front-end en Design2Code—, mientras que las pruebas de rendimiento en entorno de producción siguen siendo, en gran medida, inaccesibles para la revisión externa. Tencent aborda esta carencia con WorkBuddy Bench, un conjunto de pruebas de evaluación multidominio que se detalla en un artículo reciente publicado en arXiv. Su característica definitoria no es el volumen de tareas, sino una arquitectura de diseño concebida expresamente para impedir la memorización de respuestas.
Esta prueba de rendimiento abarca cuatro ámbitos profesionales: ingeniería de software (código a nivel de repositorio), desarrollo front-end (artefactos web), operaciones empresariales (flujos de trabajo de oficina con múltiples archivos) y ciberseguridad (escenarios de equipos rojo y azul). El conjunto comprende 80, 70, 50 y 60 tareas respectivamente, lo que suma un total de 260. Es fundamental destacar que ninguna de las tareas procede de bancos de preguntas públicos; en su lugar, se han obtenido mediante ingeniería inversa a partir de commits de código reales, pull requests o contextos empresariales, y posteriormente se han reformulado en indicaciones concisas, coloquiales y basadas en juegos de rol. Este enfoque garantiza que las búsquedas en línea de las solicitudes de incorporación de cambios (PR) correspondientes o de pistas en las confirmaciones no arrojen resultados, lo que impide de forma efectiva la memorización. Dado que el conjunto de datos es totalmente abierto —incluidos los directorios, las imágenes de entorno, las herramientas de evaluación, los casos de prueba y las soluciones de referencia—, su resistencia a la contaminación se basa en este método de construcción y en el control de versiones, más que en la opacidad.
Aunque los cuatro subconjuntos comparten una estructura de directorios unificada, cada uno emplea métricas de validación distintas, lo que hace que las comparaciones directas de puntuaciones entre subconjuntos no sean válidas. En consecuencia, Tencent no publica una puntuación global del conjunto de pruebas. Las tareas de código se evalúan mediante tasas de superación de pruebas ocultas; las tareas web combinan comprobaciones de reglas con evaluaciones de LLM/VLM y de agentes, lo que requiere la entrega de artefactos a lo largo de una ruta especificada sin acceso a Internet en tiempo real; las tareas de oficina utilizan comprobaciones de reglas determinísticas ponderadas entre 0,70 y 0,95, junto con una evaluación de LLM basada en pruebas; y las tareas de seguridad se basan en scripts «scoring.py» determinísticos que se ejecutan tres veces para calcular la media, excluyendo los modelos grandes como evaluadores. El subconjunto de seguridad implementa cinco capas contra las trampas: desactivación del escaneo literal, renombramiento de entradas, enmascaramiento de pruebas manipuladas, codificación de dependencias y uso de tareas «cebo» de baja ponderación. Incluye 38 tareas de equipo rojo y 22 de equipo azul, con auditorías de caja abierta basadas en CVE del mundo real en binutils, curl y nginx.
La creación de tareas sigue un proceso estandarizado: recopilación de fuentes, reescritura en forma de peticiones auténticas, montaje del espacio de trabajo, aislamiento de los activos de evaluación tras la ejecución y empaquetado en directorios independientes. Los datos de los usuarios permanecen intactos en todo momento. Las tareas de código asignan cinco roles distintos (desarrollador, ingeniero de algoritmos, gestor de producto, control de calidad y operaciones), mientras que las tareas de seguridad asignan perfiles profesionales. Se proporciona información deliberadamente incompleta —se ocultan los archivos de destino, los patrones y los límites—, lo que obliga a los agentes a obtener el contexto de forma independiente. Los activos de puntuación solo se revelan tras la ejecución, lo que garantiza que los agentes nunca se encuentren con ellos durante la operación.
Las evaluaciones se llevan a cabo en contenedores aislados con entornos de modelo y sandbox separados. El marco utiliza CodeBuddy Code (por defecto) y Claude Code, empleando mayores esfuerzos de razonamiento y una ventana de contexto de 200 000, al tiempo que desactiva WebSearch y AskUserQuestion. Esta restricción es fundamental: desactivar la búsqueda en línea verifica si los mecanismos de resistencia a la contaminación funcionan según lo previsto.
La tabla de clasificación ordena varias familias de modelos (puntuaciones de 0 a 100, modo de razonamiento, tres medias). Claude Opus4.8 domina las primeras posiciones en las categorías de código, web, oficina y seguridad, consiguiendo cinco primeros puestos; GLM-5.2 lidera dos categorías de seguridad, y GPT-5.5 encabeza la categoría de oficina cc. El marco demuestra una alta sensibilidad, especialmente en seguridad, donde los cambios medios absolutos en la clasificación alcanzan los 8,6 puntos. En el marco «cc», Claude Opus4.8 rechazó 13 respuestas, frente a los dos rechazos de GPT-5.5 en el marco «cbc». En cuanto a la eficiencia, GPT-5.5 genera el menor número de tokens al tiempo que mantiene puntuaciones competitivas, mientras que DeepSeek-V4-Pro ejecutó 44 rondas de código con un alto rendimiento de tokens, lo que refleja un enfoque que consume más recursos.








 Las empresas de inteligencia artificial reducen costos a medida que los clientes se vuelven más cautelosos con los gastos de los grandes modelos y pierden la fe en los laboratorios principales
A medida que la adopción de la inteligencia artificial se acelera en las empresas, los costos elevados de los tokens han dejado a muchos usuarios luchando con restricciones presupuestarias. Para ayudar a las empresas a escapar del ciclo de “cuanto má
 Apple aclara los rumores sobre Gemini: Siri AI se desarrollará internamente
Tras la Conferencia Mundial de Desarrolladores (WWDC) de 2026, Apple respondió a las consultas de los medios sobre los rumores que afirmaban que su nueva infraestructura de IA era simplemente un «envoltorio de Gemini». La compañía aclaró que los Mode
 OpenAI aún lucha por controlar la actividad de IA descontrolada
El viernes, OpenAI lanzó una página dedicada a los “informes de desalineación”, revelando un volumen alarmante de comportamientos erráticos documentados durante un período prolongado. El sitio actualmente enumera nueve incidentes, la mayoría ocurrido

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












