


 Maison
Senspeech X2.5 Twin Stars : premier contexte d’un million de tokens sur le bord, entièrement entraîné avec une puissance de calcul nationale
Le 1er septembre, la filiale à 100 % d'iFLYTEK, Ciyuan Xinghuo, a officiellement lancé et open-sourcé deux grands modèles généraux de bout en bout : Xinghuo X2.5-4B et Xinghuo X2.5-1.7B. Ces modèles sont les premiers à prendre nativement en charge une longueur de contexte allant jusqu'à 1 million de Tokens, avec un accès complet aux poids du modèle, aux dépôts de code et à la documentation de déploiement.
Prise en charge du contexte à plusieurs millions de tokens, les petits modèles peuvent « lire un livre entier »
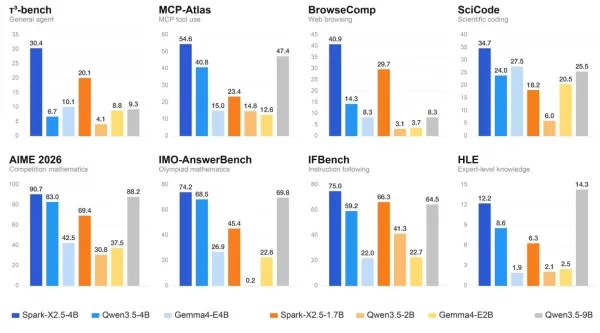
Les deux modèles utilisent une architecture d'attention hybride, optimisée pour des capacités clés telles que les agents, le code, les mathématiques et le respect des instructions, offrant des performances globales qui se distinguent parmi les modèles open-source de taille similaire dans l'industrie.
En ce qui concerne la capacité contextuelle, Xinghuo X2.5-4B et Xinghuo X2.5-1.7B sont entraînés sur des données de haute qualité au niveau de plusieurs billions de Tokens, couvrant des scénarios tels que les documents longs et les matériaux techniques. Ils prennent nativement en charge une fenêtre de contexte de 1 million de Tokens, leur permettant de recevoir et de comprendre des informations à grande échelle en une seule fois.
Par exemple, dans le service après-vente des produits : les utilisateurs peuvent importer le manuel complet d'après-vente dans Xinghuo X2.5-4B. Le modèle trie d'abord les règles d'après-vente dans différents scénarios et marque les chapitres correspondants. Lorsqu'on lui demande « Si une panne d'appareil dans les 10 jours suivant l'achat et l'utilisation de consommables tiers est éligible à un remplacement ? », il peut fournir une évaluation complète en reliant les réglementations sur les retours, la gestion des pannes et les exceptions à travers les chapitres. Même si de nouvelles conditions telles que les zones rurales ou les appareils avec des cartes familiales sont ajoutées plus tard, le modèle peut maintenir le contexte précédent et continuer à fournir des conseils en combinant les règles de logistique, d'effacement des données et de prise en charge des coûts.
Le contexte long résout la question de « savoir si l'information peut être entièrement consultée », tandis que les capacités d'agent et d'appel d'outils résolvent « savoir si des actions peuvent être entreprises après consultation ». Les modèles de bout en bout Xinghuo X2.5 fournissent des capacités intelligentes localisées pour des scénarios tels que le bureau personnel, le développement de code, le matériel intelligent et la robotique. Dans les scénarios de développement de code, Xinghuo X2.5-4B peut correspondre aux modèles cloud avec des paramètres 2 à 3 fois plus grands dans des tâches telles que l'implémentation d'algorithmes, la complétion de code et la génération ; sur l'ensemble de test Domux pour les maisons intelligentes, la précision d'exécution de bout en bout de Xinghuo X2.5-1.7B pour les instructions de contrôle atteint 90,3 %, avec un temps de réponse moyen de seulement 0,85 seconde ; dans les scénarios de robotique, les deux modèles peuvent être déployés sur des corps de robots ou des appareils de bout en bout, prenant en charge des tâches telles que le contrôle des opérations, le suivi de cibles et la prise de décision de navigation, réduisant la dépendance aux connexions cloud et aux programmes prédéfinis fixes.
Entraînement entièrement sur une puissance de calcul nationale, téléchargement et expérience instantanés
Xinghuo X2.5-4B et Xinghuo X2.5-1.7B ont été entraînés entièrement sur des plateformes de calcul nationales, utilisant environ 20 billions de tokens diversifiés de données pour l'entraînement préalable, et améliorant continuellement les performances grâce à un ajustement fin supervisé de haute qualité et à l'apprentissage par renforcement.
En termes de déploiement, les deux modèles prennent en charge des plateformes matérielles incluant NVIDIA, Huawei, Hai Guang et Hemo, et sont compatibles avec des frameworks d'inférence principaux tels que vLLM, SGLang et llama.cpp. Ils peuvent être rapidement déployés via des outils comme Ollama et LM Studio, et prennent en charge l'entraînement incrémental utilisant LLaMA-Factory. À partir d'aujourd'hui, les poids des modèles sont disponibles sur des plateformes telles que Hugging Face et GitHub, et des API de modèles correspondantes ont été lancées sur la plateforme Starry MaaS d'iFLYTEK, gratuites pour une durée limitée. Le 7 septembre, iFLYTEK lancera officiellement le prochain modèle général de pointe, Xinghuo X2.5, améliorant davantage des capacités clés telles que le code et les agents.
Article connexe
 OpenAI lance un groupe consultatif sur les mathématiques et l’intelligence artificielle ; un modèle mystérieux résout 100 problèmes de classe mondiale en 24 jours
Le 22 septembre, OpenAI a annoncé la création d’un « Groupe consultatif sur les mathématiques et l’intelligence artificielle ». Basé à l’Institut d’études avancées de Princeton, cet organe indépendant est composé de neuf mathématiciens qui opèrent sé
Meitun LongCat lance LoHoSearch alors que les scores de BrowseComp chutent en dessous de 30 %
Les capacités des agents de recherche ont été largement définies par BrowseComp au cours de la dernière année. Pourtant, ce benchmark perd de sa pertinence : il a fait passer les performances des modèles de 30 % à 90 % en seulement dix mois, et sa va
MiniMax dévoile M3, un grand modèle d'IA national qui surpasse GPT-5.5
Le secteur de l'intelligence artificielle en Chine a connu un bond technologique majeur avec le lancement officiel du dernier grand modèle de langage de Xiyu Technology, MiniMax M3. Ce système avancé combine une maîtrise du codage de pointe avec la p
Recommandations de sujets spéciaux liés
en écrivant
 Outils de réécriture par l’IA pour la rédaction professionnelle : rendre les textes complexes plus clairs
Les meilleures outils de réécriture par IA hautement notés pour l’écriture professionnelle de 2026 sont disponibles sur XIX.AI ! Cette liste rigoureusement sélectionnée met en avant des outils puissants capables de transformer radicalement la façon de travailler, ayant été soumis à des tests dans des conditions réelles afin de rendre les textes complexes plus clairs et d’améliorer l’efficacité de l’écriture. Obtenez une comparaison gratuite entre les versions payantes et gratuites pour déterminer quelle option correspond le mieux à vos besoins. Explorez dès maintenant cette sélection pour trouver l’outil idéal et tirer parti au maximum des capacités de l’IA dans votre communication professionnelle.
 13 outils
 xix.ai
Composition musicale
Outils d’écriture de chansons par l’IA pour générer des idées de paroles et de mélodie
Les meilleures outils d’écriture de chansons par IA les plus récents et les mieux notés en 2026, destinés à générer des idées de paroles et de mélodies, sont disponibles sur XIX.AI ! Cette sélection rigoureusement choisie propose des solutions puissantes capables de transformer votre travail, ayant été soumises à des tests approfondis dans des conditions réelles afin de fournir des suggestions précises concernant les paroles et les mélodies. Obtenez une comparaison gratuite versus payante, consultez les classements détaillés, et découvrez des outils incontournables qui peuvent améliorer considérablement votre flux de travail créatif. Explorez dès maintenant pour trouver celui qui correspond parfaitement à vos besoins !
8 outils
xix.ai
Santé et bien-être
Applications de planification des repas basées sur ChatGPT pour le suivi des macronutriments, les listes de courses et la préparation hebdomadaire
2026 : les meilleures applications ChatGPT pour planifier vos repas. Découvrez les outils les mieux notés, incontournables et puissants, sélectionnés avec soin pour changer la donne en matière de suivi des macronutriments, de listes de courses et de préparation hebdomadaire. XIX.AI propose des classements mis à jour chaque semaine, basés sur des tests en conditions réelles, avec notamment des comparaisons détaillées entre les versions gratuites et payantes. Trouvez dès aujourd’hui l’outil idéal pour booster votre productivité et tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
9 outils
xix.ai
Création vidéo
Outils de création de scripts vidéo basés sur l'IA pour les contenus courts
Les meilleurs outils de création de scripts vidéo basés sur l'IA pour les contenus courts en 2026 ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, à essayer absolument, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils pour vous aider à booster votre productivité et à tirer pleinement parti de l’IA afin de créer du contenu court de haute qualité. Explorez-la dès maintenant pour découvrir l’outil qui vous convient le mieux !
10 outils
xix.ai
Création de bande dessinée
Outils d'IA pour la création de cases de bande dessinée destinés aux récits de type storyboard
2026 : les meilleurs outils d'IA pour créer des planches de BD, idéaux pour les récits de type storyboard ! Cette sélection triée sur le volet regroupe des solutions puissantes et révolutionnaires qui aident les créateurs à gagner en efficacité dans l'écriture et à surmonter les obstacles à la création. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles et des classements officiels pour vous guider dans votre choix. XIX.AI propose également des avis d'experts. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de donner vie à des histoires captivantes ! 238 caractères
9 outils
xix.ai
Création vidéo
Meilleurs outils de génération vidéo par IA pour les contenus courts
2026 Derniers Meilleurs Outils de Génération de Vidéos par IA les mieux notés pour les contenus courts sont ici dans la collection sélectionnée de XIX.AI. Ces outils puissants et révolutionnaires ont été soumis à des tests rigoureux en conditions réelles, avec une comparaison complète entre les versions gratuites et payantes ainsi que des classements détaillés pour vous aider à trouver l’option parfaite. Que vous ayez besoin de créer rapidement des vidéos courtes de haute qualité ou d’améliorer votre productivité sur diverses tâches, ces solutions incontournables offrent des résultats exceptionnels. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage par l’IA.
9 outils
xix.ai

 commentaires (0)
Le 1er septembre, la filiale à 100 % d'iFLYTEK, Ciyuan Xinghuo, a officiellement lancé et open-sourcé deux grands modèles généraux de bout en bout : Xinghuo X2.5-4B et Xinghuo X2.5-1.7B. Ces modèles sont les premiers à prendre nativement en charge une longueur de contexte allant jusqu'à 1 million de Tokens, avec un accès complet aux poids du modèle, aux dépôts de code et à la documentation de déploiement.
Prise en charge du contexte à plusieurs millions de tokens, les petits modèles peuvent « lire un livre entier »
Les deux modèles utilisent une architecture d'attention hybride, optimisée pour des capacités clés telles que les agents, le code, les mathématiques et le respect des instructions, offrant des performances globales qui se distinguent parmi les modèles open-source de taille similaire dans l'industrie.
En ce qui concerne la capacité contextuelle, Xinghuo X2.5-4B et Xinghuo X2.5-1.7B sont entraînés sur des données de haute qualité au niveau de plusieurs billions de Tokens, couvrant des scénarios tels que les documents longs et les matériaux techniques. Ils prennent nativement en charge une fenêtre de contexte de 1 million de Tokens, leur permettant de recevoir et de comprendre des informations à grande échelle en une seule fois.
Par exemple, dans le service après-vente des produits : les utilisateurs peuvent importer le manuel complet d'après-vente dans Xinghuo X2.5-4B. Le modèle trie d'abord les règles d'après-vente dans différents scénarios et marque les chapitres correspondants. Lorsqu'on lui demande « Si une panne d'appareil dans les 10 jours suivant l'achat et l'utilisation de consommables tiers est éligible à un remplacement ? », il peut fournir une évaluation complète en reliant les réglementations sur les retours, la gestion des pannes et les exceptions à travers les chapitres. Même si de nouvelles conditions telles que les zones rurales ou les appareils avec des cartes familiales sont ajoutées plus tard, le modèle peut maintenir le contexte précédent et continuer à fournir des conseils en combinant les règles de logistique, d'effacement des données et de prise en charge des coûts.
Le contexte long résout la question de « savoir si l'information peut être entièrement consultée », tandis que les capacités d'agent et d'appel d'outils résolvent « savoir si des actions peuvent être entreprises après consultation ». Les modèles de bout en bout Xinghuo X2.5 fournissent des capacités intelligentes localisées pour des scénarios tels que le bureau personnel, le développement de code, le matériel intelligent et la robotique. Dans les scénarios de développement de code, Xinghuo X2.5-4B peut correspondre aux modèles cloud avec des paramètres 2 à 3 fois plus grands dans des tâches telles que l'implémentation d'algorithmes, la complétion de code et la génération ; sur l'ensemble de test Domux pour les maisons intelligentes, la précision d'exécution de bout en bout de Xinghuo X2.5-1.7B pour les instructions de contrôle atteint 90,3 %, avec un temps de réponse moyen de seulement 0,85 seconde ; dans les scénarios de robotique, les deux modèles peuvent être déployés sur des corps de robots ou des appareils de bout en bout, prenant en charge des tâches telles que le contrôle des opérations, le suivi de cibles et la prise de décision de navigation, réduisant la dépendance aux connexions cloud et aux programmes prédéfinis fixes.
Entraînement entièrement sur une puissance de calcul nationale, téléchargement et expérience instantanés
Xinghuo X2.5-4B et Xinghuo X2.5-1.7B ont été entraînés entièrement sur des plateformes de calcul nationales, utilisant environ 20 billions de tokens diversifiés de données pour l'entraînement préalable, et améliorant continuellement les performances grâce à un ajustement fin supervisé de haute qualité et à l'apprentissage par renforcement.
En termes de déploiement, les deux modèles prennent en charge des plateformes matérielles incluant NVIDIA, Huawei, Hai Guang et Hemo, et sont compatibles avec des frameworks d'inférence principaux tels que vLLM, SGLang et llama.cpp. Ils peuvent être rapidement déployés via des outils comme Ollama et LM Studio, et prennent en charge l'entraînement incrémental utilisant LLaMA-Factory. À partir d'aujourd'hui, les poids des modèles sont disponibles sur des plateformes telles que Hugging Face et GitHub, et des API de modèles correspondantes ont été lancées sur la plateforme Starry MaaS d'iFLYTEK, gratuites pour une durée limitée. Le 7 septembre, iFLYTEK lancera officiellement le prochain modèle général de pointe, Xinghuo X2.5, améliorant davantage des capacités clés telles que le code et les agents.








 OpenAI lance un groupe consultatif sur les mathématiques et l’intelligence artificielle ; un modèle mystérieux résout 100 problèmes de classe mondiale en 24 jours
Le 22 septembre, OpenAI a annoncé la création d’un « Groupe consultatif sur les mathématiques et l’intelligence artificielle ». Basé à l’Institut d’études avancées de Princeton, cet organe indépendant est composé de neuf mathématiciens qui opèrent sé
 Meitun LongCat lance LoHoSearch alors que les scores de BrowseComp chutent en dessous de 30 %
Les capacités des agents de recherche ont été largement définies par BrowseComp au cours de la dernière année. Pourtant, ce benchmark perd de sa pertinence : il a fait passer les performances des modèles de 30 % à 90 % en seulement dix mois, et sa va
 MiniMax dévoile M3, un grand modèle d'IA national qui surpasse GPT-5.5
Le secteur de l'intelligence artificielle en Chine a connu un bond technologique majeur avec le lancement officiel du dernier grand modèle de langage de Xiyu Technology, MiniMax M3. Ce système avancé combine une maîtrise du codage de pointe avec la p
Les meilleures outils de réécriture par IA hautement notés pour l’écriture professionnelle de 2026 sont disponibles sur XIX.AI ! Cette liste rigoureusement sélectionnée met en avant des outils puissants capables de transformer radicalement la façon de travailler, ayant été soumis à des tests dans des conditions réelles afin de rendre les textes complexes plus clairs et d’améliorer l’efficacité de l’écriture. Obtenez une comparaison gratuite entre les versions payantes et gratuites pour déterminer quelle option correspond le mieux à vos besoins. Explorez dès maintenant cette sélection pour trouver l’outil idéal et tirer parti au maximum des capacités de l’IA dans votre communication professionnelle.
13 outils
xix.ai

Les meilleures outils d’écriture de chansons par IA les plus récents et les mieux notés en 2026, destinés à générer des idées de paroles et de mélodies, sont disponibles sur XIX.AI ! Cette sélection rigoureusement choisie propose des solutions puissantes capables de transformer votre travail, ayant été soumises à des tests approfondis dans des conditions réelles afin de fournir des suggestions précises concernant les paroles et les mélodies. Obtenez une comparaison gratuite versus payante, consultez les classements détaillés, et découvrez des outils incontournables qui peuvent améliorer considérablement votre flux de travail créatif. Explorez dès maintenant pour trouver celui qui correspond parfaitement à vos besoins !
8 outils
xix.ai

2026 : les meilleures applications ChatGPT pour planifier vos repas. Découvrez les outils les mieux notés, incontournables et puissants, sélectionnés avec soin pour changer la donne en matière de suivi des macronutriments, de listes de courses et de préparation hebdomadaire. XIX.AI propose des classements mis à jour chaque semaine, basés sur des tests en conditions réelles, avec notamment des comparaisons détaillées entre les versions gratuites et payantes. Trouvez dès aujourd’hui l’outil idéal pour booster votre productivité et tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
9 outils
xix.ai

Les meilleurs outils de création de scripts vidéo basés sur l'IA pour les contenus courts en 2026 ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, à essayer absolument, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils pour vous aider à booster votre productivité et à tirer pleinement parti de l’IA afin de créer du contenu court de haute qualité. Explorez-la dès maintenant pour découvrir l’outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour créer des planches de BD, idéaux pour les récits de type storyboard ! Cette sélection triée sur le volet regroupe des solutions puissantes et révolutionnaires qui aident les créateurs à gagner en efficacité dans l'écriture et à surmonter les obstacles à la création. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles et des classements officiels pour vous guider dans votre choix. XIX.AI propose également des avis d'experts. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de donner vie à des histoires captivantes ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils de Génération de Vidéos par IA les mieux notés pour les contenus courts sont ici dans la collection sélectionnée de XIX.AI. Ces outils puissants et révolutionnaires ont été soumis à des tests rigoureux en conditions réelles, avec une comparaison complète entre les versions gratuites et payantes ainsi que des classements détaillés pour vous aider à trouver l’option parfaite. Que vous ayez besoin de créer rapidement des vidéos courtes de haute qualité ou d’améliorer votre productivité sur diverses tâches, ces solutions incontournables offrent des résultats exceptionnels. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage par l’IA.
9 outils
xix.ai












