


 家
Senspeech X2.5 Twin Stars:エッジにおける初の百万トークンコンテキスト、国内の計算資源で完全にトレーニング済み
9月1日、iFLYTEKの完全子会社であるCiyuan Xinghuoは、2つのエッジ側向け汎用大規模モデル「Xinghuo X2.5-4B」と「Xinghuo X2.5-1.7B」を正式にリリースし、オープンソース化しました。これらのモデルは、最大100万トークンのコンテキスト長をネイティブにサポートする初のモデルであり、モデル重み、コードリポジトリ、デプロイメントドキュメントへの完全なアクセスを提供します。
100万レベルのコンテキストサポート、小規模モデルでも「書籍全体を読める」
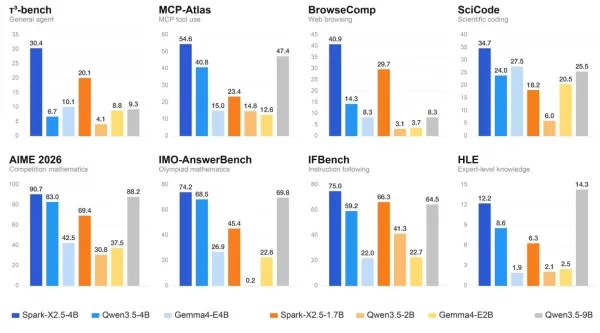
両モデルはハイブリッド注意機構を採用し、エージェント、コード、数学、指示追従などのコア機能の最適化を図り、同規模の業界クラスオープンソースモデルの中で総合性能をリードしています。
コンテキスト能力について、Xinghuo X2.5-4BおよびXinghuo X2.5-1.7Bは、トリリオンレベルのトークン数の高品質データでトレーニングされており、長文書や技術資料などのシナリオをカバーしています。これらは100万トークンのコンテキストウィンドウをネイティブにサポートしており、一度により大規模な情報を受信し理解することができます。
例えば、製品のアフターサービスにおいて、ユーザーは完全なアフターサービスマニュアルをXinghuo X2.5-4Bにインポートできます。モデルはまず異なるシナリオにおけるアフターサービスルールを整理し、対応する章をマークします。「購入後10日以内の故障およびサードパーティ製消耗品使用による交換対象かどうか」という質問に対し、返品規定、故障処理、例外規定を章を跨いで関連付けることで包括的な判断を提供します。後から遠隔地や家族マップ付きデバイスなどの新しい条件が追加された場合でも、モデルは以前のコンテキストを維持し、物流、データ消去、費用負担のルールを組み合わせることでアドバイスを引き続き提供できます。
長文コンテキストは「情報を完全に閲覧できるか」という問題を解決し、エージェントおよびツール呼び出し機能は「閲覧後に行動を起こせるか」という問題を解決します。Xinghuo X2.5エッジ側モデルは、パーソナルオフィス、コード開発、スマートハードウェア、ロボットなどのシナリオにローカルな知能能力を提供します。コード開発シナリオでは、Xinghuo X2.5-4Bはアルゴリズム実装、コード補完、生成などのタスクにおいて、パラメータ数が2〜3倍大きいクラウドモデルと同等の性能を発揮します。Domuxスマートホームテストセットでは、Xinghuo X2.5-1.7Bの制御指示に対するエンドツーエンドの実行精度は90.3%に達し、平均応答時間はわずか0.85秒です。ロボットシナリオでは、両モデルをロボット本体またはエッジデバイスにデプロイでき、操作制御、目標追跡、ナビゲーション意思決定などのタスクをサポートし、クラウド接続および固定された事前設定プログラムへの依存度を低減します。
国内計算資源によるトレーニング、即時ダウンロードと体験
Xinghuo X2.5-4BおよびXinghuo X2.5-1.7Bは、完全に国内の計算プラットフォームでトレーニングされており、約20兆の多様なトークンデータを用いて事前トレーニングを行い、高品質な教師あり微調整および強化学習を通じて性能を継続的に向上させています。
デプロイメント面では、両モデルはNVIDIA、Huawei、Hai Guang、Hemoを含むハードウェアプラットフォームをサポートし、vLLM、SGLang、llama.cppなどの主流な推論フレームワークと互換性があります。OllamaやLM Studioなどのツールを通じて迅速にデプロイ可能であり、LLaMA-Factoryを用いた増分トレーニングもサポートしています。本日より、モデル重みがHugging FaceやGitHubなどのプラットフォームで提供されており、iFLYTEKのStarry MaaSプラットフォームでは対応するモデルAPIがリリースされ、期間限定で無料利用可能です。9月7日、iFLYTEKは次世代フラッグシップ汎用大規模モデル「Xinghuo X2.5」を正式にリリースし、コードおよびエージェントなどのコア機能をさらにアップグレードします。
関連記事
 OpenAI、数学およびAI諮問グループを設立;謎のモデルが24日間で100の世界的な問題を解決
9月22日、OpenAIは「数学と人工知能に関する諮問グループ」の設立を発表した。プリンストンの高等研究所を本部とするこの独立した機関は、OpenAIとは別に活動する9人の数学者で構成されている。さらに注目すべきは、8月28日から学習を開始した謎のモデルが、論争の的となっているナビエ-ストークス千年賞問題を含む、さまざまな数学分野における100以上の長年の未解決問題の解決に成功したとOpenAIが明らかにした点である。数学者たちは急速な進歩に驚愕し、学術的な開示に関する内部議論が巻き起こって
Meitun LongCat、LoHoSearchをリリース、BrowseCompのスコアが30%を下回る
過去1年間、検索エージェントの能力は主にBrowseCompによって定義されてきました。しかし、このベンチマークはその関連性を失いつつあります——わずか10ヶ月でモデルの性能を30%から90%へと引き上げましたが、その価値は急速に低下しています。7月17日、MeituanのLongCatは、検索エージェント開発における意味のある進捗を再点火するために設計された、より厳格な評価であるLoHoSearchを発表しました。LoHoSearchの課題は手動で作成されたものではなく、762万のエンティティ
MiniMax、GPT-5.5を上回る国内AI大規模モデル「M3」を発表
中国のAI分野は、西語科技(Xiyu Technology)の最新大規模言語モデル「MiniMax M3」の公式リリースにより、大きな技術的飛躍を遂げた。この高度なシステムは、最先端のコーディング能力と、最大100万トークンという超長文コンテキストウィンドウのサポートを融合している。特筆すべきは、画像や動画処理に加えてコンピュータデスクトップとのインタラクションもネイティブにサポートしており、これら3つの重要な機能を統合した中国初のオープンソースモデルとなっている。標準ベンチマークにおける卓越し
関連特集おすすめ
書き込み
 ビジネスライティング向けのAIリライトツール:分かりにくい文章をより明確なものに
2026年最新かつ最も優れ、高評価を得ているビジネスライティング用AIリライトツールがXIX.AIで登場しました!こちらの厳選された一覧には、実際の業務で試験的に使用され、分かりにくい文章をより明確にし、執筆効率を向上させる強力で革新的なツールが揃っています。無料版と有料版の比較情報をご覧いただき、ご自身のニーズに合ったオプションを見つけてみましょう。今すぐチェックして、最適なツールを発見し、ビジネスコミュニケーションにおけるAI活用の強みを引き出しましょう。
 13 ツール
 xix.ai
作曲
歌詞やメロディのアイデアを生み出すためのAIソングライティングツール
2026年最新で最も優れ、評価の高いAIソングライティングツールがXIX.AIに集結しました。歌詞やメロディのアイデアを生み出すための強力かつ革新的な機能を備えたこれらのツールは、厳格な実際の環境でのテストを経て、正確な提案を行います。無料版と有料版の比較情報や詳細なランキングを確認し、あなたのクリエイティブワークフローを大幅に向上させることができる必見のツールを発見してください。今すぐ探索して、ご自身のニーズに最適なものを見つけましょう!
8 ツール
xix.ai
健康とウェルネス
マクロ栄養素の管理、買い物リスト、週単位の食事準備に役立つChatGPT対応の献立管理アプリ
2026年最新・最高のChatGPT対応食事計画アプリ。マクロ栄養素の管理、買い物リストの作成、週単位の食事準備に役立つ、高評価で必試の厳選された画期的なツール。XIX.AIは、実地テストに基づく毎週更新のランキングを提供しており、無料版と有料版の比較詳細も掲載しています。生産性を高め、AIの力を最大限に活用するための最適なツールを今すぐ見つけましょう。今すぐチェック!
9 ツール
xix.ai
動画作成
ショートフォームコンテンツ向けのAI動画スクリプト作成ツール
2026年版:ショートフォームコンテンツ向け、最新・最高評価のAI動画スクリプトツール! XIX.AIは、厳格な実地テストを経て選りすぐった、強力で業界に革命をもたらす「必試」ツールのコレクションを厳選しました。 毎週更新される詳細なランキング、無料版と有料版の比較情報、そして高品質なショートフォームコンテンツ制作における生産性を向上させ、AIの真価を引き出すためのヒントをご覧いただけます。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
10 ツール
xix.ai
漫画制作
ストーリーボード形式の物語作成のためのAIコミックパネル作成ツール
2026年版:ストーリーボード形式の物語制作に最適なAIコミックパネルツール!この厳選された高評価ツール集には、クリエイターの執筆効率を高め、制作上のボトルネックを解消する、画期的なソリューションが満載です。 無料版と有料版の詳細な比較、実地テスト、公式ランキングなど、ツール選びの参考になる情報が満載です。XIX.AIによる専門家の見解も掲載されています。今すぐチェックして、生き生きとした物語を形にするあなたにぴったりのツールを見つけましょう! 238文字
9 ツール
xix.ai
動画作成
ショートコンテンツ用のベストなAI動画生成ツール
2026年最新のベストトップ評価AI動画生成ツールが、XIX.AIの厳選コレクションに登場しました。これらの強力なゲームチェンジャーツールは、厳格な実世界テストを経ており、包括的な無料対有料比較と詳細なランキングを特徴とし、最適なオプションを見つけるお手伝いをします。高品質なショートビデオを迅速に作成する必要がある場合でも、さまざまなタスクで生産性を向上させたい場合でも、これらの必須ソリューションは優れた結果を提供します。今すぐ探索して、理想のツールを発見し、AIの優位性を解き放ちましょう。
9 ツール
xix.ai

 コメント (0)
0/500
9月1日、iFLYTEKの完全子会社であるCiyuan Xinghuoは、2つのエッジ側向け汎用大規模モデル「Xinghuo X2.5-4B」と「Xinghuo X2.5-1.7B」を正式にリリースし、オープンソース化しました。これらのモデルは、最大100万トークンのコンテキスト長をネイティブにサポートする初のモデルであり、モデル重み、コードリポジトリ、デプロイメントドキュメントへの完全なアクセスを提供します。
100万レベルのコンテキストサポート、小規模モデルでも「書籍全体を読める」
両モデルはハイブリッド注意機構を採用し、エージェント、コード、数学、指示追従などのコア機能の最適化を図り、同規模の業界クラスオープンソースモデルの中で総合性能をリードしています。
コンテキスト能力について、Xinghuo X2.5-4BおよびXinghuo X2.5-1.7Bは、トリリオンレベルのトークン数の高品質データでトレーニングされており、長文書や技術資料などのシナリオをカバーしています。これらは100万トークンのコンテキストウィンドウをネイティブにサポートしており、一度により大規模な情報を受信し理解することができます。
例えば、製品のアフターサービスにおいて、ユーザーは完全なアフターサービスマニュアルをXinghuo X2.5-4Bにインポートできます。モデルはまず異なるシナリオにおけるアフターサービスルールを整理し、対応する章をマークします。「購入後10日以内の故障およびサードパーティ製消耗品使用による交換対象かどうか」という質問に対し、返品規定、故障処理、例外規定を章を跨いで関連付けることで包括的な判断を提供します。後から遠隔地や家族マップ付きデバイスなどの新しい条件が追加された場合でも、モデルは以前のコンテキストを維持し、物流、データ消去、費用負担のルールを組み合わせることでアドバイスを引き続き提供できます。
長文コンテキストは「情報を完全に閲覧できるか」という問題を解決し、エージェントおよびツール呼び出し機能は「閲覧後に行動を起こせるか」という問題を解決します。Xinghuo X2.5エッジ側モデルは、パーソナルオフィス、コード開発、スマートハードウェア、ロボットなどのシナリオにローカルな知能能力を提供します。コード開発シナリオでは、Xinghuo X2.5-4Bはアルゴリズム実装、コード補完、生成などのタスクにおいて、パラメータ数が2〜3倍大きいクラウドモデルと同等の性能を発揮します。Domuxスマートホームテストセットでは、Xinghuo X2.5-1.7Bの制御指示に対するエンドツーエンドの実行精度は90.3%に達し、平均応答時間はわずか0.85秒です。ロボットシナリオでは、両モデルをロボット本体またはエッジデバイスにデプロイでき、操作制御、目標追跡、ナビゲーション意思決定などのタスクをサポートし、クラウド接続および固定された事前設定プログラムへの依存度を低減します。
国内計算資源によるトレーニング、即時ダウンロードと体験
Xinghuo X2.5-4BおよびXinghuo X2.5-1.7Bは、完全に国内の計算プラットフォームでトレーニングされており、約20兆の多様なトークンデータを用いて事前トレーニングを行い、高品質な教師あり微調整および強化学習を通じて性能を継続的に向上させています。
デプロイメント面では、両モデルはNVIDIA、Huawei、Hai Guang、Hemoを含むハードウェアプラットフォームをサポートし、vLLM、SGLang、llama.cppなどの主流な推論フレームワークと互換性があります。OllamaやLM Studioなどのツールを通じて迅速にデプロイ可能であり、LLaMA-Factoryを用いた増分トレーニングもサポートしています。本日より、モデル重みがHugging FaceやGitHubなどのプラットフォームで提供されており、iFLYTEKのStarry MaaSプラットフォームでは対応するモデルAPIがリリースされ、期間限定で無料利用可能です。9月7日、iFLYTEKは次世代フラッグシップ汎用大規模モデル「Xinghuo X2.5」を正式にリリースし、コードおよびエージェントなどのコア機能をさらにアップグレードします。








 OpenAI、数学およびAI諮問グループを設立;謎のモデルが24日間で100の世界的な問題を解決
9月22日、OpenAIは「数学と人工知能に関する諮問グループ」の設立を発表した。プリンストンの高等研究所を本部とするこの独立した機関は、OpenAIとは別に活動する9人の数学者で構成されている。さらに注目すべきは、8月28日から学習を開始した謎のモデルが、論争の的となっているナビエ-ストークス千年賞問題を含む、さまざまな数学分野における100以上の長年の未解決問題の解決に成功したとOpenAIが明らかにした点である。数学者たちは急速な進歩に驚愕し、学術的な開示に関する内部議論が巻き起こって
 Meitun LongCat、LoHoSearchをリリース、BrowseCompのスコアが30%を下回る
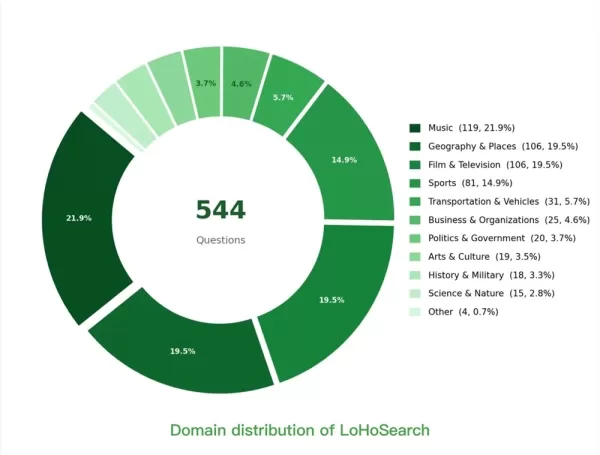
過去1年間、検索エージェントの能力は主にBrowseCompによって定義されてきました。しかし、このベンチマークはその関連性を失いつつあります——わずか10ヶ月でモデルの性能を30%から90%へと引き上げましたが、その価値は急速に低下しています。7月17日、MeituanのLongCatは、検索エージェント開発における意味のある進捗を再点火するために設計された、より厳格な評価であるLoHoSearchを発表しました。LoHoSearchの課題は手動で作成されたものではなく、762万のエンティティ
 MiniMax、GPT-5.5を上回る国内AI大規模モデル「M3」を発表
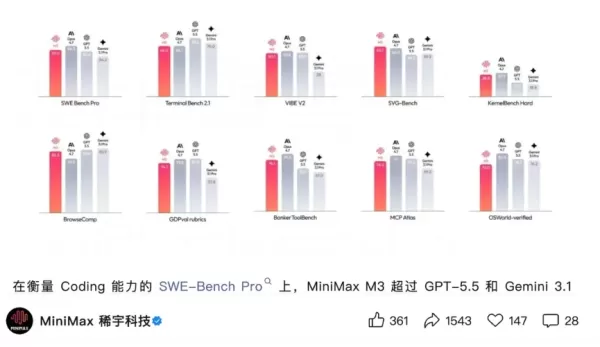
中国のAI分野は、西語科技(Xiyu Technology)の最新大規模言語モデル「MiniMax M3」の公式リリースにより、大きな技術的飛躍を遂げた。この高度なシステムは、最先端のコーディング能力と、最大100万トークンという超長文コンテキストウィンドウのサポートを融合している。特筆すべきは、画像や動画処理に加えてコンピュータデスクトップとのインタラクションもネイティブにサポートしており、これら3つの重要な機能を統合した中国初のオープンソースモデルとなっている。標準ベンチマークにおける卓越し
2026年最新かつ最も優れ、高評価を得ているビジネスライティング用AIリライトツールがXIX.AIで登場しました!こちらの厳選された一覧には、実際の業務で試験的に使用され、分かりにくい文章をより明確にし、執筆効率を向上させる強力で革新的なツールが揃っています。無料版と有料版の比較情報をご覧いただき、ご自身のニーズに合ったオプションを見つけてみましょう。今すぐチェックして、最適なツールを発見し、ビジネスコミュニケーションにおけるAI活用の強みを引き出しましょう。
13 ツール
xix.ai

2026年最新で最も優れ、評価の高いAIソングライティングツールがXIX.AIに集結しました。歌詞やメロディのアイデアを生み出すための強力かつ革新的な機能を備えたこれらのツールは、厳格な実際の環境でのテストを経て、正確な提案を行います。無料版と有料版の比較情報や詳細なランキングを確認し、あなたのクリエイティブワークフローを大幅に向上させることができる必見のツールを発見してください。今すぐ探索して、ご自身のニーズに最適なものを見つけましょう!
8 ツール
xix.ai

2026年最新・最高のChatGPT対応食事計画アプリ。マクロ栄養素の管理、買い物リストの作成、週単位の食事準備に役立つ、高評価で必試の厳選された画期的なツール。XIX.AIは、実地テストに基づく毎週更新のランキングを提供しており、無料版と有料版の比較詳細も掲載しています。生産性を高め、AIの力を最大限に活用するための最適なツールを今すぐ見つけましょう。今すぐチェック!
9 ツール
xix.ai

2026年版:ショートフォームコンテンツ向け、最新・最高評価のAI動画スクリプトツール! XIX.AIは、厳格な実地テストを経て選りすぐった、強力で業界に革命をもたらす「必試」ツールのコレクションを厳選しました。 毎週更新される詳細なランキング、無料版と有料版の比較情報、そして高品質なショートフォームコンテンツ制作における生産性を向上させ、AIの真価を引き出すためのヒントをご覧いただけます。今すぐチェックして、あなたにぴったりのツールを見つけましょう!
10 ツール
xix.ai

2026年版:ストーリーボード形式の物語制作に最適なAIコミックパネルツール!この厳選された高評価ツール集には、クリエイターの執筆効率を高め、制作上のボトルネックを解消する、画期的なソリューションが満載です。 無料版と有料版の詳細な比較、実地テスト、公式ランキングなど、ツール選びの参考になる情報が満載です。XIX.AIによる専門家の見解も掲載されています。今すぐチェックして、生き生きとした物語を形にするあなたにぴったりのツールを見つけましょう! 238文字
9 ツール
xix.ai

2026年最新のベストトップ評価AI動画生成ツールが、XIX.AIの厳選コレクションに登場しました。これらの強力なゲームチェンジャーツールは、厳格な実世界テストを経ており、包括的な無料対有料比較と詳細なランキングを特徴とし、最適なオプションを見つけるお手伝いをします。高品質なショートビデオを迅速に作成する必要がある場合でも、さまざまなタスクで生産性を向上させたい場合でも、これらの必須ソリューションは優れた結果を提供します。今すぐ探索して、理想のツールを発見し、AIの優位性を解き放ちましょう。
9 ツール
xix.ai












