


 Hogar
Senspeech X2.5 Twin Stars: Primer contexto de un millón de tokens en el borde, completamente entrenado con potencia de computación nacional
El 1 de septiembre, la filial de propiedad total de iFLYTEK, Ciyuan Xinghuo, lanzó oficialmente y abrió al código fuente dos modelos grandes generales de borde: Xinghuo X2.5-4B y Xinghuo X2.5-1.7B. Estos modelos son los primeros en su tipo en admitir nativamente una longitud de contexto de hasta 1 millón de Tokens, con acceso completo a los pesos del modelo, los repositorios de código y la documentación de implementación.
Soporte de contexto de nivel millonario, los modelos pequeños pueden "leer el libro completo"
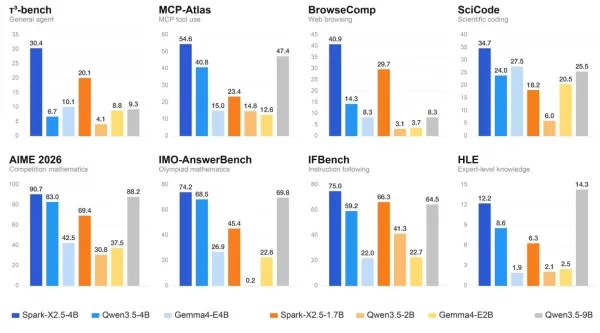
Ambos modelos utilizan una arquitectura de atención híbrida, optimizada para capacidades clave como agentes, código, matemáticas y seguimiento de instrucciones, ofreciendo un rendimiento integral que lidera entre los modelos de código abierto de clase industrial de tamaño similar.
En cuanto a la capacidad de contexto, Xinghuo X2.5-4B y Xinghuo X2.5-1.7B se entrenaron con datos de alta calidad a nivel de billones de Tokens, cubriendo escenarios como documentos largos y materiales técnicos. Admiten nativamente una ventana de contexto de 1 millón de Tokens, lo que les permite recibir y comprender información a mayor escala de una sola vez.
Por ejemplo, en el servicio postventa de productos: los usuarios pueden importar el manual completo de postventa a Xinghuo X2.5-4B. El modelo primero organiza las reglas de postventa bajo diferentes escenarios y marca los capítulos correspondientes. Cuando se pregunta "¿Si un fallo del dispositivo ocurre dentro de los 10 días posteriores a la compra y se utilizan consumibles de terceros, califica para un reemplazo?", puede proporcionar un juicio integral vinculando las regulaciones sobre devoluciones, manejo de fallos y excepciones entre capítulos. Incluso si se añaden posteriormente nuevas condiciones como áreas remotas o dispositivos con mapas familiares, el modelo puede mantener el contexto anterior y continuar proporcionando consejos combinando las reglas de logística, borrado de datos y carga de costos.
El contexto largo resuelve el problema de "si la información puede ser vista completamente", mientras que las capacidades de agente y llamada de herramientas resuelven "si se pueden tomar acciones después de ver". Los modelos de borde Xinghuo X2.5 proporcionan capacidades inteligentes localizadas para escenarios como oficina personal, desarrollo de código, hardware inteligente y robótica. En escenarios de desarrollo de código, Xinghuo X2.5-4B puede igualar a modelos en la nube con parámetros 2 a 3 veces mayores en tareas como implementación de algoritmos, finalización y generación de código; en el conjunto de pruebas Domux para hogares inteligentes, la precisión de ejecución de extremo a extremo de Xinghuo X2.5-1.7B para instrucciones de control alcanza el 90,3%, con un tiempo de respuesta promedio de solo 0,85 segundos; en escenarios de robótica, ambos modelos pueden implementarse en cuerpos de robots o dispositivos de borde, apoyando tareas como control de operaciones, seguimiento de objetivos y toma de decisiones de navegación, reduciendo la dependencia de conexiones en la nube y programas preestablecidos fijos.
Entrenamiento con potencia de cálculo completamente nacional, descarga y experiencia instantáneas
Xinghuo X2.5-4B y Xinghuo X2.5-1.7B fueron entrenados completamente en plataformas de cálculo nacionales, utilizando aproximadamente 20 billones de tokens diversos de datos para el preentrenamiento, y mejorando continuamente el rendimiento mediante ajuste fino supervisado de alta calidad y aprendizaje por refuerzo.
En términos de implementación, ambos modelos admiten plataformas de hardware que incluyen NVIDIA, Huawei, Hai Guang y Hemo, y son compatibles con marcos de inferencia principales como vLLM, SGLang y llama.cpp. Pueden implementarse rápidamente mediante herramientas como Ollama y LM Studio, y admiten entrenamiento incremental utilizando LLaMA-Factory. A partir de hoy, los pesos del modelo están disponibles en plataformas como Hugging Face y GitHub, y se han lanzado las APIs correspondientes de los modelos en la plataforma Starry MaaS de iFLYTEK, gratuitas por tiempo limitado. El 7 de septiembre, iFLYTEK lanzará oficialmente el próximo modelo grande general insignia, Xinghuo X2.5, mejorando aún más capacidades clave como código y agentes.
Artículo relacionado
 OpenAI lanza un grupo asesor de matemáticas e inteligencia artificial; un modelo misterioso resuelve 100 problemas de clase mundial en 24 días
El 22 de septiembre, OpenAI anunció la formación de un «Grupo Asesor sobre Matemáticas e Inteligencia Artificial». Con sede en el Instituto de Estudios Avanzados de Princeton, este órgano independiente está compuesto por nueve matemáticos que operan
Meitun LongCat lanza LoHoSearch mientras BrowseComp cae por debajo del 30%
Las capacidades de los agentes de búsqueda han sido definidas en gran medida por BrowseComp durante el último año. Sin embargo, este benchmark está perdiendo relevancia: impulsó el rendimiento de los modelos del 30% al 90% en solo diez meses, y su va
MiniMax presenta M3, un modelo de inteligencia artificial de gran escala nacional que supera a GPT-5.5
El sector de inteligencia artificial de China ha experimentado un importante avance tecnológico con el lanzamiento oficial del último modelo de lenguaje grande de Xiyu Technology, MiniMax M3. Este sistema avanzado combina una competencia de codificac
Recomendaciones de temas especiales relacionados
composicion musical
 Herramientas de composición musical con IA para generar ideas de letras y melodías
¡Los mejores y más recientes herramientas de composición musical con inteligencia artificial, clasificadas como las mejores del año 2026 para generar ideas de letras y melodías, están disponibles en XIX.AI! Esta selección cuidadosamente elaborada incluye opciones potentes que revolucionan el proceso creativo y han pasado por pruebas rigurosas en entornos reales con el objetivo de ofrecer sugerencias precisas sobre letras y melodías. Obtenga una comparación gratuita frente a la versión de pago, consulte las clasificaciones detalladas y descubra herramientas imprescindibles que pueden mejorar significativamente su flujo de trabajo creativo. ¡Explórelas ahora para encontrar la opción perfecta según sus necesidades!
 8 herramientas
 xix.ai
Salud y bienestar
Aplicaciones de planificación de comidas con ChatGPT para el seguimiento de macronutrientes, listas de la compra y preparación semanal
2026: Las mejores y más recientes aplicaciones de ChatGPT para planificar comidas. Las herramientas más valoradas, imprescindibles y potentes, cuidadosamente seleccionadas para realizar un seguimiento de macronutrientes, crear listas de la compra y preparar comidas semanales. XIX.AI ofrece clasificaciones actualizadas semanalmente basadas en pruebas reales, incluyendo detalles comparativos entre versiones gratuitas y de pago. Descubre hoy mismo la herramienta perfecta para aumentar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
9 herramientas
xix.ai
Creación de vídeos
Herramientas de guion de vídeo basadas en IA para contenido breve
¡Las mejores herramientas de 2026 para crear guiones de vídeo con IA, mejor valoradas para contenido breve! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder y que han superado rigurosas pruebas en condiciones reales. Encontrarás clasificaciones detalladas que se actualizan semanalmente, información comparativa entre versiones gratuitas y de pago, y consejos que te ayudarán a aumentar tu productividad y a sacar el máximo partido a la IA a la hora de crear contenido breve de alta calidad. ¡Explora ahora mismo y descubre tu herramienta perfecta!
10 herramientas
xix.ai
Creación de cómics
Herramientas de IA para la creación de viñetas de cómic en narrativas tipo storyboard
¡Las mejores herramientas de 2026 para crear viñetas de cómic con IA, ideales para narrativas al estilo storyboard! Esta selección de herramientas mejor valoradas incluye potentes soluciones revolucionarias que ayudan a los creadores a mejorar la eficiencia en la redacción y a superar los obstáculos en el proceso creativo. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, pruebas en condiciones reales y clasificaciones oficiales que te guiarán en tu elección. XIX.AI también ofrece opiniones de expertos. ¡Explora ahora mismo y descubre la herramienta perfecta para dar vida a historias cautivadoras! 238 caracteres
9 herramientas
xix.ai
Creación de vídeos
Mejores herramientas de generación de video con IA para contenido breve
2026 Últimas, mejores y más valoradas herramientas de generación de vídeo con IA para contenido breve están aquí en la colección curada de XIX.AI. Estas poderosas herramientas que cambian las reglas del juego han pasado por rigurosas pruebas en el mundo real, con una comparación completa entre versiones gratuitas y de pago y clasificaciones detalladas para ayudarte a encontrar la opción perfecta. Ya sea que necesites crear vídeos cortos de alta calidad rápidamente o mejorar tu productividad en diversas tareas, estas soluciones imprescindibles ofrecen resultados destacados. Explora ahora para descubrir tu herramienta ideal y desbloquear tu ventaja con IA.
9 herramientas
xix.ai
Diseño y Arte
Mejores generadores de arte con IA: Explore tableros de inspiración, estilos y direcciones visuales
El ranking de 2026 de los mejores generadores de arte con IA muestra las herramientas más valoradas para crear tableros de inspiración impresionantes, explorar estilos diversos y definir direcciones visuales. XIX.AI ofrece una lista cuidadosamente seleccionada de opciones potentes y revolucionarias que han superado pruebas rigurosas en entornos reales. Consulte una comparación gratuita con la versión de pago para ayudarse a encontrar la solución perfecta que potencie su flujo de trabajo creativo. Explórelo ahora y aproveche toda la ventaja que le brinda la IA en la creación artística.
10 herramientas
xix.ai

 comentario (0)
0/500
El 1 de septiembre, la filial de propiedad total de iFLYTEK, Ciyuan Xinghuo, lanzó oficialmente y abrió al código fuente dos modelos grandes generales de borde: Xinghuo X2.5-4B y Xinghuo X2.5-1.7B. Estos modelos son los primeros en su tipo en admitir nativamente una longitud de contexto de hasta 1 millón de Tokens, con acceso completo a los pesos del modelo, los repositorios de código y la documentación de implementación.
Soporte de contexto de nivel millonario, los modelos pequeños pueden "leer el libro completo"
Ambos modelos utilizan una arquitectura de atención híbrida, optimizada para capacidades clave como agentes, código, matemáticas y seguimiento de instrucciones, ofreciendo un rendimiento integral que lidera entre los modelos de código abierto de clase industrial de tamaño similar.
En cuanto a la capacidad de contexto, Xinghuo X2.5-4B y Xinghuo X2.5-1.7B se entrenaron con datos de alta calidad a nivel de billones de Tokens, cubriendo escenarios como documentos largos y materiales técnicos. Admiten nativamente una ventana de contexto de 1 millón de Tokens, lo que les permite recibir y comprender información a mayor escala de una sola vez.
Por ejemplo, en el servicio postventa de productos: los usuarios pueden importar el manual completo de postventa a Xinghuo X2.5-4B. El modelo primero organiza las reglas de postventa bajo diferentes escenarios y marca los capítulos correspondientes. Cuando se pregunta "¿Si un fallo del dispositivo ocurre dentro de los 10 días posteriores a la compra y se utilizan consumibles de terceros, califica para un reemplazo?", puede proporcionar un juicio integral vinculando las regulaciones sobre devoluciones, manejo de fallos y excepciones entre capítulos. Incluso si se añaden posteriormente nuevas condiciones como áreas remotas o dispositivos con mapas familiares, el modelo puede mantener el contexto anterior y continuar proporcionando consejos combinando las reglas de logística, borrado de datos y carga de costos.
El contexto largo resuelve el problema de "si la información puede ser vista completamente", mientras que las capacidades de agente y llamada de herramientas resuelven "si se pueden tomar acciones después de ver". Los modelos de borde Xinghuo X2.5 proporcionan capacidades inteligentes localizadas para escenarios como oficina personal, desarrollo de código, hardware inteligente y robótica. En escenarios de desarrollo de código, Xinghuo X2.5-4B puede igualar a modelos en la nube con parámetros 2 a 3 veces mayores en tareas como implementación de algoritmos, finalización y generación de código; en el conjunto de pruebas Domux para hogares inteligentes, la precisión de ejecución de extremo a extremo de Xinghuo X2.5-1.7B para instrucciones de control alcanza el 90,3%, con un tiempo de respuesta promedio de solo 0,85 segundos; en escenarios de robótica, ambos modelos pueden implementarse en cuerpos de robots o dispositivos de borde, apoyando tareas como control de operaciones, seguimiento de objetivos y toma de decisiones de navegación, reduciendo la dependencia de conexiones en la nube y programas preestablecidos fijos.
Entrenamiento con potencia de cálculo completamente nacional, descarga y experiencia instantáneas
Xinghuo X2.5-4B y Xinghuo X2.5-1.7B fueron entrenados completamente en plataformas de cálculo nacionales, utilizando aproximadamente 20 billones de tokens diversos de datos para el preentrenamiento, y mejorando continuamente el rendimiento mediante ajuste fino supervisado de alta calidad y aprendizaje por refuerzo.
En términos de implementación, ambos modelos admiten plataformas de hardware que incluyen NVIDIA, Huawei, Hai Guang y Hemo, y son compatibles con marcos de inferencia principales como vLLM, SGLang y llama.cpp. Pueden implementarse rápidamente mediante herramientas como Ollama y LM Studio, y admiten entrenamiento incremental utilizando LLaMA-Factory. A partir de hoy, los pesos del modelo están disponibles en plataformas como Hugging Face y GitHub, y se han lanzado las APIs correspondientes de los modelos en la plataforma Starry MaaS de iFLYTEK, gratuitas por tiempo limitado. El 7 de septiembre, iFLYTEK lanzará oficialmente el próximo modelo grande general insignia, Xinghuo X2.5, mejorando aún más capacidades clave como código y agentes.








 OpenAI lanza un grupo asesor de matemáticas e inteligencia artificial; un modelo misterioso resuelve 100 problemas de clase mundial en 24 días
El 22 de septiembre, OpenAI anunció la formación de un «Grupo Asesor sobre Matemáticas e Inteligencia Artificial». Con sede en el Instituto de Estudios Avanzados de Princeton, este órgano independiente está compuesto por nueve matemáticos que operan
 Meitun LongCat lanza LoHoSearch mientras BrowseComp cae por debajo del 30%
Las capacidades de los agentes de búsqueda han sido definidas en gran medida por BrowseComp durante el último año. Sin embargo, este benchmark está perdiendo relevancia: impulsó el rendimiento de los modelos del 30% al 90% en solo diez meses, y su va
 MiniMax presenta M3, un modelo de inteligencia artificial de gran escala nacional que supera a GPT-5.5
El sector de inteligencia artificial de China ha experimentado un importante avance tecnológico con el lanzamiento oficial del último modelo de lenguaje grande de Xiyu Technology, MiniMax M3. Este sistema avanzado combina una competencia de codificac

¡Los mejores y más recientes herramientas de composición musical con inteligencia artificial, clasificadas como las mejores del año 2026 para generar ideas de letras y melodías, están disponibles en XIX.AI! Esta selección cuidadosamente elaborada incluye opciones potentes que revolucionan el proceso creativo y han pasado por pruebas rigurosas en entornos reales con el objetivo de ofrecer sugerencias precisas sobre letras y melodías. Obtenga una comparación gratuita frente a la versión de pago, consulte las clasificaciones detalladas y descubra herramientas imprescindibles que pueden mejorar significativamente su flujo de trabajo creativo. ¡Explórelas ahora para encontrar la opción perfecta según sus necesidades!
8 herramientas
xix.ai

2026: Las mejores y más recientes aplicaciones de ChatGPT para planificar comidas. Las herramientas más valoradas, imprescindibles y potentes, cuidadosamente seleccionadas para realizar un seguimiento de macronutrientes, crear listas de la compra y preparar comidas semanales. XIX.AI ofrece clasificaciones actualizadas semanalmente basadas en pruebas reales, incluyendo detalles comparativos entre versiones gratuitas y de pago. Descubre hoy mismo la herramienta perfecta para aumentar tu productividad y sacar el máximo partido a la IA. ¡Explora ahora!
9 herramientas
xix.ai

¡Las mejores herramientas de 2026 para crear guiones de vídeo con IA, mejor valoradas para contenido breve! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder y que han superado rigurosas pruebas en condiciones reales. Encontrarás clasificaciones detalladas que se actualizan semanalmente, información comparativa entre versiones gratuitas y de pago, y consejos que te ayudarán a aumentar tu productividad y a sacar el máximo partido a la IA a la hora de crear contenido breve de alta calidad. ¡Explora ahora mismo y descubre tu herramienta perfecta!
10 herramientas
xix.ai

¡Las mejores herramientas de 2026 para crear viñetas de cómic con IA, ideales para narrativas al estilo storyboard! Esta selección de herramientas mejor valoradas incluye potentes soluciones revolucionarias que ayudan a los creadores a mejorar la eficiencia en la redacción y a superar los obstáculos en el proceso creativo. Encontrarás comparativas detalladas entre opciones gratuitas y de pago, pruebas en condiciones reales y clasificaciones oficiales que te guiarán en tu elección. XIX.AI también ofrece opiniones de expertos. ¡Explora ahora mismo y descubre la herramienta perfecta para dar vida a historias cautivadoras! 238 caracteres
9 herramientas
xix.ai

2026 Últimas, mejores y más valoradas herramientas de generación de vídeo con IA para contenido breve están aquí en la colección curada de XIX.AI. Estas poderosas herramientas que cambian las reglas del juego han pasado por rigurosas pruebas en el mundo real, con una comparación completa entre versiones gratuitas y de pago y clasificaciones detalladas para ayudarte a encontrar la opción perfecta. Ya sea que necesites crear vídeos cortos de alta calidad rápidamente o mejorar tu productividad en diversas tareas, estas soluciones imprescindibles ofrecen resultados destacados. Explora ahora para descubrir tu herramienta ideal y desbloquear tu ventaja con IA.
9 herramientas
xix.ai

El ranking de 2026 de los mejores generadores de arte con IA muestra las herramientas más valoradas para crear tableros de inspiración impresionantes, explorar estilos diversos y definir direcciones visuales. XIX.AI ofrece una lista cuidadosamente seleccionada de opciones potentes y revolucionarias que han superado pruebas rigurosas en entornos reales. Consulte una comparación gratuita con la versión de pago para ayudarse a encontrar la solución perfecta que potencie su flujo de trabajo creativo. Explórelo ahora y aproveche toda la ventaja que le brinda la IA en la creación artística.
10 herramientas
xix.ai












