


 Maison
OpenAI conservera les données du ChatGPT en vertu d'une décision de justice, le PDG Altman propose un privilège de l'IA.
De nombreux utilisateurs réguliers de ChatGPT, dont l'auteur de cet article, ont peut-être eu recours à la fonction de "chat temporaire". Cette option, offerte par le populaire chatbot d'OpenAI, est conçue pour effacer automatiquement toutes les informations échangées au cours d'une session dès que celle-ci est fermée.
En outre, les utilisateurs ont la possibilité de supprimer manuellement les conversations passées de ChatGPT à partir de la barre latérale dans les applications web, de bureau et mobiles. Pour ce faire, il suffit de cliquer avec le bouton gauche de la souris, de faire un contrôle-clic ou d'effectuer un appui long sur la conversation souhaitée.
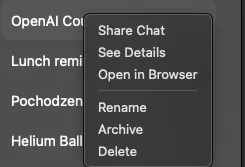
Cette semaine, cependant, OpenAI a dû faire face aux critiques des utilisateurs après qu'il a été révélé que l'entreprise n'avait pas supprimé ces journaux de conversation comme les utilisateurs avaient été amenés à le croire.
"Vous me dites que mes chats ChatGPT supprimés ne sont en fait pas supprimés et qu'ils sont sauvegardés pour faire l'objet d'une enquête par un juge ?", a posté l'utilisateur X @ns123abc, un commentaire qui a recueilli plus d'un million de vues.
Un autre utilisateur, @kepano, a ajouté : "Vous pouvez 'supprimer' un chat ChatGPT, mais tous les chats doivent être conservés en raison d'obligations légales...".
Comme l'a noté Simon Willison, expert en IA et ingénieur logiciel, sur son blog : "Les clients payants des API [d'OpenAI] pourraient bien prendre la décision de passer à d'autres fournisseurs qui peuvent offrir des politiques de conservation qui ne sont pas subverties par cette décision de justice !"
OpenAI a confirmé que, depuis la mi-mai 2025, elle conservait les discussions supprimées et temporaires des utilisateurs, conformément à une décision de justice fédérale. L'entreprise n'a informé les utilisateurs de cette conservation que le 5 juin.
L'ordonnance, rendue le 13 mai 2025 par le juge magistrat américain Ona T. Wang, ordonne à OpenAI de "conserver et de séparer toutes les données de sortie qui seraient autrement supprimées à l'avenir". Il s'agit notamment des chats que les utilisateurs ont demandé de supprimer ou de ceux qui ont été effacés automatiquement pour des raisons de confidentialité.
gov.uscourts.nysd.612697.551.0_1DownloadCette directive trouve son origine dans l'affaire opposant le New York Times (NYT) à OpenAI et Microsoft, un procès sur les droits d'auteur qui dure depuis plus d'un an et demi. Les avocats du NYT prétendent que les modèles de langage d'OpenAI peuvent reproduire mot pour mot des contenus d'actualité protégés par le droit d'auteur. Ils affirment que les journaux, y compris ceux que les utilisateurs ont supprimés, pourraient contenir des preuves pertinentes des résultats de l'infraction.
Bien qu'OpenAI se soit immédiatement conformée à l'ordonnance, elle a attendu plus de trois semaines avant de notifier publiquement les utilisateurs concernés. L'entreprise a ensuite publié un billet de blog et une FAQ détaillant le mandat légal et les utilisateurs concernés.
OpenAI attribue la responsabilité de cette action au NYT et à l'ordonnance du juge, déclarant qu'elle estime que la demande de conservation est "sans fondement".
OpenAI clarifie l'ordonnance du tribunal concernant la conservation des journaux des utilisateurs de ChatGPT et précise quels chats sont concernés
Dans un récent billet de blog, Brad Lightcap, directeur de l'exploitation d'OpenAI, a défendu la position de l'entreprise, déclarant qu'elle défendait la vie privée des utilisateurs contre ce qu'elle considérait comme une ordonnance judiciaire trop large. Il a écrit ce qui suit :
"Le New York Times et d'autres plaignants ont formulé une demande générale et inutile dans leur procès sans fondement contre nous : conserver indéfiniment les données des clients de ChatGPT et de l'API. Cela va fondamentalement à l'encontre des engagements que nous avons pris envers nos utilisateurs en matière de protection de la vie privée".
Le message précise que les utilisateurs de ChatGPT Free, Plus, Pro et Team, ainsi que les clients de l'API qui n'ont pas conclu d'accord de conservation zéro des données (ZDR), sont soumis à l'ordre de conservation. Pour ces utilisateurs, même les chats supprimés ou ceux des sessions de chat temporaires seront stockés dans un avenir prévisible.
Cependant, les abonnés aux plans ChatGPT Enterprise et Edu, ainsi que les clients API utilisant des points d'extrémité ZDR, ne sont pas concernés. Leurs chats continueront d'être supprimés selon les instructions.
Les données conservées font l'objet d'une mise en suspens juridique, ce qui signifie qu'elles sont stockées dans un système sécurisé et séparé, accessible uniquement à un nombre limité de juristes et de responsables de la sécurité.
"Ces données ne sont pas automatiquement partagées avec le New York Times ou qui que ce soit d'autre", a souligné M. Lightcap.
Sam Altman propose un "privilège de l'IA" pour les conversations confidentielles entre utilisateurs et modèles
Le PDG et cofondateur d'OpenAI, Sam Altman, a également abordé la question publiquement dans un billet sur X, en écrivant :
"Récemment, le NYT a demandé à un tribunal de nous obliger à ne pas supprimer les conversations des utilisateurs. Nous pensons qu'il s'agit d'une demande inappropriée qui crée un mauvais précédent.
Il a suggéré qu'un cadre juridique et éthique plus large pour la vie privée de l'IA pourrait être nécessaire :
"Nous avons récemment réfléchi au besoin de quelque chose comme le "privilège de l'IA" ; cela accélère vraiment le besoin d'avoir cette conversation."
"Je pense que parler à une IA devrait être comme parler à un avocat ou à un médecin."
"J'espère que la société comprendra bientôt ce qu'il en est.
Le concept de "privilège de l'IA" serait parallèle aux normes de confidentialité établies, comme le secret professionnel de l'avocat ou du médecin.
Il n'est pas certain qu'un tel cadre gagne du terrain dans les arènes juridiques ou politiques, mais les commentaires d'Altman indiquent que l'OpenAI pourrait faire pression pour ce type de changement.
Quelle est la prochaine étape pour OpenAI et vos discussions temporaires ou supprimées ?
OpenAI s'est formellement opposée à l'ordonnance du tribunal, demandant qu'elle soit annulée.
Dans les documents déposés au tribunal, l'entreprise affirme que la demande manque de base factuelle et que la conservation de milliards de points de données supplémentaires est inutile et disproportionnée.
Lors de l'audience du 27 mai, le juge Wang a indiqué que l'ordonnance était temporaire. Elle a demandé aux deux parties d'élaborer un plan d'échantillonnage pour vérifier si les données utilisateur supprimées diffèrent matériellement des journaux conservés. OpenAI a reçu l'ordre de soumettre cette proposition avant le 6 juin, bien que le dépôt n'ait pas encore été rendu public.
Implications pour les entreprises et les décideurs en matière d'IA
Bien que l'ordonnance exempte les clients de ChatGPT Enterprise et API qui utilisent des points d'extrémité ZDR, ses implications juridiques et de réputation plus larges sont importantes pour les professionnels qui gèrent les déploiements d'IA.
Ceux qui supervisent le cycle de vie des grands modèles de langage (LLM) doivent réévaluer les hypothèses de gouvernance des données. Si les composants de LLM orientés vers l'utilisateur peuvent faire l'objet d'ordonnances légales de conservation, des questions cruciales se posent sur le flux de données après qu'elles ont quitté un point de terminaison sécurisé et sur la manière d'isoler ou d'anonymiser les interactions à haut risque.
Toute plateforme utilisant les API OpenAI doit vérifier quels points de terminaison (ZDR ou non) sont utilisés et s'assurer que les politiques de traitement des données sont clairement reflétées dans les contrats d'utilisation, les journaux d'audit et la documentation interne.
Même avec des points d'extrémité ZDR, les organisations doivent examiner les politiques de cycle de vie des données pour confirmer que les systèmes en aval (analyse, journalisation, sauvegarde) ne conservent pas par inadvertance des interactions présumées transitoires.
Les responsables de la sécurité doivent désormais étendre la modélisation des menaces pour inclure la divulgation légale en tant que vecteur de risque potentiel. Les équipes doivent vérifier si les pratiques de conservation du backend d'OpenAI s'alignent sur les contrôles internes, évaluer les risques liés aux tiers et déterminer si les utilisateurs s'appuient sur des fonctionnalités telles que le "chat temporaire", qui pourraient ne pas fonctionner comme prévu en cas de mise en suspens judiciaire.
Un moment charnière pour la protection de la vie privée et la sécurité des utilisateurs dans le domaine de l'IA
Cette situation représente plus qu'un différend juridique ; il s'agit d'un moment charnière dans l'évolution du débat sur la protection de la vie privée et des données dans le domaine de l'IA. En introduisant le concept de "privilège de l'IA", l'OpenAI propose un nouveau contrat social sur la manière dont les systèmes intelligents traitent les données confidentielles des utilisateurs.
On ne sait pas encore si les tribunaux ou les législateurs accepteront ce cadre. Pour l'instant, l'OpenAI navigue dans un équilibre complexe entre la conformité légale, les assurances de l'entreprise et la confiance de l'utilisateur, tout en faisant face à un examen de plus en plus approfondi de la question de savoir qui contrôle en dernier ressort les données lors de l'interaction avec l'IA.
Article connexe
 Google dévoile son IA agentique pour Gemini, dont le lancement s'adresse d'abord aux entreprises
Lors d’un événement Google Cloud organisé jeudi, l’entreprise a dévoilé son projet d’intégrer l’IA Gemini à l’ère des agents. Ce lancement marque l’arrivée d’un agent unifié capable non seulement de r
Google dévoile Dreambeans, son outil d'IA le plus excentrique à ce jour, pour transformer votre vie en dessin animé
Google Labs, la division chargée de la conception de produits expérimentaux, vient de lancer une nouvelle application basée sur l'intelligence artificielle pour iOS et Android, qui donne vie à vo
Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (3)
![NicholasClark]()
ChatGPTの一時チャット機能、便利だけど削除されるのがちょっと寂しいですね。CEOが「AI特権」を提案してるってニュース、法律家の視点から面白いけど、一般ユーザーのプライバシー保護には直接つながらないかも。裁判所の命令でデータ保持が決まったってことは、今後法廷で使われるリスクも増えるわけだし、ちょっとドキドキしますね。😅 #ChatGPT #プライバシー
![RalphWalker]()
So the 'temporary chat' wasn't really temporary after all? Classic move – promise privacy, then keep the data anyway. 🙄 And 'AI privilege' sounds like a get-out-of-jail-free card for tech giants. I'd rather see actual encryption than fancy new terms.
![LucasNelson]()
Interesting... So 'temporary chats' weren't really that temporary after all? This proposed 'AI privilege' sounds like an attempt to build a legal shield. The privacy vs. intelligence gathering debate is just getting started. What data policy are you actually agreeing to when you click 'agree'? 🤔
De nombreux utilisateurs réguliers de ChatGPT, dont l'auteur de cet article, ont peut-être eu recours à la fonction de "chat temporaire". Cette option, offerte par le populaire chatbot d'OpenAI, est conçue pour effacer automatiquement toutes les informations échangées au cours d'une session dès que celle-ci est fermée.
En outre, les utilisateurs ont la possibilité de supprimer manuellement les conversations passées de ChatGPT à partir de la barre latérale dans les applications web, de bureau et mobiles. Pour ce faire, il suffit de cliquer avec le bouton gauche de la souris, de faire un contrôle-clic ou d'effectuer un appui long sur la conversation souhaitée.
Cette semaine, cependant, OpenAI a dû faire face aux critiques des utilisateurs après qu'il a été révélé que l'entreprise n'avait pas supprimé ces journaux de conversation comme les utilisateurs avaient été amenés à le croire.
"Vous me dites que mes chats ChatGPT supprimés ne sont en fait pas supprimés et qu'ils sont sauvegardés pour faire l'objet d'une enquête par un juge ?", a posté l'utilisateur X @ns123abc, un commentaire qui a recueilli plus d'un million de vues.
Un autre utilisateur, @kepano, a ajouté : "Vous pouvez 'supprimer' un chat ChatGPT, mais tous les chats doivent être conservés en raison d'obligations légales...".
Comme l'a noté Simon Willison, expert en IA et ingénieur logiciel, sur son blog : "Les clients payants des API [d'OpenAI] pourraient bien prendre la décision de passer à d'autres fournisseurs qui peuvent offrir des politiques de conservation qui ne sont pas subverties par cette décision de justice !"
OpenAI a confirmé que, depuis la mi-mai 2025, elle conservait les discussions supprimées et temporaires des utilisateurs, conformément à une décision de justice fédérale. L'entreprise n'a informé les utilisateurs de cette conservation que le 5 juin.
L'ordonnance, rendue le 13 mai 2025 par le juge magistrat américain Ona T. Wang, ordonne à OpenAI de "conserver et de séparer toutes les données de sortie qui seraient autrement supprimées à l'avenir". Il s'agit notamment des chats que les utilisateurs ont demandé de supprimer ou de ceux qui ont été effacés automatiquement pour des raisons de confidentialité.
gov.uscourts.nysd.612697.551.0_1DownloadCette directive trouve son origine dans l'affaire opposant le New York Times (NYT) à OpenAI et Microsoft, un procès sur les droits d'auteur qui dure depuis plus d'un an et demi. Les avocats du NYT prétendent que les modèles de langage d'OpenAI peuvent reproduire mot pour mot des contenus d'actualité protégés par le droit d'auteur. Ils affirment que les journaux, y compris ceux que les utilisateurs ont supprimés, pourraient contenir des preuves pertinentes des résultats de l'infraction.
Bien qu'OpenAI se soit immédiatement conformée à l'ordonnance, elle a attendu plus de trois semaines avant de notifier publiquement les utilisateurs concernés. L'entreprise a ensuite publié un billet de blog et une FAQ détaillant le mandat légal et les utilisateurs concernés.
OpenAI attribue la responsabilité de cette action au NYT et à l'ordonnance du juge, déclarant qu'elle estime que la demande de conservation est "sans fondement".
OpenAI clarifie l'ordonnance du tribunal concernant la conservation des journaux des utilisateurs de ChatGPT et précise quels chats sont concernés
Dans un récent billet de blog, Brad Lightcap, directeur de l'exploitation d'OpenAI, a défendu la position de l'entreprise, déclarant qu'elle défendait la vie privée des utilisateurs contre ce qu'elle considérait comme une ordonnance judiciaire trop large. Il a écrit ce qui suit :
"Le New York Times et d'autres plaignants ont formulé une demande générale et inutile dans leur procès sans fondement contre nous : conserver indéfiniment les données des clients de ChatGPT et de l'API. Cela va fondamentalement à l'encontre des engagements que nous avons pris envers nos utilisateurs en matière de protection de la vie privée".
Le message précise que les utilisateurs de ChatGPT Free, Plus, Pro et Team, ainsi que les clients de l'API qui n'ont pas conclu d'accord de conservation zéro des données (ZDR), sont soumis à l'ordre de conservation. Pour ces utilisateurs, même les chats supprimés ou ceux des sessions de chat temporaires seront stockés dans un avenir prévisible.
Cependant, les abonnés aux plans ChatGPT Enterprise et Edu, ainsi que les clients API utilisant des points d'extrémité ZDR, ne sont pas concernés. Leurs chats continueront d'être supprimés selon les instructions.
Les données conservées font l'objet d'une mise en suspens juridique, ce qui signifie qu'elles sont stockées dans un système sécurisé et séparé, accessible uniquement à un nombre limité de juristes et de responsables de la sécurité.
"Ces données ne sont pas automatiquement partagées avec le New York Times ou qui que ce soit d'autre", a souligné M. Lightcap.
Sam Altman propose un "privilège de l'IA" pour les conversations confidentielles entre utilisateurs et modèles
Le PDG et cofondateur d'OpenAI, Sam Altman, a également abordé la question publiquement dans un billet sur X, en écrivant :
"Récemment, le NYT a demandé à un tribunal de nous obliger à ne pas supprimer les conversations des utilisateurs. Nous pensons qu'il s'agit d'une demande inappropriée qui crée un mauvais précédent.
Il a suggéré qu'un cadre juridique et éthique plus large pour la vie privée de l'IA pourrait être nécessaire :
"Nous avons récemment réfléchi au besoin de quelque chose comme le "privilège de l'IA" ; cela accélère vraiment le besoin d'avoir cette conversation."
"Je pense que parler à une IA devrait être comme parler à un avocat ou à un médecin."
"J'espère que la société comprendra bientôt ce qu'il en est.
Le concept de "privilège de l'IA" serait parallèle aux normes de confidentialité établies, comme le secret professionnel de l'avocat ou du médecin.
Il n'est pas certain qu'un tel cadre gagne du terrain dans les arènes juridiques ou politiques, mais les commentaires d'Altman indiquent que l'OpenAI pourrait faire pression pour ce type de changement.
Quelle est la prochaine étape pour OpenAI et vos discussions temporaires ou supprimées ?
OpenAI s'est formellement opposée à l'ordonnance du tribunal, demandant qu'elle soit annulée.
Dans les documents déposés au tribunal, l'entreprise affirme que la demande manque de base factuelle et que la conservation de milliards de points de données supplémentaires est inutile et disproportionnée.
Lors de l'audience du 27 mai, le juge Wang a indiqué que l'ordonnance était temporaire. Elle a demandé aux deux parties d'élaborer un plan d'échantillonnage pour vérifier si les données utilisateur supprimées diffèrent matériellement des journaux conservés. OpenAI a reçu l'ordre de soumettre cette proposition avant le 6 juin, bien que le dépôt n'ait pas encore été rendu public.
Implications pour les entreprises et les décideurs en matière d'IA
Bien que l'ordonnance exempte les clients de ChatGPT Enterprise et API qui utilisent des points d'extrémité ZDR, ses implications juridiques et de réputation plus larges sont importantes pour les professionnels qui gèrent les déploiements d'IA.
Ceux qui supervisent le cycle de vie des grands modèles de langage (LLM) doivent réévaluer les hypothèses de gouvernance des données. Si les composants de LLM orientés vers l'utilisateur peuvent faire l'objet d'ordonnances légales de conservation, des questions cruciales se posent sur le flux de données après qu'elles ont quitté un point de terminaison sécurisé et sur la manière d'isoler ou d'anonymiser les interactions à haut risque.
Toute plateforme utilisant les API OpenAI doit vérifier quels points de terminaison (ZDR ou non) sont utilisés et s'assurer que les politiques de traitement des données sont clairement reflétées dans les contrats d'utilisation, les journaux d'audit et la documentation interne.
Même avec des points d'extrémité ZDR, les organisations doivent examiner les politiques de cycle de vie des données pour confirmer que les systèmes en aval (analyse, journalisation, sauvegarde) ne conservent pas par inadvertance des interactions présumées transitoires.
Les responsables de la sécurité doivent désormais étendre la modélisation des menaces pour inclure la divulgation légale en tant que vecteur de risque potentiel. Les équipes doivent vérifier si les pratiques de conservation du backend d'OpenAI s'alignent sur les contrôles internes, évaluer les risques liés aux tiers et déterminer si les utilisateurs s'appuient sur des fonctionnalités telles que le "chat temporaire", qui pourraient ne pas fonctionner comme prévu en cas de mise en suspens judiciaire.
Un moment charnière pour la protection de la vie privée et la sécurité des utilisateurs dans le domaine de l'IA
Cette situation représente plus qu'un différend juridique ; il s'agit d'un moment charnière dans l'évolution du débat sur la protection de la vie privée et des données dans le domaine de l'IA. En introduisant le concept de "privilège de l'IA", l'OpenAI propose un nouveau contrat social sur la manière dont les systèmes intelligents traitent les données confidentielles des utilisateurs.
On ne sait pas encore si les tribunaux ou les législateurs accepteront ce cadre. Pour l'instant, l'OpenAI navigue dans un équilibre complexe entre la conformité légale, les assurances de l'entreprise et la confiance de l'utilisateur, tout en faisant face à un examen de plus en plus approfondi de la question de savoir qui contrôle en dernier ressort les données lors de l'interaction avec l'IA.








 Google dévoile son IA agentique pour Gemini, dont le lancement s'adresse d'abord aux entreprises
Lors d’un événement Google Cloud organisé jeudi, l’entreprise a dévoilé son projet d’intégrer l’IA Gemini à l’ère des agents. Ce lancement marque l’arrivée d’un agent unifié capable non seulement de r
 Google dévoile Dreambeans, son outil d'IA le plus excentrique à ce jour, pour transformer votre vie en dessin animé
Google Labs, la division chargée de la conception de produits expérimentaux, vient de lancer une nouvelle application basée sur l'intelligence artificielle pour iOS et Android, qui donne vie à vo
 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

ChatGPTの一時チャット機能、便利だけど削除されるのがちょっと寂しいですね。CEOが「AI特権」を提案してるってニュース、法律家の視点から面白いけど、一般ユーザーのプライバシー保護には直接つながらないかも。裁判所の命令でデータ保持が決まったってことは、今後法廷で使われるリスクも増えるわけだし、ちょっとドキドキしますね。😅 #ChatGPT #プライバシー
So the 'temporary chat' wasn't really temporary after all? Classic move – promise privacy, then keep the data anyway. 🙄 And 'AI privilege' sounds like a get-out-of-jail-free card for tech giants. I'd rather see actual encryption than fancy new terms.
Interesting... So 'temporary chats' weren't really that temporary after all? This proposed 'AI privilege' sounds like an attempt to build a legal shield. The privacy vs. intelligence gathering debate is just getting started. What data policy are you actually agreeing to when you click 'agree'? 🤔












