


 Maison
MiniMax Grand Modèle Mal Prononce les Noms - Xiyu Technology : Entraînement Insuffisant Après des Jetons Spécifiques
MiniMax a récemment publié un rapport technique détaillant les raisons pour lesquelles ses modèles de la série M2 ont eu du mal à générer avec précision des noms spécifiques tels que « Ma Jiaqi ». Cette erreur apparente met en lumière une faille systémique dans l'entraînement actuel des grands modèles de langage.
Décalage des jetons : L'espace vectoriel compressé
La cause fondamentale réside dans le tokenizer, l'unité de base du traitement du texte. Par exemple, le nom « Ma Jiaqi » est divisé en deux jetons : « Ma » et « Jiaqi ». Bien que le modèle ait appris ces éléments lors de la phase de pré-entraînement, des problèmes sont survenus lors de l'étape ultérieure d'ajustement fin par instructions.
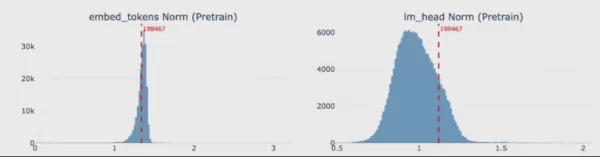
Lors de l'ajustement fin, le jeton « Jiaqi » est apparu si rarement dans les données de dialogue qu'il a reçu presque aucun entraînement. Parallèlement, les jetons à haute fréquence, tels que les symboles de code et les appels d'outils, ont été fortement renforcés, « compressant » efficacement l'espace de représentation des jetons à faible fréquence. Par conséquent, ces jetons se sont éloignés de leurs distributions de probabilité correctes, conduisant le modèle à les substituer par des alternatives phonétiquement similaires telles que « Jiaqi » ou « Qiqi » lorsqu'il fait référence à des célébrités spécifiques.
Au-delà du chinois : Une réaction en chaîne mêlant japonais et russe
L'analyse de MiniMax a révélé que cette « dégradation des jetons » est répandue. En analysant environ 200 000 jetons du vocabulaire complet, ils ont constaté qu'environ 4,9 % présentaient des baisses de performance significatives. Il est notable que les jetons japonais ont subi un taux de dégradation allant jusqu'à 29,7 %, ce qui explique pourquoi le modèle mélange parfois des caractères russes ou coréens dans des conversations en japonais.
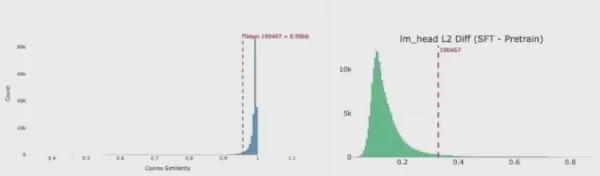
Au-delà des noms et des langues étrangères, les jetons affectés incluent les marqueurs LaTeX, les symboles de code source de Wikipédia et même certains mots-clés de spam SEO. Cela démontre que la rareté des données a des conséquences globales : lorsque les données post-entraînement ne couvrent pas uniformément les diverses langues et vocabulaires spécifiques, la logique de génération du modèle devient biaisée.
Réparation systématique : Établir une « garantie minimale » pour 200 000 jetons
Pour corriger ce problème structurel, l'équipe de R&D a mis en œuvre une stratégie de réparation précise. Ils ont généré des données synthétiques couvrant l'intégralité du vocabulaire et ont forcé le modèle à effectuer des tâches de « répétition », établissant ainsi une « garantie minimale » pour la fréquence de génération de chaque jeton.
Les données post-réparation montrent des améliorations marquées dans la stabilité de la sortie du vocabulaire complet du modèle. Le taux de caractères étrangers mélangés dans les réponses en japonais est passé de 47 % à seulement 1 %. L'équipe continue d'explorer des optimisations plus profondes, telles que l'intégration des matériaux de pré-entraînement dans l'étape d'ajustement fin ou la suppression directe des marqueurs redondants qui ne sont plus utilisés dans le vocabulaire.
Cet incident a déclenché une réflexion importante au sein de l'industrie : bien que les tokenizers des grands modèles soient souvent construits à partir de vastes corpus web, les applications en aval varient considérablement. Assurer une couverture adéquate des données au niveau des jetons, d'un point de vue statistique fondamental, tout en maintenant la diversité sémantique, reste un défi critique pour améliorer la fiabilité des grands modèles.
Article connexe
 AliVideo dévoille Wan3.0, offrant une génération de vidéos ultra-longues et une cohérence multidimensionnelle
Le 24 août, Alibaba a dévoilé Wan3.0, son dernier modèle de génération vidéo à grande échelle. Cette version représente une avancée majeure pour la technologie vidéo d’Alibaba, offrant des améliorations significatives en termes de durée, de création
L'accord entre Nvidia et la Chine concernant le H200 survit au sommet Trump-Xi, mais pas comme prévu
Le président Trump s’est rendu à Pékin, Jensen Huang ayant rejoint la délégation à la dernière minute, et est reparti deux jours plus tard en se contentant de remarques vagues sur d’éventuelles évolut
Comment corriger les Core Web Vitals pour le référencement SEO ?
La création d’actifs visuellement attrayants est cruciale dans le développement de jeux. L’art pixelisé, avec son esthétique rétro charmante, reste un choix populaire. Avec l’avènement des outils d’IA, la génération d’art pixelisé est devenue plus ac
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
MiniMax a récemment publié un rapport technique détaillant les raisons pour lesquelles ses modèles de la série M2 ont eu du mal à générer avec précision des noms spécifiques tels que « Ma Jiaqi ». Cette erreur apparente met en lumière une faille systémique dans l'entraînement actuel des grands modèles de langage.
Décalage des jetons : L'espace vectoriel compressé
La cause fondamentale réside dans le tokenizer, l'unité de base du traitement du texte. Par exemple, le nom « Ma Jiaqi » est divisé en deux jetons : « Ma » et « Jiaqi ». Bien que le modèle ait appris ces éléments lors de la phase de pré-entraînement, des problèmes sont survenus lors de l'étape ultérieure d'ajustement fin par instructions.
Lors de l'ajustement fin, le jeton « Jiaqi » est apparu si rarement dans les données de dialogue qu'il a reçu presque aucun entraînement. Parallèlement, les jetons à haute fréquence, tels que les symboles de code et les appels d'outils, ont été fortement renforcés, « compressant » efficacement l'espace de représentation des jetons à faible fréquence. Par conséquent, ces jetons se sont éloignés de leurs distributions de probabilité correctes, conduisant le modèle à les substituer par des alternatives phonétiquement similaires telles que « Jiaqi » ou « Qiqi » lorsqu'il fait référence à des célébrités spécifiques.
Au-delà du chinois : Une réaction en chaîne mêlant japonais et russe
L'analyse de MiniMax a révélé que cette « dégradation des jetons » est répandue. En analysant environ 200 000 jetons du vocabulaire complet, ils ont constaté qu'environ 4,9 % présentaient des baisses de performance significatives. Il est notable que les jetons japonais ont subi un taux de dégradation allant jusqu'à 29,7 %, ce qui explique pourquoi le modèle mélange parfois des caractères russes ou coréens dans des conversations en japonais.
Au-delà des noms et des langues étrangères, les jetons affectés incluent les marqueurs LaTeX, les symboles de code source de Wikipédia et même certains mots-clés de spam SEO. Cela démontre que la rareté des données a des conséquences globales : lorsque les données post-entraînement ne couvrent pas uniformément les diverses langues et vocabulaires spécifiques, la logique de génération du modèle devient biaisée.
Réparation systématique : Établir une « garantie minimale » pour 200 000 jetons
Pour corriger ce problème structurel, l'équipe de R&D a mis en œuvre une stratégie de réparation précise. Ils ont généré des données synthétiques couvrant l'intégralité du vocabulaire et ont forcé le modèle à effectuer des tâches de « répétition », établissant ainsi une « garantie minimale » pour la fréquence de génération de chaque jeton.
Les données post-réparation montrent des améliorations marquées dans la stabilité de la sortie du vocabulaire complet du modèle. Le taux de caractères étrangers mélangés dans les réponses en japonais est passé de 47 % à seulement 1 %. L'équipe continue d'explorer des optimisations plus profondes, telles que l'intégration des matériaux de pré-entraînement dans l'étape d'ajustement fin ou la suppression directe des marqueurs redondants qui ne sont plus utilisés dans le vocabulaire.
Cet incident a déclenché une réflexion importante au sein de l'industrie : bien que les tokenizers des grands modèles soient souvent construits à partir de vastes corpus web, les applications en aval varient considérablement. Assurer une couverture adéquate des données au niveau des jetons, d'un point de vue statistique fondamental, tout en maintenant la diversité sémantique, reste un défi critique pour améliorer la fiabilité des grands modèles.








 AliVideo dévoille Wan3.0, offrant une génération de vidéos ultra-longues et une cohérence multidimensionnelle
Le 24 août, Alibaba a dévoilé Wan3.0, son dernier modèle de génération vidéo à grande échelle. Cette version représente une avancée majeure pour la technologie vidéo d’Alibaba, offrant des améliorations significatives en termes de durée, de création
 L'accord entre Nvidia et la Chine concernant le H200 survit au sommet Trump-Xi, mais pas comme prévu
Le président Trump s’est rendu à Pékin, Jensen Huang ayant rejoint la délégation à la dernière minute, et est reparti deux jours plus tard en se contentant de remarques vagues sur d’éventuelles évolut
 Comment corriger les Core Web Vitals pour le référencement SEO ?
La création d’actifs visuellement attrayants est cruciale dans le développement de jeux. L’art pixelisé, avec son esthétique rétro charmante, reste un choix populaire. Avec l’avènement des outils d’IA, la génération d’art pixelisé est devenue plus ac

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












