


 Maison
Le plugin vLLM-ATOM d'AMD améliore les performances d'inférence des grands modèles d'IA destinés à un usage domestique
AMD a officiellement lancé le plugin vLLM-ATOM, spécialement conçu pour le déploiement de grands modèles linguistiques. Ce plugin vise à améliorer considérablement les performances d'inférence des grands modèles nationaux courants, tels que DeepSeek-R1 et Kimi-K2, sur le matériel AMD, sans perturber les flux de travail existants.
En tant que framework d'inférence open source conçu pour les scénarios à forte concurrence, vLLM est réputé pour son excellente efficacité mémoire. Le nouveau plugin d'AMD offre une solution d'optimisation plus personnalisée pour ses GPU de la série Instinct, permettant aux développeurs de réaliser une migration technique avec un effort d'apprentissage minimal.
Amélioration transparente des performances
Le principal avantage du plugin vLLM-ATOM réside dans son déploiement « sans coût ». Les utilisateurs n’ont pas besoin de modifier leurs API existantes ni leurs workflows de bout en bout. Le plugin gère et optimise automatiquement la planification des requêtes et le réglage du noyau en arrière-plan, permettant aux services actuels de migrer en douceur vers le backend matériel AMD.
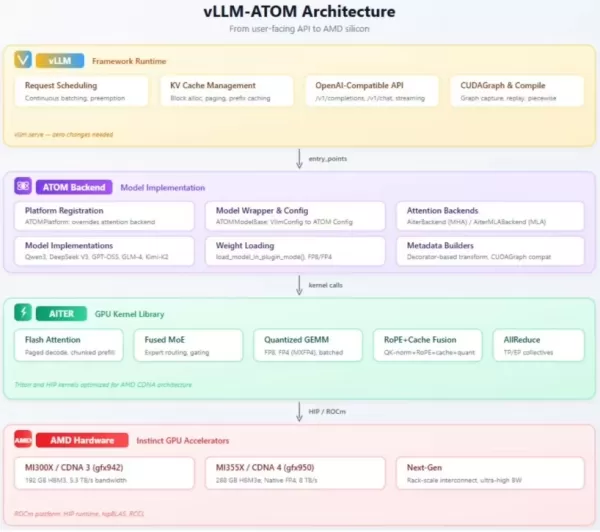
Sur le plan architectural, le plugin est structuré en trois couches : la couche supérieure assure la compatibilité avec l'interface OpenAI, la couche intermédiaire gère l'exécution et le routage des modèles, et la couche inférieure fournit les noyaux GPU de base. Cette conception intègre efficacement les technologies de « mixture-of-experts » (MoE) et de quantification, garantissant une prise en charge robuste pour les déploiements à grande échelle.
Large compatibilité avec les écosystèmes de calcul
Le plugin cible les GPU haute performance des séries Instinct MI350 et MI400 d'AMD. Il prend en charge non seulement les principaux modèles linguistiques chinois de grande envergure tels que Qwen3 et GLM, mais couvre également de manière exhaustive divers scénarios d'application, y compris les modèles denses, les modèles de type « mixture-of-experts » et les modèles vision-langage (VLM).
Article connexe
 Les lunettes intelligentes d’Apple pourraient être présentées lors de la WWDC27, mettant en avant la protection de la vie privée
Mark Gurman de Bloomberg rapporte que les lunettes intelligentes d’Apple, codifiées N50, sont prévues pour une présentation lors de la WWDC27 en juin 2027, avec un lancement commercial attendu à l’automne 2027. Initialement destinées à la fin de cett
À l’intérieur des détails révélés sur le prochain Gemini : une puissance de calcul mise à rude épreuve, des équipes internes en désaccord sur les priorités de développement et l’allocation des ressources
Les rapports indiquent que le lancement du modèle Gemini de nouvelle génération, tant attendu par Google, a été repoussé. Des désaccords internes concernant les priorités de développement et l'allocation des ressources, combinés à une capacité de cal
OpenAI rejette les inquiétudes concernant un ralentissement de la croissance, affirmant que plusieurs unités commerciales accélèrent
En réponse aux critiques externes concernant la décélération de la croissance des ventes et le non-respect des objectifs internes, le leader de l'IA, OpenAI, a publié une déclaration rassurante le mardi 28 avril. L'entreprise a précisé que ses produi
Recommandations de sujets spéciaux liés
Analyse des données
 Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
 9 outils
 xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

 commentaires (0)
AMD a officiellement lancé le plugin vLLM-ATOM, spécialement conçu pour le déploiement de grands modèles linguistiques. Ce plugin vise à améliorer considérablement les performances d'inférence des grands modèles nationaux courants, tels que DeepSeek-R1 et Kimi-K2, sur le matériel AMD, sans perturber les flux de travail existants.
En tant que framework d'inférence open source conçu pour les scénarios à forte concurrence, vLLM est réputé pour son excellente efficacité mémoire. Le nouveau plugin d'AMD offre une solution d'optimisation plus personnalisée pour ses GPU de la série Instinct, permettant aux développeurs de réaliser une migration technique avec un effort d'apprentissage minimal.
Amélioration transparente des performances
Le principal avantage du plugin vLLM-ATOM réside dans son déploiement « sans coût ». Les utilisateurs n’ont pas besoin de modifier leurs API existantes ni leurs workflows de bout en bout. Le plugin gère et optimise automatiquement la planification des requêtes et le réglage du noyau en arrière-plan, permettant aux services actuels de migrer en douceur vers le backend matériel AMD.
Sur le plan architectural, le plugin est structuré en trois couches : la couche supérieure assure la compatibilité avec l'interface OpenAI, la couche intermédiaire gère l'exécution et le routage des modèles, et la couche inférieure fournit les noyaux GPU de base. Cette conception intègre efficacement les technologies de « mixture-of-experts » (MoE) et de quantification, garantissant une prise en charge robuste pour les déploiements à grande échelle.
Large compatibilité avec les écosystèmes de calcul
Le plugin cible les GPU haute performance des séries Instinct MI350 et MI400 d'AMD. Il prend en charge non seulement les principaux modèles linguistiques chinois de grande envergure tels que Qwen3 et GLM, mais couvre également de manière exhaustive divers scénarios d'application, y compris les modèles denses, les modèles de type « mixture-of-experts » et les modèles vision-langage (VLM).








 Les lunettes intelligentes d’Apple pourraient être présentées lors de la WWDC27, mettant en avant la protection de la vie privée
Mark Gurman de Bloomberg rapporte que les lunettes intelligentes d’Apple, codifiées N50, sont prévues pour une présentation lors de la WWDC27 en juin 2027, avec un lancement commercial attendu à l’automne 2027. Initialement destinées à la fin de cett
 À l’intérieur des détails révélés sur le prochain Gemini : une puissance de calcul mise à rude épreuve, des équipes internes en désaccord sur les priorités de développement et l’allocation des ressources
Les rapports indiquent que le lancement du modèle Gemini de nouvelle génération, tant attendu par Google, a été repoussé. Des désaccords internes concernant les priorités de développement et l'allocation des ressources, combinés à une capacité de cal
 OpenAI rejette les inquiétudes concernant un ralentissement de la croissance, affirmant que plusieurs unités commerciales accélèrent
En réponse aux critiques externes concernant la décélération de la croissance des ventes et le non-respect des objectifs internes, le leader de l'IA, OpenAI, a publié une déclaration rassurante le mardi 28 avril. L'entreprise a précisé que ses produi

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai












