


 Hogar
Costes de la IA empresarial: Los modelos de Claude tienen un precio de implantación entre un 20 y un 30% superior al de GPT
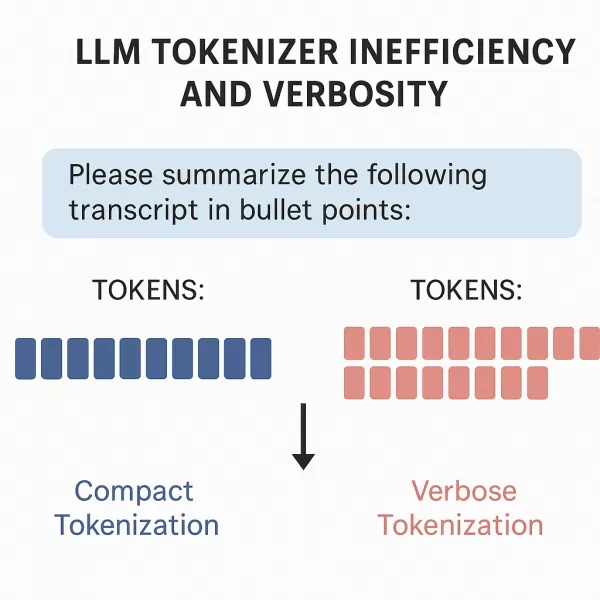
Es bien sabido que las distintas familias de modelos pueden emplear diferentes tokenizadores. Sin embargo, se ha investigado poco cómo varía el proceso de tokenización entre estos sistemas. ¿Producen todos los tokenizadores el mismo número de tokens para un texto de entrada idéntico? Si no es así, ¿hasta qué punto son sustanciales estas diferencias? ¿Qué implicaciones prácticas tienen?
Este artículo investiga estas cuestiones examinando las consecuencias en el mundo real de la variabilidad de la tokenización. Presentamos un análisis comparativo de dos de las principales familias de modelos: ChatGPT de OpenAI frente a Claude de Anthropic. Aunque sus tarifas anunciadas de "coste por token" parecen muy competitivas, nuestras pruebas revelan que los modelos de Anthropic pueden ser en realidad un 20-30% más caros que los modelos GPT en la práctica.
Precios de API - Claude 3.5 Sonnet frente a GPT-4o
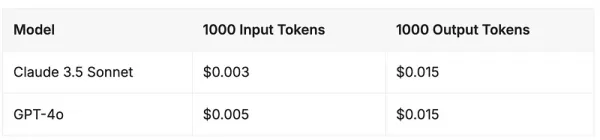
A partir de junio de 2024, las estructuras de precios de estos dos modelos de frontera avanzada están muy igualadas. Tanto Claude 3.5 Sonnet de Anthropic como GPT-4o de OpenAI mantienen costes idénticos para los tokens de salida, mientras que Claude 3.5 Sonnet ofrece un descuento del 40% en los tokens de entrada.
Fuente: Vantage
La ineficiencia oculta de la tokenización
A pesar de que las tasas de tokens de entrada de Anthropic son más bajas, nuestros experimentos con conjuntos de prompt fijos demuestran que GPT-4o ofrece sistemáticamente costes globales más económicos que Claude Sonnet-3.5.
¿Qué explica esta discrepancia?
El tokenizador de Anthropic suele segmentar un texto de entrada idéntico en más tokens que el método de OpenAI. Esto significa que, para las mismas instrucciones, los modelos de Anthropic generan un número de tokens significativamente mayor que sus equivalentes de OpenAI. En consecuencia, aunque el coste de entrada por token de Claude 3.5 Sonnet parece menor, el mayor volumen de tokenización a menudo anula este ahorro, lo que se traduce en mayores gastos totales para las implementaciones prácticas.
Este coste oculto se debe a la metodología de codificación de tokens de Anthropic, que a menudo requiere más tokens para representar un contenido equivalente. La inflación en el recuento de tokens afecta sustancialmente tanto a los costes operativos como a la eficiencia de la ventana de contexto.
Variaciones en la tokenización de dominios específicos
El tokenizador de Anthropic procesa diferentes dominios de contenido con distinta eficiencia, produciendo aumentos inconsistentes en el recuento de tokens en relación con los modelos de OpenAI. La comunidad investigadora en IA ha documentado disparidades similares en la tokenización. Hemos validado nuestros resultados en tres dominios destacados: Artículos en inglés, código Python y contenido matemático.
Dominio Modelo de entrada Tokens GPT Tokens Claude Sobrecarga de tokens Artículos en inglés 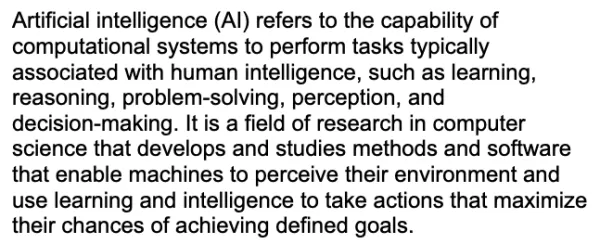 Implicaciones prácticas adicionales de las diferencias de tokenización
Más allá de los costes directos, la ineficacia del tokenizador afecta indirectamente a la utilización de la ventana de contexto. Aunque los modelos de Anthropic anuncian una ventana de contexto de 200.000 tokens frente a los 128.000 de OpenAI, la verbosidad de la tokenización puede reducir el espacio útil efectivo en los modelos de Anthropic. Esto crea una discrepancia potencial entre los tamaños de ventana de contexto anunciados y su capacidad práctica y efectiva.
Detalles de la implementación de la tokenización
Los modelos GPT utilizan la codificación por pares de bytes (BPE), que combina los pares de caracteres más frecuentes para formar tokens. Los últimos modelos de GPT emplean específicamente el tokenizador de código abierto o200k_base. Los tokens reales utilizados por GPT-4o dentro del tokenizador tiktoken son de acceso público.
JSON {#razonamiento "o1-xxx": "o200k_base","o3-xxx": "o200k_base",# chat"chatgpt-4o-": "o200k_base","gpt-4o-xxx": "o200k_base",# p.ej., gpt-4o-2024-05-13 "gpt-4-xxx": "cl100k_base",# p. ej., gpt-4-0314, etc., más gpt-4-32k "gpt-3.5-turbo-xxx": "cl100k_base",# p.ej., gpt-3.5-turbo-0301, -0401, etc.}
Por desgracia, el método de tokenización de Anthropic sigue siendo menos transparente, ya que su tokenizador no está tan disponible como el de GPT. Anthropic introdujo una API de recuento de tokens en diciembre de 2024, pero esta función se interrumpió en versiones posteriores de 2025.
Según Latenode, "Anthropic emplea un tokenizador único con sólo 65.000 variaciones de token, comparado con las 100.261 variaciones de OpenAI para GPT-4". Un cuaderno Colab de acceso público contiene código Python para analizar las diferencias de tokenización entre los modelos GPT y Claude. Otra herramienta que interactúa con tokenizadores comunes disponibles públicamente corrobora nuestros hallazgos.
Para las empresas de IA, la capacidad de estimar con precisión los recuentos de tokens sin invocar APIs de modelos reales es esencial para la previsión de costes y la elaboración de presupuestos.
Información esencial
- Los precios competitivos de Anthropic contienen gastos ocultos:
Aunque Claude 3.5 Sonnet ofrece unos costes de token de entrada un 40% más bajos que GPT-4o, esta aparente ventaja puede ser engañosa debido a diferencias fundamentales en la tokenización de texto. - La ineficacia oculta de la tokenización:
Los modelos antrópicos producen intrínsecamente más tokens. Para las organizaciones que procesan grandes volúmenes de texto, comprender esta variación es fundamental para evaluar con precisión los costes de implantación. - Rendimiento específico de la tokenización:
A la hora de elegir entre los modelos OpenAI y Anthropic, evalúe cuidadosamente su contenido de entrada típico. Mientras que las tareas de lenguaje natural pueden mostrar diferencias de coste mínimas, los dominios técnicos o estructurados podrían experimentar gastos significativamente mayores con los modelos de Anthropic. - Capacidad efectiva de ventana de contexto:
Debido a la verbosidad de la tokenización de Anthropic, su ventana de contexto anunciada de 200K podría proporcionar menos espacio útil práctico que los 128K de OpenAI, creando potencialmente una brecha entre la capacidad de contexto declarada y la real.
Anthropic no había respondido a la solicitud de comentarios de VentureBeat al cierre de esta edición. Actualizaremos este artículo si responden.
Artículo relacionado
 Anthropic lanza Opus 4.8, que incluye una nueva herramienta dinámica para el flujo de trabajo
Anthropic presentó el jueves Opus 4.8, la última versión de su modelo público estrella. Con un precio idéntico al de su predecesor, esta actualización ya está disponible en todas las plataformas.Con s
OpenAI lanza una versión más segura de ChatGPT para adolescentes, años después de que estos empezaran a utilizarla
Tras una serie de demandas relacionadas con la ausencia de protocolos de seguridad en los chatbots de IA —que contribuyeron a suicidios de adolescentes y otras crisis de salud mental—, OpenAI presentó
Frontier AI Labs se niega a revelar las estrategias de contención para los modelos rebeldes
Investigaciones recientes indican que muy pocos laboratorios líderes en IA han publicado o demostrado planes de respuesta de contención. Un plan de contención define los procedimientos a seguir cuando
Recomendaciones de temas especiales relacionados
escribiendo
 Herramientas de IA para la estructura de artículos en la redacción de textos extensos
¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
 9 herramientas
 xix.ai
chatbot
Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

 comentario (1)
0/500
![AnthonyGonzalez]()
Interesting pricing gap! But the tokenizer differences can really impact actual costs per task. I wonder if Claude's higher price is justified by better performance in certain use cases. 🤔
Es bien sabido que las distintas familias de modelos pueden emplear diferentes tokenizadores. Sin embargo, se ha investigado poco cómo varía el proceso de tokenización entre estos sistemas. ¿Producen todos los tokenizadores el mismo número de tokens para un texto de entrada idéntico? Si no es así, ¿hasta qué punto son sustanciales estas diferencias? ¿Qué implicaciones prácticas tienen?
Este artículo investiga estas cuestiones examinando las consecuencias en el mundo real de la variabilidad de la tokenización. Presentamos un análisis comparativo de dos de las principales familias de modelos: ChatGPT de OpenAI frente a Claude de Anthropic. Aunque sus tarifas anunciadas de "coste por token" parecen muy competitivas, nuestras pruebas revelan que los modelos de Anthropic pueden ser en realidad un 20-30% más caros que los modelos GPT en la práctica.
Precios de API - Claude 3.5 Sonnet frente a GPT-4o
A partir de junio de 2024, las estructuras de precios de estos dos modelos de frontera avanzada están muy igualadas. Tanto Claude 3.5 Sonnet de Anthropic como GPT-4o de OpenAI mantienen costes idénticos para los tokens de salida, mientras que Claude 3.5 Sonnet ofrece un descuento del 40% en los tokens de entrada.
Fuente: Vantage
La ineficiencia oculta de la tokenización
A pesar de que las tasas de tokens de entrada de Anthropic son más bajas, nuestros experimentos con conjuntos de prompt fijos demuestran que GPT-4o ofrece sistemáticamente costes globales más económicos que Claude Sonnet-3.5.
¿Qué explica esta discrepancia?
El tokenizador de Anthropic suele segmentar un texto de entrada idéntico en más tokens que el método de OpenAI. Esto significa que, para las mismas instrucciones, los modelos de Anthropic generan un número de tokens significativamente mayor que sus equivalentes de OpenAI. En consecuencia, aunque el coste de entrada por token de Claude 3.5 Sonnet parece menor, el mayor volumen de tokenización a menudo anula este ahorro, lo que se traduce en mayores gastos totales para las implementaciones prácticas.
Este coste oculto se debe a la metodología de codificación de tokens de Anthropic, que a menudo requiere más tokens para representar un contenido equivalente. La inflación en el recuento de tokens afecta sustancialmente tanto a los costes operativos como a la eficiencia de la ventana de contexto.
Variaciones en la tokenización de dominios específicos
El tokenizador de Anthropic procesa diferentes dominios de contenido con distinta eficiencia, produciendo aumentos inconsistentes en el recuento de tokens en relación con los modelos de OpenAI. La comunidad investigadora en IA ha documentado disparidades similares en la tokenización. Hemos validado nuestros resultados en tres dominios destacados: Artículos en inglés, código Python y contenido matemático.
| Dominio | Modelo de entrada | Tokens GPT | Tokens Claude | Sobrecarga de tokens |
| Artículos en inglés | Implicaciones prácticas adicionales de las diferencias de tokenización Más allá de los costes directos, la ineficacia del tokenizador afecta indirectamente a la utilización de la ventana de contexto. Aunque los modelos de Anthropic anuncian una ventana de contexto de 200.000 tokens frente a los 128.000 de OpenAI, la verbosidad de la tokenización puede reducir el espacio útil efectivo en los modelos de Anthropic. Esto crea una discrepancia potencial entre los tamaños de ventana de contexto anunciados y su capacidad práctica y efectiva. Detalles de la implementación de la tokenizaciónLos modelos GPT utilizan la codificación por pares de bytes (BPE), que combina los pares de caracteres más frecuentes para formar tokens. Los últimos modelos de GPT emplean específicamente el tokenizador de código abierto o200k_base. Los tokens reales utilizados por GPT-4o dentro del tokenizador tiktoken son de acceso público. Por desgracia, el método de tokenización de Anthropic sigue siendo menos transparente, ya que su tokenizador no está tan disponible como el de GPT. Anthropic introdujo una API de recuento de tokens en diciembre de 2024, pero esta función se interrumpió en versiones posteriores de 2025. Según Latenode, "Anthropic emplea un tokenizador único con sólo 65.000 variaciones de token, comparado con las 100.261 variaciones de OpenAI para GPT-4". Un cuaderno Colab de acceso público contiene código Python para analizar las diferencias de tokenización entre los modelos GPT y Claude. Otra herramienta que interactúa con tokenizadores comunes disponibles públicamente corrobora nuestros hallazgos. Información esencial
Anthropic no había respondido a la solicitud de comentarios de VentureBeat al cierre de esta edición. Actualizaremos este artículo si responden. |








 Anthropic lanza Opus 4.8, que incluye una nueva herramienta dinámica para el flujo de trabajo
Anthropic presentó el jueves Opus 4.8, la última versión de su modelo público estrella. Con un precio idéntico al de su predecesor, esta actualización ya está disponible en todas las plataformas.Con s
 OpenAI lanza una versión más segura de ChatGPT para adolescentes, años después de que estos empezaran a utilizarla
Tras una serie de demandas relacionadas con la ausencia de protocolos de seguridad en los chatbots de IA —que contribuyeron a suicidios de adolescentes y otras crisis de salud mental—, OpenAI presentó
 Frontier AI Labs se niega a revelar las estrategias de contención para los modelos rebeldes
Investigaciones recientes indican que muy pocos laboratorios líderes en IA han publicado o demostrado planes de respuesta de contención. Un plan de contención define los procedimientos a seguir cuando

¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

Interesting pricing gap! But the tokenizer differences can really impact actual costs per task. I wonder if Claude's higher price is justified by better performance in certain use cases. 🤔












