


 Heim
Langchain Tutorial: Eine Anleitung zum Zusammenfassen von YouTube-Videos
In unserer schnelllebigen digitalen Welt ist die Fähigkeit, die Kernaussage eines Videos schnell zu verstehen, unglaublich wertvoll. Für Forscher, Studenten und Berufstätige gleichermaßen kann die Erstellung prägnanter Zusammenfassungen langer YouTube-Videos eine große Zeitersparnis und Produktivitätssteigerung bedeuten. Dieser Leitfaden bietet eine klare, schrittweise Methode zur Verwendung von Langchain, OpenAI und Whisper, um automatisch Zusammenfassungen von YouTube-Inhalten zu erstellen. Sie lernen, wie Sie Python-Skripte in Google Colab schreiben, um Audio zu extrahieren, es in Text zu transkribieren und dann mit Hilfe von leistungsstarken KI-Modellen zu verdichten.
Wichtige Punkte
Lernen Sie die Verwendung von Langchain, OpenAI und Whisper für die automatische Zusammenfassung von Videos.
Schreiben Sie Python-Code in Google Colab, um Video-Audio herunterzuladen und zu transkribieren.
Wenden Sie Methoden zur Textaufteilung und -zusammenfassung an, um prägnante Übersichten zu erstellen.
Implementierung der Map-Reduce-Chain-Technik zur effizienten Zusammenfassung großer Dokumente.
Nutzung der OpenAI API für den Zugriff auf erweiterte Zusammenfassungsmodelle.
Verwenden Sie den RecursiveCharacterTextSplitter, um Text in kleinere, überschaubare Teile zu zerlegen.
Einrichten Ihrer Umgebung für die Videozusammenfassung
Erste Schritte mit Google Colab
Vergewissern Sie sich zunächst, dass Sie über ein Google-Konto verfügen, um auf Google Colab zuzugreifen, eine kostenlose, cloudbasierte Plattform, die sich ideal für die Ausführung von Python-Code eignet. Öffnen Sie Google Colab und erstellen Sie ein neues Notizbuch. Dies wird Ihr Arbeitsbereich für das Projekt der Videozusammenfassung sein. Benennen Sie das Notizbuch in einen einprägsamen Namen wie "YouTube_Summarizer" um, damit Sie den Überblick behalten.
Passen Sie nun die Laufzeitkonfiguration an.
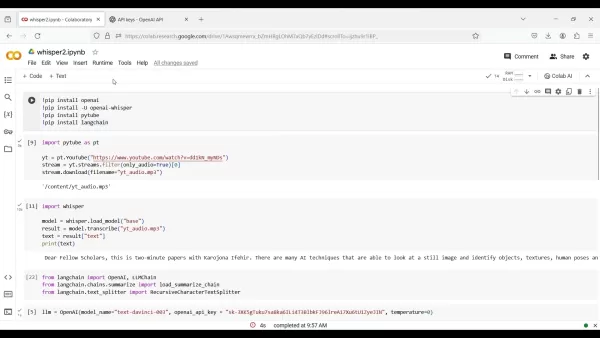
Gehen Sie zum Menü "Runtime" und wählen Sie "Change runtime type". Wählen Sie aus dem Dropdown-Menü "T4 GPU" als Hardware-Beschleuniger. Diese Auswahl nutzt die Rechenleistung des Grafikprozessors, um die Ausführung Ihres Codes zu beschleunigen. Speichern Sie die Einstellungen, um sie auf Ihre Colab-Umgebung anzuwenden. Nun können Sie die erforderlichen Pakete installieren.
Installieren der wichtigsten Python-Pakete
Bevor Sie den Code schreiben, müssen Sie die erforderlichen Python-Bibliotheken installieren. Diese Pakete stellen die Werkzeuge für die Audioextraktion, Transkription und Zusammenfassung bereit. Führen Sie die folgenden Befehle in einer Colab-Zelle mit pip install aus:
!pip install OpenAI!pip install -U openai-whisper!pip install pytube!pip install langchain
- OpenAI: Diese Bibliothek ermöglicht die Interaktion mit den Sprachmodellen von OpenAI, die für die Textzusammenfassung entscheidend sind.
- Whisper: OpenAIs automatisches Spracherkennungssystem (ASR), das für die Umwandlung von Audio in Text verwendet wird.
- Pytube: Eine Bibliothek zum Herunterladen von Audio direkt aus YouTube-Videos.
- Langchain: Ein leistungsfähiges Framework, das eine Standardschnittstelle für Chains und andere Tools bietet und die Erstellung von Anwendungen mit Sprachmodellen vereinfacht.
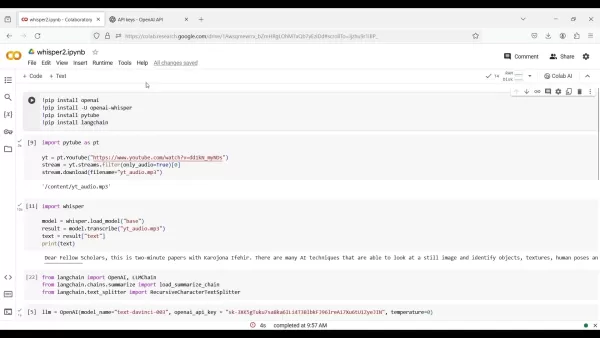
Mit diesen Befehlen werden die Bibliotheken OpenAI, Whisper, Pytube und Langchain installiert, so dass Sie alle für die nächsten Schritte benötigten Werkzeuge erhalten. Sobald die Installationen abgeschlossen sind, können Sie diese Pakete in Ihr Skript importieren.
Extrahieren von Audio aus YouTube-Videos
Importieren von Pytube und Laden des Videos
Importieren Sie zunächst die pytube-Bibliothek, mit der Sie Audio von YouTube herunterladen können. Nach dem Importieren geben Sie die URL des YouTube-Videos an, das Sie verarbeiten möchten.

Der folgende Code zeigt, wie man das macht:
import pytube as ptyt = pt.YouTube("https://www.youtube.com/watch?v=dd1kN_myNDs")stream = yt.streams.filter(only_audio=True)[0]stream.download(filename='yt_audio.mp3')
Dieser Code erstellt ein YouTube-Objekt unter Verwendung der angegebenen URL, filtert die verfügbaren Streams, um die Option "nur Audio" auszuwählen, und lädt es als MP3-Datei mit dem Namen yt_audio.mp3 herunter. Diese Datei wird im nächsten Schritt für die Transkription verwendet.
Transkription von Audio mit Whisper
Nachdem die Audiodatei heruntergeladen wurde, wird sie im nächsten Schritt mit dem Whisper-Modell von OpenAI in Text umgewandelt. Whisper ist ein robustes Werkzeug für die Konvertierung von Sprache in Text, das über die openai-whisper-Bibliothek verfügbar ist, die Sie zuvor installiert haben. So wird das Audio transkribiert:
import whispermodel = whisper.load_model("base")result = model.transcribe("yt_audio.mp3")text = result["text"]print(text)

Dieser Code lädt das Basismodell von Whisper, transkribiert die Datei yt_audio.mp3 und extrahiert den resultierenden Text. Der transkribierte Text wird auf der Konsole ausgegeben, sodass Sie eine schriftliche Version des Audioinhalts des Videos erhalten. Mit dem fertigen Text können Sie nun mit Langchain eine Zusammenfassung erstellen.
Zusammenfassen des transkribierten Textes mit Langchain
Jetzt, wo Sie den transkribierten Text haben, können Sie Langchain verwenden, um eine Zusammenfassung zu erstellen. Langchain bietet einen flexiblen Rahmen für die Textzusammenfassung unter Verwendung der Sprachmodelle von OpenAI. Bei diesem Prozess wird der Text in kleinere Segmente unterteilt und jedes Segment wird zusammengefasst, um einen endgültigen, prägnanten Überblick zu erhalten.
Folgen Sie diesen Schritten, um den Zusammenfassungsprozess mit Langchain einzurichten:
Importieren Sie die erforderlichen Module aus Langchain:
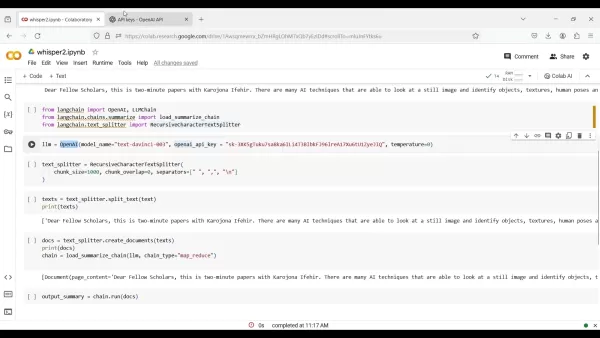
Dazu gehören Module für die OpenAI-Integration, LLM-Ketten, Zusammenfassungen und Textaufteilung.
from langchain import OpenAI, LLMChainfrom langchain.chains.summarize import load_summarize_chainfrom langchain.text_splitter import RecursiveCharacterTextSplitter
Initialisieren Sie das OpenAI-Sprachmodell:
llm = OpenAI(model_name="text-davinci-003", openai_api_key="YOUR_API_KEY", temperature=0)
Ersetzen Sie IHR_API_KEY durch Ihren tatsächlichen OpenAI-API-Schlüssel, den Sie von der OpenAI-Plattform erhalten.
Teilen Sie den transkribierten Text in überschaubare Abschnitte auf:
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=0, separators=["
", "", ". ", " ", ""])texts = text_splitter.split_text(text)
Dieser Code unterteilt den Text in Segmente von je 1000 Zeichen, ohne Überlappung. Der Parameter "Trennzeichen" stellt sicher, dass der Text an natürlichen Unterbrechungen wie Absätzen und Sätzen aufgeteilt wird.4.**Dokumente aus den Textabschnitten erstellen**:````pythondocs = [Document(page_content=t) for t in texts]
Laden Sie die Verdichtungskette:
chain = load_summarize_chain(llm, chain_type="map_reduce", verbose=False)
Dieser Code initialisiert die Verdichtungskette mit der Methode map_reduce. Dieser Ansatz ist effizient für große Dokumente, da er jedes Stück einzeln zusammenfasst (der map-Schritt) und dann diese Zusammenfassungen zu einer endgültigen Zusammenfassung kombiniert (der reduce-Schritt).
Führen Sie die Zusammenfassungskette aus:
output_summary = chain.run(docs)print(output_summary)
Damit wird der Zusammenfassungsprozess für die Dokumentenstücke ausgeführt und die endgültige Zusammenfassung gedruckt. Sie haben nun eine prägnante Zusammenfassung des Inhalts des ursprünglichen YouTube-Videos.
Wenn Sie diese Schritte befolgen, können Sie YouTube-Videos mit Langchain, OpenAI und Whisper effizient zusammenfassen, die Informationsextraktion automatisieren und Ihre Produktivität steigern.
Schritt-für-Schritt-Anleitung: Zusammenfassen von YouTube-Videos mit Code
Schritt 1: Öffnen Sie Google Colab und erstellen Sie ein neues Notizbuch
Öffnen Sie Ihren Webbrowser und rufen Sie die Google Colab-Website auf. Melden Sie sich mit Ihrem Google-Konto an. Sobald Sie eingeloggt sind, erstellen Sie ein neues Notizbuch, indem Sie auf "Neues Notizbuch" klicken. Dadurch wird eine saubere Codierungsumgebung für Ihr Projekt geöffnet.

Schritt 2: Konfigurieren Sie die Laufzeiteinstellungen
Um eine optimale Leistung, insbesondere für KI-Modelle, zu gewährleisten, konfigurieren Sie die Laufzeit für die Verwendung eines Grafikprozessors. Klicken Sie in der Menüleiste auf "Runtime" und wählen Sie dann "Change runtime type". Wählen Sie in der Dropdown-Liste "Hardwarebeschleuniger" die Option "GPU". Speichern Sie Ihre Änderungen. Dadurch wird Ihrer Sitzung ein Grafikprozessor zugewiesen, der die Verarbeitungsaufgaben beschleunigt.
Schritt 3: Erforderliche Bibliotheken installieren
Als nächstes installieren Sie die erforderlichen Python-Bibliotheken mit pip. Dazu gehören openai, openai-whisper, pytube und langchain. Führen Sie den folgenden Code in einer Colab-Zelle aus:
!pip install openai!pip install -U openai-whisper!pip install pytube!pip install langchain
Führen Sie die Zelle aus, um die Bibliotheken zu installieren. Stellen Sie sicher, dass die Installationen erfolgreich abgeschlossen sind, bevor Sie fortfahren.
Schritt 4: Bibliotheken importieren und OpenAI-API-Schlüssel einrichten
Importieren Sie die erforderlichen Bibliotheken in Ihr Notebook. Richten Sie außerdem Ihren OpenAI-API-Schlüssel ein, um den Zugriff auf die Sprachmodelle zu ermöglichen. Sie können einen API-Schlüssel auf der OpenAI-Plattform generieren. Ersetzen Sie YOUR_API_KEY durch Ihren tatsächlichen Schlüssel im Code.
import pytube as ptimport whisperfrom langchain import OpenAI, LLMChainfrom langchain.chains.summarize import load_summarize_chainfrom langchain.text_splitter import RecursiveCharacterTextSplitteropenai_api_key = "YOUR_API_KEY"
Schritt 5: Laden Sie das YouTube-Video und extrahieren Sie Audio
Geben Sie die URL des YouTube-Videos an und verwenden Sie pytube, um das Audio zu extrahieren. Der folgende Code erstellt ein YouTube-Objekt, filtert nach reinen Audio-Streams und lädt den Ton als MP3-Datei herunter:
yt = pt.YouTube("https://www.youtube.com/watch?v=dd1kN_myNDs")stream = yt.streams.filter(only_audio=True)[0]stream.download(filename='yt_audio.mp3')
Schritt 6: Transkribieren des Audios mit Whisper
Transkribieren Sie die heruntergeladene Audiodatei mit dem Whisper-Modell in Text. Laden Sie das Modell und verwenden Sie es zum Transkribieren des Audios:
model = whisper.load_model("base")result = model.transcribe("yt_audio.mp3")text = result["text"]print(text)
Schritt 7: Zusammenfassen des Textes mit Langchain
Fassen Sie den transkribierten Text mit Langchain zusammen. Dazu wird der Text in Teile zerlegt, aus ihnen werden Dokumente erstellt, und die endgültige Zusammenfassung wird mithilfe einer Zusammenfassungskette erstellt.
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=0, separators=["", "", ". ", " ", ""])texts = text_splitter.split_text(text)from langchain.document_loaders import TextLoaderfrom langchain.docstore.document import Documentdocs = [Document(page_content=t) for t in texts]llm = OpenAI(model_name="text-davinci-003", openai_api_key=openai_api_key, temperature=0)chain = load_summarize_chain(llm, chain_type="map_reduce", verbose=False)output_summary = chain.run(docs)print(output_summary)
Dieser Code teilt den Text auf, erstellt Dokumente, initialisiert die Zusammenfassungskette und führt sie aus, um die Zusammenfassung zu erstellen.
Schritt 8: Ausführen des Codes und Abrufen der Zusammenfassung
Führen Sie alle Codezellen in Ihrem Colab-Notizbuch aus. Dadurch wird die gesamte Zusammenfassungspipeline ausgeführt, vom Herunterladen der Audiodaten bis zur Erstellung der endgültigen Zusammenfassung. Die resultierende Zusammenfassung wird in der Konsole angezeigt.
Preiserwägungen für Langchain, OpenAI und Whisper
Verstehen der Kosten
Wenn Sie Langchain, OpenAI und Whisper verwenden, ist es wichtig, die jeweiligen Preismodelle zu verstehen, um Ihr Budget effektiv zu verwalten.
- OpenAI API: OpenAI rechnet auf Basis der Token-Nutzung ab. Die Kosten variieren je nach Modell (z. B. text-davinci-003) und der Anzahl der verarbeiteten Token. Die Abrechnung erfolgt in der Regel pro 1.000 Token, daher ist die Überwachung Ihrer Nutzung der Schlüssel zur Kostenkontrolle.
- Whisper: Sie können Whisper als API über OpenAI nutzen oder es selbst hosten. Wenn Sie die OpenAI-API verwenden, hängen die Transkriptionskosten von der Audiodauer ab.
- Langchain: Als Open-Source-Framework ist Langchain selbst kostenlos. Allerdings müssen Sie die Kosten für die integrierten Dienste, wie die OpenAI-APIs, die Sie über Langchain nutzen, berücksichtigen.
Vor- und Nachteile der Langchain-basierten Video-Zusammenfassung
Vorteile
Die Automatisierung spart eine Menge Zeit im Vergleich zur manuellen Zusammenfassung.
Erzeugt prägnante Zusammenfassungen, die die wichtigsten Punkte des Videos erfassen.
Anpassbare Einstellungen ermöglichen die Abstimmung der Zusammenfassung auf Ihre Bedürfnisse.
Nahtlose Integration mit leistungsstarken OpenAI-Sprachmodellen.
Da es Open-Source ist, bietet es Flexibilität und Unterstützung durch die Community.
Nachteile
Erfordert grundlegende Programmierkenntnisse zum Einrichten und Konfigurieren.
Die Genauigkeit der Zusammenfassung kann von der Qualität der Audiotranskription und des Sprachmodells abhängen.
Die Verwendung der OpenAI-API ist mit Kosten verbunden.
Bei der Transkription und Zusammenfassung können Fehler oder Ungenauigkeiten auftreten.
Möglicherweise werden nicht alle feinen Nuancen und der Kontext des Originalvideos erfasst.
Hauptmerkmale von Langchain für die Videozusammenfassung
Nutzung der Fähigkeiten von Langchain
Langchain bietet mehrere Funktionen, die die Videozusammenfassung effizienter machen:
- Kettenabstraktion: Bietet eine standardisierte Methode zur Erstellung von Ketten, die es einfach macht, verschiedene Komponenten wie Sprachmodelle und Textsplitter in einem kohärenten Arbeitsablauf zu kombinieren.
- Textaufteilung: Enthält verschiedene Methoden zur Aufteilung von Text, wie z. B. den
RecursiveCharacterTextSplitter, der Text auf der Grundlage bestimmter Trennzeichen wie Absätze und Sätze aufteilt. - Zusammenfassungs-Ketten: Bietet vorgefertigte Ketten wie
load_summarize_chain, die Techniken wie map_reduce verwenden, um große Dokumente effektiv zusammenzufassen.
Vielfältige Anwendungsfälle für die automatisierte Videozusammenfassung
Anwendungen in verschiedenen Domänen
Die automatisierte Videozusammenfassung hat zahlreiche praktische Anwendungen in verschiedenen Bereichen:
- Bildung: Studenten und Lehrer können Vorlesungsvideos schnell durchsehen, Schlüsselideen extrahieren und Lernhilfen erstellen.
- Forschung: Forscher können Videoinhalte effizient analysieren, relevante Daten extrahieren und Muster erkennen.
- Unternehmen: Fachleute können sich über Branchentrends informieren, Inhalte von Wettbewerbern analysieren und zusammenfassende Berichte erstellen.
- Medienbeobachtung: Agenturen können Nachrichtensendungen verfolgen, die öffentliche Meinung analysieren und aufkommende Themen identifizieren.
Häufig gestellte Fragen
Was ist Langchain, und wie erleichtert es die Zusammenfassung von Videos?
Langchain ist ein Framework, das die Erstellung von Anwendungen mit Sprachmodellen vereinfachen soll. Es bietet eine Standardschnittstelle für die Erstellung von Operationsketten. Bei der Videozusammenfassung hilft Langchain bei der Verwaltung des gesamten Prozesses - von der Verarbeitung des transkribierten Textes bis zur Erstellung der endgültigen Zusammenfassung - und ist damit ein flexibles und leistungsstarkes Werkzeug.
Wie erhalte ich einen OpenAI-API-Schlüssel, und warum ist er für die Videozusammenfassung notwendig?
Ein OpenAI-API-Schlüssel ist erforderlich, um sich zu authentifizieren und die Sprachmodelle von OpenAI für die Textzusammenfassung zu verwenden. Sie können einen API-Schlüssel erhalten, indem Sie sich auf der OpenAI-Plattform anmelden und einen Schlüssel in Ihren Kontoeinstellungen generieren. Dieser Schlüssel ermöglicht es Ihrem Skript, auf die Modelle zuzugreifen, die die Zusammenfassung ermöglichen.
Was sind die wichtigsten Überlegungen zum Kostenmanagement bei der Verwendung von Langchain, OpenAI und Whisper?
Um die Kosten effektiv zu verwalten, sollten Sie Ihre Token-Nutzung für die OpenAI-API im Auge behalten, da die Abrechnung auf dem Verbrauch basiert. Optimieren Sie Ihren Code durch die Verwendung geeigneter Textchunk-Größen und erwägen Sie die Verwendung weniger teurer Modelle für einfachere Aufgaben. Bei Whisper richten sich die Kosten bei Verwendung der API nach der Audiolänge, sodass die Verarbeitung kürzerer Clips oder die Verwendung einer selbst gehosteten Version zur Kostenkontrolle beitragen kann.
Erforschen Sie weiter: Verwandte Fragen und fortgeschrittene Techniken
Wie kann ich die Genauigkeit der Videozusammenfassung mit Langchain verbessern?
Um die Genauigkeit der Zusammenfassung zu verbessern, müssen verschiedene Parameter und Techniken angepasst werden. Ziehen Sie folgende Strategien in Betracht:Experimentieren Sie mit verschiedenen Texttrennern:Texttrenner für Zeichen: Teilt Text auf der Grundlage von Zeichen auf, wodurch die Satzstruktur beibehalten werden kann.Rekursiver Zeichentextteiler: Teilt den Text rekursiv anhand einer Liste von Trennzeichen auf und ermöglicht so eine intelligentere Aufteilung.Token Text Splitter: Testen Sie verschiedene Splitter, um herauszufinden, welcher für Ihren spezifischen Videoinhalt am besten geeignet ist.Passen Sie die Stückgröße und Überlappung an:Stückgröße: Die Größe der Textsegmente wirkt sich auf die Zusammenfassung aus. Kleinere Abschnitte können detailliertere Zusammenfassungen ergeben, während größere Abschnitte mehr Kontext bieten.Überlappung von Abschnitten: Überschneidungen zwischen den Abschnitten können dazu beitragen, den Kontext zu erhalten. Experimentieren Sie mit verschiedenen Größen und Überlappungen, um die beste Balance zu finden.Wählen Sie ein leistungsfähigeres Sprachmodell:OpenAI bietet verschiedene Modelle mit
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

 Kommentare (1)
![HenryLopez]()
這篇教學太實用了!我常常需要看很多英文教學影片,如果能自動生成摘要真的會省下超多時間。不過我有點擔心,如果AI摘要漏掉重要細節怎麼辦?大家會完全依賴這個功能嗎?🤔
In unserer schnelllebigen digitalen Welt ist die Fähigkeit, die Kernaussage eines Videos schnell zu verstehen, unglaublich wertvoll. Für Forscher, Studenten und Berufstätige gleichermaßen kann die Erstellung prägnanter Zusammenfassungen langer YouTube-Videos eine große Zeitersparnis und Produktivitätssteigerung bedeuten. Dieser Leitfaden bietet eine klare, schrittweise Methode zur Verwendung von Langchain, OpenAI und Whisper, um automatisch Zusammenfassungen von YouTube-Inhalten zu erstellen. Sie lernen, wie Sie Python-Skripte in Google Colab schreiben, um Audio zu extrahieren, es in Text zu transkribieren und dann mit Hilfe von leistungsstarken KI-Modellen zu verdichten.
Wichtige Punkte
Lernen Sie die Verwendung von Langchain, OpenAI und Whisper für die automatische Zusammenfassung von Videos.
Schreiben Sie Python-Code in Google Colab, um Video-Audio herunterzuladen und zu transkribieren.
Wenden Sie Methoden zur Textaufteilung und -zusammenfassung an, um prägnante Übersichten zu erstellen.
Implementierung der Map-Reduce-Chain-Technik zur effizienten Zusammenfassung großer Dokumente.
Nutzung der OpenAI API für den Zugriff auf erweiterte Zusammenfassungsmodelle.
Verwenden Sie den RecursiveCharacterTextSplitter, um Text in kleinere, überschaubare Teile zu zerlegen.
Einrichten Ihrer Umgebung für die Videozusammenfassung
Erste Schritte mit Google Colab
Vergewissern Sie sich zunächst, dass Sie über ein Google-Konto verfügen, um auf Google Colab zuzugreifen, eine kostenlose, cloudbasierte Plattform, die sich ideal für die Ausführung von Python-Code eignet. Öffnen Sie Google Colab und erstellen Sie ein neues Notizbuch. Dies wird Ihr Arbeitsbereich für das Projekt der Videozusammenfassung sein. Benennen Sie das Notizbuch in einen einprägsamen Namen wie "YouTube_Summarizer" um, damit Sie den Überblick behalten.
Passen Sie nun die Laufzeitkonfiguration an.
Gehen Sie zum Menü "Runtime" und wählen Sie "Change runtime type". Wählen Sie aus dem Dropdown-Menü "T4 GPU" als Hardware-Beschleuniger. Diese Auswahl nutzt die Rechenleistung des Grafikprozessors, um die Ausführung Ihres Codes zu beschleunigen. Speichern Sie die Einstellungen, um sie auf Ihre Colab-Umgebung anzuwenden. Nun können Sie die erforderlichen Pakete installieren.
Installieren der wichtigsten Python-Pakete
Bevor Sie den Code schreiben, müssen Sie die erforderlichen Python-Bibliotheken installieren. Diese Pakete stellen die Werkzeuge für die Audioextraktion, Transkription und Zusammenfassung bereit. Führen Sie die folgenden Befehle in einer Colab-Zelle mit pip install aus:
!pip install OpenAI!pip install -U openai-whisper!pip install pytube!pip install langchain
- OpenAI: Diese Bibliothek ermöglicht die Interaktion mit den Sprachmodellen von OpenAI, die für die Textzusammenfassung entscheidend sind.
- Whisper: OpenAIs automatisches Spracherkennungssystem (ASR), das für die Umwandlung von Audio in Text verwendet wird.
- Pytube: Eine Bibliothek zum Herunterladen von Audio direkt aus YouTube-Videos.
- Langchain: Ein leistungsfähiges Framework, das eine Standardschnittstelle für Chains und andere Tools bietet und die Erstellung von Anwendungen mit Sprachmodellen vereinfacht.
Mit diesen Befehlen werden die Bibliotheken OpenAI, Whisper, Pytube und Langchain installiert, so dass Sie alle für die nächsten Schritte benötigten Werkzeuge erhalten. Sobald die Installationen abgeschlossen sind, können Sie diese Pakete in Ihr Skript importieren.
Extrahieren von Audio aus YouTube-Videos
Importieren von Pytube und Laden des Videos
Importieren Sie zunächst die pytube-Bibliothek, mit der Sie Audio von YouTube herunterladen können. Nach dem Importieren geben Sie die URL des YouTube-Videos an, das Sie verarbeiten möchten.
Der folgende Code zeigt, wie man das macht:
import pytube as ptyt = pt.YouTube("https://www.youtube.com/watch?v=dd1kN_myNDs")stream = yt.streams.filter(only_audio=True)[0]stream.download(filename='yt_audio.mp3')
Dieser Code erstellt ein YouTube-Objekt unter Verwendung der angegebenen URL, filtert die verfügbaren Streams, um die Option "nur Audio" auszuwählen, und lädt es als MP3-Datei mit dem Namen yt_audio.mp3 herunter. Diese Datei wird im nächsten Schritt für die Transkription verwendet.
Transkription von Audio mit Whisper
Nachdem die Audiodatei heruntergeladen wurde, wird sie im nächsten Schritt mit dem Whisper-Modell von OpenAI in Text umgewandelt. Whisper ist ein robustes Werkzeug für die Konvertierung von Sprache in Text, das über die openai-whisper-Bibliothek verfügbar ist, die Sie zuvor installiert haben. So wird das Audio transkribiert:
import whispermodel = whisper.load_model("base")result = model.transcribe("yt_audio.mp3")text = result["text"]print(text)
Dieser Code lädt das Basismodell von Whisper, transkribiert die Datei yt_audio.mp3 und extrahiert den resultierenden Text. Der transkribierte Text wird auf der Konsole ausgegeben, sodass Sie eine schriftliche Version des Audioinhalts des Videos erhalten. Mit dem fertigen Text können Sie nun mit Langchain eine Zusammenfassung erstellen.
Zusammenfassen des transkribierten Textes mit Langchain
Jetzt, wo Sie den transkribierten Text haben, können Sie Langchain verwenden, um eine Zusammenfassung zu erstellen. Langchain bietet einen flexiblen Rahmen für die Textzusammenfassung unter Verwendung der Sprachmodelle von OpenAI. Bei diesem Prozess wird der Text in kleinere Segmente unterteilt und jedes Segment wird zusammengefasst, um einen endgültigen, prägnanten Überblick zu erhalten.
Folgen Sie diesen Schritten, um den Zusammenfassungsprozess mit Langchain einzurichten:
Importieren Sie die erforderlichen Module aus Langchain:
Dazu gehören Module für die OpenAI-Integration, LLM-Ketten, Zusammenfassungen und Textaufteilung.
from langchain import OpenAI, LLMChainfrom langchain.chains.summarize import load_summarize_chainfrom langchain.text_splitter import RecursiveCharacterTextSplitterInitialisieren Sie das OpenAI-Sprachmodell:
llm = OpenAI(model_name="text-davinci-003", openai_api_key="YOUR_API_KEY", temperature=0)Ersetzen Sie
IHR_API_KEYdurch Ihren tatsächlichen OpenAI-API-Schlüssel, den Sie von der OpenAI-Plattform erhalten.Teilen Sie den transkribierten Text in überschaubare Abschnitte auf:
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=0, separators=["
", "", ". ", " ", ""])texts = text_splitter.split_text(text)
Dieser Code unterteilt den Text in Segmente von je 1000 Zeichen, ohne Überlappung. Der Parameter "Trennzeichen" stellt sicher, dass der Text an natürlichen Unterbrechungen wie Absätzen und Sätzen aufgeteilt wird.4.**Dokumente aus den Textabschnitten erstellen**:````pythondocs = [Document(page_content=t) for t in texts]
Laden Sie die Verdichtungskette:
chain = load_summarize_chain(llm, chain_type="map_reduce", verbose=False)Dieser Code initialisiert die Verdichtungskette mit der Methode
map_reduce. Dieser Ansatz ist effizient für große Dokumente, da er jedes Stück einzeln zusammenfasst (der map-Schritt) und dann diese Zusammenfassungen zu einer endgültigen Zusammenfassung kombiniert (der reduce-Schritt).Führen Sie die Zusammenfassungskette aus:
output_summary = chain.run(docs)print(output_summary)Damit wird der Zusammenfassungsprozess für die Dokumentenstücke ausgeführt und die endgültige Zusammenfassung gedruckt. Sie haben nun eine prägnante Zusammenfassung des Inhalts des ursprünglichen YouTube-Videos.
Wenn Sie diese Schritte befolgen, können Sie YouTube-Videos mit Langchain, OpenAI und Whisper effizient zusammenfassen, die Informationsextraktion automatisieren und Ihre Produktivität steigern.
Schritt-für-Schritt-Anleitung: Zusammenfassen von YouTube-Videos mit Code
Schritt 1: Öffnen Sie Google Colab und erstellen Sie ein neues Notizbuch
Öffnen Sie Ihren Webbrowser und rufen Sie die Google Colab-Website auf. Melden Sie sich mit Ihrem Google-Konto an. Sobald Sie eingeloggt sind, erstellen Sie ein neues Notizbuch, indem Sie auf "Neues Notizbuch" klicken. Dadurch wird eine saubere Codierungsumgebung für Ihr Projekt geöffnet.
Schritt 2: Konfigurieren Sie die Laufzeiteinstellungen
Um eine optimale Leistung, insbesondere für KI-Modelle, zu gewährleisten, konfigurieren Sie die Laufzeit für die Verwendung eines Grafikprozessors. Klicken Sie in der Menüleiste auf "Runtime" und wählen Sie dann "Change runtime type". Wählen Sie in der Dropdown-Liste "Hardwarebeschleuniger" die Option "GPU". Speichern Sie Ihre Änderungen. Dadurch wird Ihrer Sitzung ein Grafikprozessor zugewiesen, der die Verarbeitungsaufgaben beschleunigt.
Schritt 3: Erforderliche Bibliotheken installieren
Als nächstes installieren Sie die erforderlichen Python-Bibliotheken mit pip. Dazu gehören openai, openai-whisper, pytube und langchain. Führen Sie den folgenden Code in einer Colab-Zelle aus:
!pip install openai!pip install -U openai-whisper!pip install pytube!pip install langchain
Führen Sie die Zelle aus, um die Bibliotheken zu installieren. Stellen Sie sicher, dass die Installationen erfolgreich abgeschlossen sind, bevor Sie fortfahren.
Schritt 4: Bibliotheken importieren und OpenAI-API-Schlüssel einrichten
Importieren Sie die erforderlichen Bibliotheken in Ihr Notebook. Richten Sie außerdem Ihren OpenAI-API-Schlüssel ein, um den Zugriff auf die Sprachmodelle zu ermöglichen. Sie können einen API-Schlüssel auf der OpenAI-Plattform generieren. Ersetzen Sie YOUR_API_KEY durch Ihren tatsächlichen Schlüssel im Code.
import pytube as ptimport whisperfrom langchain import OpenAI, LLMChainfrom langchain.chains.summarize import load_summarize_chainfrom langchain.text_splitter import RecursiveCharacterTextSplitteropenai_api_key = "YOUR_API_KEY"
Schritt 5: Laden Sie das YouTube-Video und extrahieren Sie Audio
Geben Sie die URL des YouTube-Videos an und verwenden Sie pytube, um das Audio zu extrahieren. Der folgende Code erstellt ein YouTube-Objekt, filtert nach reinen Audio-Streams und lädt den Ton als MP3-Datei herunter:
yt = pt.YouTube("https://www.youtube.com/watch?v=dd1kN_myNDs")stream = yt.streams.filter(only_audio=True)[0]stream.download(filename='yt_audio.mp3')
Schritt 6: Transkribieren des Audios mit Whisper
Transkribieren Sie die heruntergeladene Audiodatei mit dem Whisper-Modell in Text. Laden Sie das Modell und verwenden Sie es zum Transkribieren des Audios:
model = whisper.load_model("base")result = model.transcribe("yt_audio.mp3")text = result["text"]print(text)
Schritt 7: Zusammenfassen des Textes mit Langchain
Fassen Sie den transkribierten Text mit Langchain zusammen. Dazu wird der Text in Teile zerlegt, aus ihnen werden Dokumente erstellt, und die endgültige Zusammenfassung wird mithilfe einer Zusammenfassungskette erstellt.
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=0, separators=["", "", ". ", " ", ""])texts = text_splitter.split_text(text)from langchain.document_loaders import TextLoaderfrom langchain.docstore.document import Documentdocs = [Document(page_content=t) for t in texts]llm = OpenAI(model_name="text-davinci-003", openai_api_key=openai_api_key, temperature=0)chain = load_summarize_chain(llm, chain_type="map_reduce", verbose=False)output_summary = chain.run(docs)print(output_summary)
Dieser Code teilt den Text auf, erstellt Dokumente, initialisiert die Zusammenfassungskette und führt sie aus, um die Zusammenfassung zu erstellen.
Schritt 8: Ausführen des Codes und Abrufen der Zusammenfassung
Führen Sie alle Codezellen in Ihrem Colab-Notizbuch aus. Dadurch wird die gesamte Zusammenfassungspipeline ausgeführt, vom Herunterladen der Audiodaten bis zur Erstellung der endgültigen Zusammenfassung. Die resultierende Zusammenfassung wird in der Konsole angezeigt.
Preiserwägungen für Langchain, OpenAI und Whisper
Verstehen der Kosten
Wenn Sie Langchain, OpenAI und Whisper verwenden, ist es wichtig, die jeweiligen Preismodelle zu verstehen, um Ihr Budget effektiv zu verwalten.
- OpenAI API: OpenAI rechnet auf Basis der Token-Nutzung ab. Die Kosten variieren je nach Modell (z. B. text-davinci-003) und der Anzahl der verarbeiteten Token. Die Abrechnung erfolgt in der Regel pro 1.000 Token, daher ist die Überwachung Ihrer Nutzung der Schlüssel zur Kostenkontrolle.
- Whisper: Sie können Whisper als API über OpenAI nutzen oder es selbst hosten. Wenn Sie die OpenAI-API verwenden, hängen die Transkriptionskosten von der Audiodauer ab.
- Langchain: Als Open-Source-Framework ist Langchain selbst kostenlos. Allerdings müssen Sie die Kosten für die integrierten Dienste, wie die OpenAI-APIs, die Sie über Langchain nutzen, berücksichtigen.
Vor- und Nachteile der Langchain-basierten Video-Zusammenfassung
Vorteile
Die Automatisierung spart eine Menge Zeit im Vergleich zur manuellen Zusammenfassung.
Erzeugt prägnante Zusammenfassungen, die die wichtigsten Punkte des Videos erfassen.
Anpassbare Einstellungen ermöglichen die Abstimmung der Zusammenfassung auf Ihre Bedürfnisse.
Nahtlose Integration mit leistungsstarken OpenAI-Sprachmodellen.
Da es Open-Source ist, bietet es Flexibilität und Unterstützung durch die Community.
Nachteile
Erfordert grundlegende Programmierkenntnisse zum Einrichten und Konfigurieren.
Die Genauigkeit der Zusammenfassung kann von der Qualität der Audiotranskription und des Sprachmodells abhängen.
Die Verwendung der OpenAI-API ist mit Kosten verbunden.
Bei der Transkription und Zusammenfassung können Fehler oder Ungenauigkeiten auftreten.
Möglicherweise werden nicht alle feinen Nuancen und der Kontext des Originalvideos erfasst.
Hauptmerkmale von Langchain für die Videozusammenfassung
Nutzung der Fähigkeiten von Langchain
Langchain bietet mehrere Funktionen, die die Videozusammenfassung effizienter machen:
- Kettenabstraktion: Bietet eine standardisierte Methode zur Erstellung von Ketten, die es einfach macht, verschiedene Komponenten wie Sprachmodelle und Textsplitter in einem kohärenten Arbeitsablauf zu kombinieren.
- Textaufteilung: Enthält verschiedene Methoden zur Aufteilung von Text, wie z. B. den
RecursiveCharacterTextSplitter, der Text auf der Grundlage bestimmter Trennzeichen wie Absätze und Sätze aufteilt. - Zusammenfassungs-Ketten: Bietet vorgefertigte Ketten wie
load_summarize_chain, die Techniken wiemap_reduceverwenden, um große Dokumente effektiv zusammenzufassen.
Vielfältige Anwendungsfälle für die automatisierte Videozusammenfassung
Anwendungen in verschiedenen Domänen
Die automatisierte Videozusammenfassung hat zahlreiche praktische Anwendungen in verschiedenen Bereichen:
- Bildung: Studenten und Lehrer können Vorlesungsvideos schnell durchsehen, Schlüsselideen extrahieren und Lernhilfen erstellen.
- Forschung: Forscher können Videoinhalte effizient analysieren, relevante Daten extrahieren und Muster erkennen.
- Unternehmen: Fachleute können sich über Branchentrends informieren, Inhalte von Wettbewerbern analysieren und zusammenfassende Berichte erstellen.
- Medienbeobachtung: Agenturen können Nachrichtensendungen verfolgen, die öffentliche Meinung analysieren und aufkommende Themen identifizieren.
Häufig gestellte Fragen
Was ist Langchain, und wie erleichtert es die Zusammenfassung von Videos?
Langchain ist ein Framework, das die Erstellung von Anwendungen mit Sprachmodellen vereinfachen soll. Es bietet eine Standardschnittstelle für die Erstellung von Operationsketten. Bei der Videozusammenfassung hilft Langchain bei der Verwaltung des gesamten Prozesses - von der Verarbeitung des transkribierten Textes bis zur Erstellung der endgültigen Zusammenfassung - und ist damit ein flexibles und leistungsstarkes Werkzeug.
Wie erhalte ich einen OpenAI-API-Schlüssel, und warum ist er für die Videozusammenfassung notwendig?
Ein OpenAI-API-Schlüssel ist erforderlich, um sich zu authentifizieren und die Sprachmodelle von OpenAI für die Textzusammenfassung zu verwenden. Sie können einen API-Schlüssel erhalten, indem Sie sich auf der OpenAI-Plattform anmelden und einen Schlüssel in Ihren Kontoeinstellungen generieren. Dieser Schlüssel ermöglicht es Ihrem Skript, auf die Modelle zuzugreifen, die die Zusammenfassung ermöglichen.
Was sind die wichtigsten Überlegungen zum Kostenmanagement bei der Verwendung von Langchain, OpenAI und Whisper?
Um die Kosten effektiv zu verwalten, sollten Sie Ihre Token-Nutzung für die OpenAI-API im Auge behalten, da die Abrechnung auf dem Verbrauch basiert. Optimieren Sie Ihren Code durch die Verwendung geeigneter Textchunk-Größen und erwägen Sie die Verwendung weniger teurer Modelle für einfachere Aufgaben. Bei Whisper richten sich die Kosten bei Verwendung der API nach der Audiolänge, sodass die Verarbeitung kürzerer Clips oder die Verwendung einer selbst gehosteten Version zur Kostenkontrolle beitragen kann.
Erforschen Sie weiter: Verwandte Fragen und fortgeschrittene Techniken
Wie kann ich die Genauigkeit der Videozusammenfassung mit Langchain verbessern?
Um die Genauigkeit der Zusammenfassung zu verbessern, müssen verschiedene Parameter und Techniken angepasst werden. Ziehen Sie folgende Strategien in Betracht:Experimentieren Sie mit verschiedenen Texttrennern:Texttrenner für Zeichen: Teilt Text auf der Grundlage von Zeichen auf, wodurch die Satzstruktur beibehalten werden kann.Rekursiver Zeichentextteiler: Teilt den Text rekursiv anhand einer Liste von Trennzeichen auf und ermöglicht so eine intelligentere Aufteilung.Token Text Splitter: Testen Sie verschiedene Splitter, um herauszufinden, welcher für Ihren spezifischen Videoinhalt am besten geeignet ist.Passen Sie die Stückgröße und Überlappung an:Stückgröße: Die Größe der Textsegmente wirkt sich auf die Zusammenfassung aus. Kleinere Abschnitte können detailliertere Zusammenfassungen ergeben, während größere Abschnitte mehr Kontext bieten.Überlappung von Abschnitten: Überschneidungen zwischen den Abschnitten können dazu beitragen, den Kontext zu erhalten. Experimentieren Sie mit verschiedenen Größen und Überlappungen, um die beste Balance zu finden.Wählen Sie ein leistungsfähigeres Sprachmodell:OpenAI bietet verschiedene Modelle mit








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

這篇教學太實用了!我常常需要看很多英文教學影片,如果能自動生成摘要真的會省下超多時間。不過我有點擔心,如果AI摘要漏掉重要細節怎麼辦?大家會完全依賴這個功能嗎?🤔












