首页

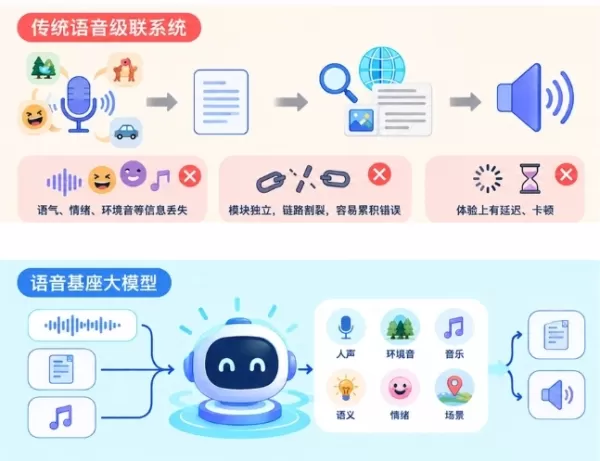
科大讯飞发布了 Spark-Audio-1.0-Preview,这是一款基于完全自主可控算力训练而成的语音基础模型。与将语音转换为文本的传统级联系统不同,该模型直接理解音频内容,能够捕捉语义、情感以及环境声音。该模型采用 0.65B 音频编码器与 30B-A3B 大语言模型构建,支持 99 种语言和 202 种方言。在嘈杂场景下,其性能优于竞争对手,并在中国语-英语识别任务中达到了当前最佳水平(SOTA)。该模型支持情感分析、复杂问答等任务,标志着从单纯语音转录向真正音频理解的转变。后续将通过讯飞开放平台提供 API 访问接口。
评论 (0)
0/300