Heim

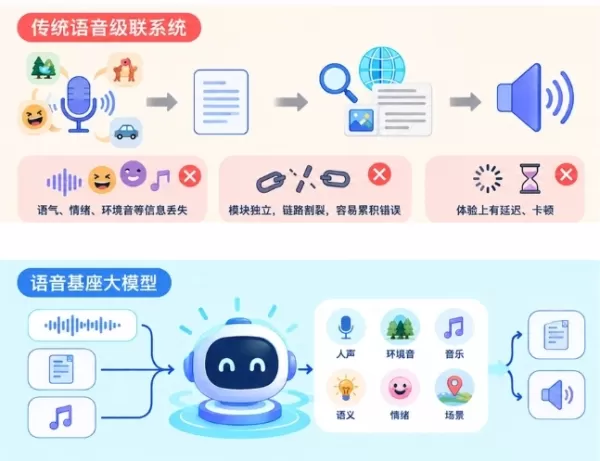
iFLYTEK hat Spark-Audio-1.0-Preview veröffentlicht, ein Spracherkennungs-Fundamentalmodell, das auf vollständig inländischer Rechenleistung trainiert wurde. Im Gegensatz zu herkömmlichen kaskadierten Systemen, die Sprache in Text umwandeln, versteht dieses Modell Audio direkt und erfasst Semantik, Emotionen sowie Umgebungsgeräusche. Es basiert auf einem 0,65B-Audioencoder und einem 30B-A3B-LLM und unterstützt 99 Sprachen sowie 202 Dialekte. Es übertrifft Mitbewerber in lauten Umgebungen und erzielt State-of-the-Art-Ergebnisse bei der chinesisch-englischen Spracherkennung. Das Modell ermöglicht Aufgaben wie Sentimentanalyse und komplexe Frage-Antwort-Systeme und markiert damit einen Wandel von der reinen Transkription hin zum echten Audioverständnis. Der API-Zugriff wird über die iFLYTEK Open Platform bereitgestellt.
Kommentare (0)
0/300