Lar

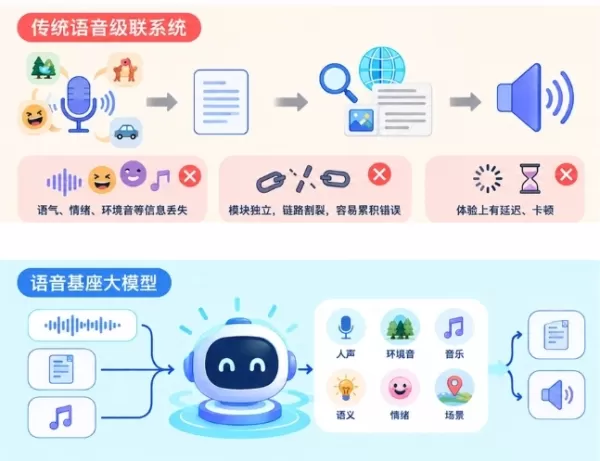
A iFLYTEK lançou o Spark-Audio-1.0-Preview, um modelo de base para fala treinado com poder computacional totalmente nacional. Diferente dos sistemas em cascata tradicionais que convertem fala em texto, este modelo compreende diretamente o áudio, capturando semântica, emoções e sons ambientes. Construído com um codificador de áudio de 0,65B e um LLM de 30B-A3B, ele suporta 99 idiomas e 202 dialetos. Ele supera concorrentes em cenários ruidosos e alcança o estado da arte (SOTA) no reconhecimento chinês-inglês. O modelo permite tarefas como análise de sentimento e perguntas e respostas complexas, marcando uma transição da transcrição para a verdadeira compreensão de áudio. O acesso via API será disponibilizado posteriormente pela Plataforma Aberta da iFLYTEK.
Comentários (0)
0/300