Hogar

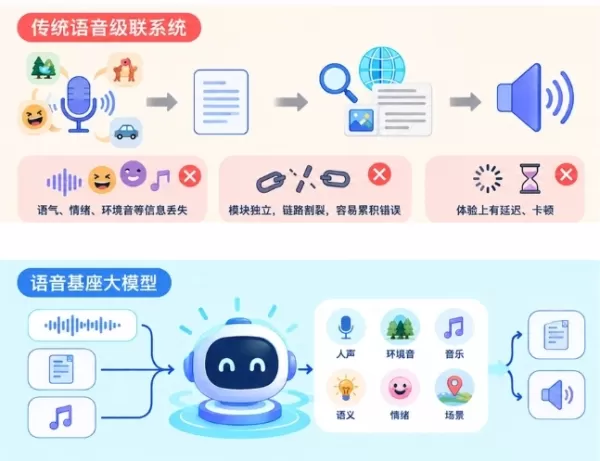
iFLYTEK lanzó Spark-Audio-1.0-Preview, un modelo base de voz entrenado con potencia computacional completamente nacional. A diferencia de los sistemas en cascada tradicionales que convierten el habla en texto, este modelo comprende directamente el audio, capturando semántica, emociones y sonidos ambientales. Construido con un codificador de audio de 0.65B y un LLM de 30B-A3B, admite 99 idiomas y 202 dialectos. Supera a la competencia en escenarios ruidosos y alcanza el estado del arte (SOTA) en reconocimiento chino-inglés. El modelo permite tareas como análisis de sentimiento y preguntas y respuestas complejas, marcando un cambio desde la transcripción hacia una verdadera comprensión del audio. El acceso mediante API estará disponible próximamente a través de la Plataforma Abierta de iFLYTEK.
comentario (0)
0/300