Maison

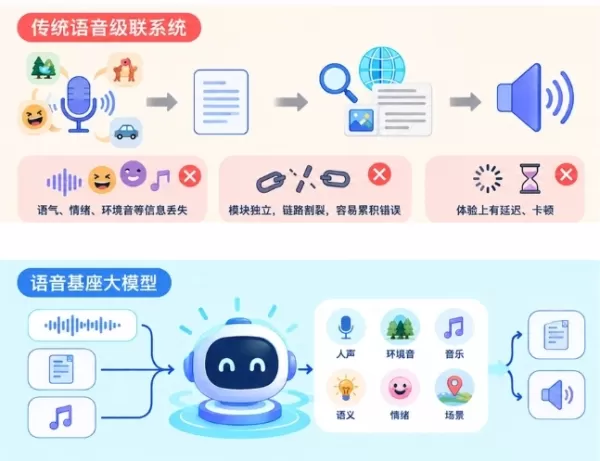
iFLYTEK a publié Spark-Audio-1.0-Preview, un modèle de base pour la parole entraîné sur une puissance de calcul entièrement nationale. Contrairement aux systèmes en cascade traditionnels qui convertissent la parole en texte, ce modèle comprend directement l’audio, en captant les sémantiques, les émotions et les sons ambiants. Conçu avec un encodeur audio de 0,65 milliard de paramètres et un LLM de 30 milliards de paramètres (architecture A3B), il prend en charge 99 langues et 202 dialectes. Il surpasse ses concurrents dans des environnements bruyants et atteint l’état de l’art (SOTA) en reconnaissance chinois-anglais. Le modèle permet des tâches telles que l’analyse des sentiments et des questions-réponses complexes, marquant un passage de la transcription à une véritable compréhension audio. L’accès par API sera disponible ultérieurement via la plateforme ouverte iFLYTEK.
commentaires (0)
0/300