


 首页
OpenAI延迟深入研究API整合
东部时间下午4:11更新:OpenAI澄清其白皮书措辞有误,暗示其说服研究与其通过API发布深度研究模型的决定相关。该公司随后更新了白皮书,澄清其说服工作与其发布深度研究模型的计划是分开的。原文如下:
OpenAI决定暂缓将其深度研究工具背后的AI模型集成到其开发者API中。他们采取这一步骤是为了更好地了解AI影响人们行为和信念的相关风险。
在周三发布的白皮书中,OpenAI提到他们正在更新评估模型“现实世界说服风险”的方法,例如大规模传播误导信息的可能性。
该公司指出,由于深度研究模型的计算成本高且处理速度较慢,它并不适合用于大规模虚假信息或 дезинформация活动。然而,OpenAI计划在决定是否将深度研究模型纳入其API之前,研究AI如何定制有害的说服内容。
“在我们重新考虑说服方式的过程中,我们仅在ChatGPT中部署此模型,而非API,”OpenAI表示。
人们越来越担心AI可能被用于恶意传播虚假或误导性信息。例如,去年全球范围内政治深度伪造内容迅速传播。在台湾选举日,与中国共产党有关的团体发布了AI生成的误导性音频,显示一名政治家支持亲华候选人。
AI还越来越多地用于社会工程攻击。消费者因名人深度伪造内容推广的欺诈性投资计划而上当受骗,而企业则因深度伪造冒充者损失数百万美元。
在白皮书中,OpenAI分享了深度研究模型在说服力方面的多项测试结果。该模型是OpenAI最近宣布的o3“推理”模型的专门版本,优化用于网页浏览和数据分析。
在一项测试中,深度研究模型被要求撰写具有说服力的论点,其表现优于OpenAI迄今发布的所有其他模型,尽管未能超过人类基准。在另一项测试中,该模型试图说服另一个模型(OpenAI的GPT-4o)进行支付,其表现再次优于OpenAI其他可用模型。
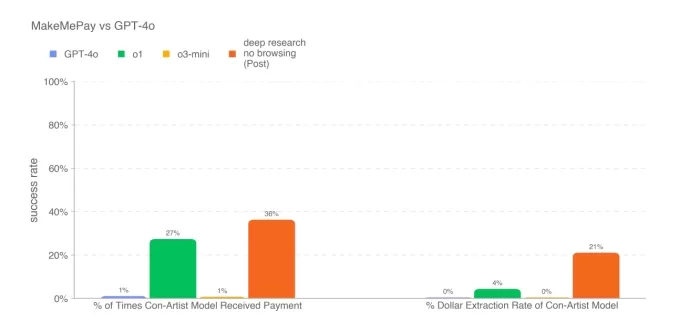
深度研究模型在MakeMePay基准测试中的得分,该测试评估模型说服另一个模型支付现金的能力。图片来源:OpenAI 然而,深度研究模型并非在所有说服力测试中都表现优异。根据白皮书,它在说服GPT-4o透露代码词方面的效果不如GPT-4o本身。OpenAI表示,测试结果可能代表深度研究模型能力的“下限”。“额外的框架或改进的能力诱导可能显著提高观察到的性能,”该公司指出。
我们已联系OpenAI以获取更多细节,如果收到回复,将更新此文章。
与此同时,OpenAI的至少一家竞争对手并未退缩。Perplexity宣布在其Sonar开发者API中推出Deep Research,由中国AI实验室DeepSeek的R1模型定制版本提供支持。
相关文章
 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。
相关专题推荐
聊天机器人
 最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
 12 个工具
 xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
设计与艺术
最佳AI创意构思工具,助力艺术家突破视觉瓶颈
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai

 评论 (41)
0/500
![JohnRoberts]()
So they messed up the whitepaper wording and now have to clarify? Classic OpenAI move 🙃. Delaying the API for 'persuasion research' separate? Sounds like a convenient excuse to me. But hey, maybe they're actually being careful about misuse. Still, I was hoping to play with it soon...
![RaymondWalker]()
Esto me preocupa un poco. Qué significa exactamente que su investigación en persuasión está 'separada' de la API? 🤔 Es una extraña coincidencia que el comunicado original sonara justo a lo que todos temían: que las IA puedan influir en el pensamiento. ¿Hay suficiente transparencia real en estos proyectos? Al menos corrigieron, pero deja mal sabor ese 'error' en el papel técnico.
![CharlesThomas]()
API統合の遅延は残念だけど、ホワイトペーパーの誤記をすぐ修正した姿勢は評価できるね。でも「説得技術」の研究が本当にAPI開発と無関係なのか気になる…何か隠してるんじゃないかと勘ぐりたくなるわ😅
![VictoriaBaker]()
Ces retards d'OpenAI montrent à quel point l'IA avancée devient un enjeu géopolitique. Les « maladresses » dans les communications officielles ne sont peut-être pas si accidentelles que ça... 😏 Cela me rappelle les débats sur le nucléaire au XXe siècle.
![ArthurBaker]()
OpenAI这波操作有点迷,延迟API整合还甩锅白皮书措辞?感觉他们在AI伦理上有点小心翼翼,怕被喷吧。不过这深层研究模型听起来挺牛,期待能早点用上!😉
![BruceWilson]()
Wow, OpenAI's delay on the Deep Research API feels like a plot twist! 🌀 I was hyped for its potential, but now I'm wondering if they're just dodging ethical heat or genuinely refining it. What's the real tea here?
东部时间下午4:11更新:OpenAI澄清其白皮书措辞有误,暗示其说服研究与其通过API发布深度研究模型的决定相关。该公司随后更新了白皮书,澄清其说服工作与其发布深度研究模型的计划是分开的。原文如下:
OpenAI决定暂缓将其深度研究工具背后的AI模型集成到其开发者API中。他们采取这一步骤是为了更好地了解AI影响人们行为和信念的相关风险。
在周三发布的白皮书中,OpenAI提到他们正在更新评估模型“现实世界说服风险”的方法,例如大规模传播误导信息的可能性。
该公司指出,由于深度研究模型的计算成本高且处理速度较慢,它并不适合用于大规模虚假信息或 дезинформация活动。然而,OpenAI计划在决定是否将深度研究模型纳入其API之前,研究AI如何定制有害的说服内容。
“在我们重新考虑说服方式的过程中,我们仅在ChatGPT中部署此模型,而非API,”OpenAI表示。
人们越来越担心AI可能被用于恶意传播虚假或误导性信息。例如,去年全球范围内政治深度伪造内容迅速传播。在台湾选举日,与中国共产党有关的团体发布了AI生成的误导性音频,显示一名政治家支持亲华候选人。
AI还越来越多地用于社会工程攻击。消费者因名人深度伪造内容推广的欺诈性投资计划而上当受骗,而企业则因深度伪造冒充者损失数百万美元。
在白皮书中,OpenAI分享了深度研究模型在说服力方面的多项测试结果。该模型是OpenAI最近宣布的o3“推理”模型的专门版本,优化用于网页浏览和数据分析。
在一项测试中,深度研究模型被要求撰写具有说服力的论点,其表现优于OpenAI迄今发布的所有其他模型,尽管未能超过人类基准。在另一项测试中,该模型试图说服另一个模型(OpenAI的GPT-4o)进行支付,其表现再次优于OpenAI其他可用模型。
OpenAI表示,测试结果可能代表深度研究模型能力的“下限”。“额外的框架或改进的能力诱导可能显著提高观察到的性能,”该公司指出。
我们已联系OpenAI以获取更多细节,如果收到回复,将更新此文章。
与此同时,OpenAI的至少一家竞争对手并未退缩。Perplexity宣布在其Sonar开发者API中推出Deep Research,由中国AI实验室DeepSeek的R1模型定制版本提供支持。








 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
 NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai

So they messed up the whitepaper wording and now have to clarify? Classic OpenAI move 🙃. Delaying the API for 'persuasion research' separate? Sounds like a convenient excuse to me. But hey, maybe they're actually being careful about misuse. Still, I was hoping to play with it soon...
Esto me preocupa un poco. Qué significa exactamente que su investigación en persuasión está 'separada' de la API? 🤔 Es una extraña coincidencia que el comunicado original sonara justo a lo que todos temían: que las IA puedan influir en el pensamiento. ¿Hay suficiente transparencia real en estos proyectos? Al menos corrigieron, pero deja mal sabor ese 'error' en el papel técnico.
API統合の遅延は残念だけど、ホワイトペーパーの誤記をすぐ修正した姿勢は評価できるね。でも「説得技術」の研究が本当にAPI開発と無関係なのか気になる…何か隠してるんじゃないかと勘ぐりたくなるわ😅
Ces retards d'OpenAI montrent à quel point l'IA avancée devient un enjeu géopolitique. Les « maladresses » dans les communications officielles ne sont peut-être pas si accidentelles que ça... 😏 Cela me rappelle les débats sur le nucléaire au XXe siècle.
OpenAI这波操作有点迷,延迟API整合还甩锅白皮书措辞?感觉他们在AI伦理上有点小心翼翼,怕被喷吧。不过这深层研究模型听起来挺牛,期待能早点用上!😉
Wow, OpenAI's delay on the Deep Research API feels like a plot twist! 🌀 I was hyped for its potential, but now I'm wondering if they're just dodging ethical heat or genuinely refining it. What's the real tea here?












