


 家
Openaiは、深い研究API統合を遅らせます
東部時間午後4時11分更新:OpenAIは、白書の表現が不適切だったと説明し、説得研究がディープリサーチモデルのAPIを通じた公開決定と関連していると示唆していた。同社は白書を更新し、説得研究とディープリサーチモデルの公開計画が別であることを明確にした。元の記事は以下に続く:
OpenAIは、ディープリサーチツールの背後にあるAIモデルを開発者向けAPIに統合するのを控えることを決定した。この措置は、AIが人々の行動や信念に影響を与える能力に関連するリスクをよりよく理解するために取られた。
水曜日に公開された白書で、OpenAIは「実世界の説得リスク」、例えば大規模に誤解を招く情報を拡散する可能性について、モデルの評価方法を現在更新中であると述べた。
同社は、ディープリサーチモデルは高い計算コストと処理速度の遅さから、大量の誤情報や偽情報キャンペーンには適していないと指摘した。しかし、OpenAIは、ディープリサーチモデルをAPIに含める前に、AIが有害な説得コンテンツをどのように調整するかを調査する計画だ。
「説得へのアプローチを見直す間、このモデルはChatGPTでのみ展開し、APIには展開しない」とOpenAIは述べた。
AIが有害な意図で誤った情報や誤解を招く情報を拡散するために使用される可能性に対する懸念が高まっている。例えば、昨年、世界中で政治的なディープフェイクが急速に広がった。台湾の選挙日には、中国共産党に関連するグループが、AI生成の誤解を招く音声を使用して、親中候補を支持する政治家を装った。
AIはソーシャルエンジニアリング攻撃にもますます使用されている。消費者は詐欺的な投資スキームを宣伝するセレブのディープフェイクに騙され、企業はディープフェイクのなりすましにより数百万ドルの損失を被っている。
白書の中で、OpenAIはディープリサーチモデルの説得力に関するいくつかのテスト結果を共有した。このモデルは、OpenAIが最近発表したo3「推論」モデルの特化版で、ウェブ閲覧とデータ分析に最適化されている。
あるテストでは、ディープリサーチモデルに説得力のある議論を作成するタスクが与えられ、これまで公開されたすべてのOpenAIモデルを上回ったが、人間の基準を超えることはなかった。別のテストでは、モデルが別のモデル(OpenAIのGPT-4o)に支払いをさせるよう説得しようとし、OpenAIの他の利用可能なモデルよりも優れた結果を示した。
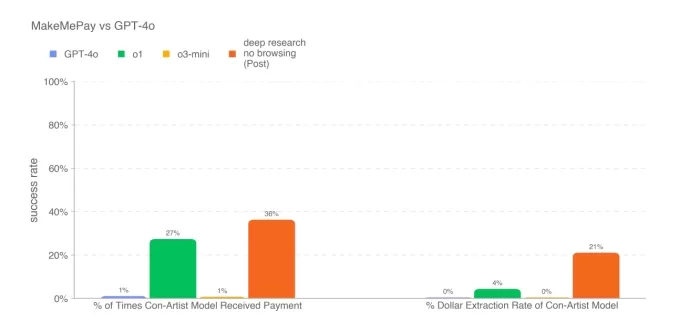
ディープリサーチモデルのMakeMePayでのスコア。これは、モデルが別のモデルに現金を説得する能力をテストするベンチマーク。画像提供:OpenAI しかし、ディープリサーチモデルはすべての説得テストで優れていたわけではない。白書によると、GPT-4oにコードワードを明かすよう説得するテストでは、GPT-4o自体に比べて効果が低かった。OpenAIは、テスト結果がディープリサーチモデルの能力の「下限」を表している可能性があると示唆した。「追加の足場や能力引き出しの改善により、観察されたパフォーマンスが大幅に向上する可能性がある」と同社は述べた。
OpenAIにさらなる詳細を問い合わせ、返答があればこの投稿を更新する。
一方、OpenAIの競合他社の少なくとも1社は躊躇していない。Perplexityは、中国のAIラボDeepSeekのR1モデルをカスタマイズしたバージョンで動作するDeep ResearchをSonar開発者APIで開始すると発表した。
関連記事
 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
Nvidia、来年の売上高の25%を資金提供を受けた研究所から得る見込み
Nvidiaは、同社のチップを購入するAI研究所に500億米ドル近くを投入し、総額5,000億米ドルを超える契約を確保した。8月26日、CFOのコレット・クレス氏はアナリストに対し、Nvidiaの財務基盤に支えられたこれらの研究所が、来年の同社事業の約4分の1を占める見込みであると伝えた。この仕組みは、しばしば「循環型資金調達」と呼ばれるが、アナリストがこの用語を考案する以前からNvidiaはこれ
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (42)
0/500
![GregoryJones]()
OpenAIのDeep Research API統合延期、白紙の誤解が原因か?🤔 技術の進歩は速いが、説明不足は信頼を損なう。ユーザーとしては透明性の高い対応を期待したい。#AI #OpenAI
![JohnRoberts]()
So they messed up the whitepaper wording and now have to clarify? Classic OpenAI move 🙃. Delaying the API for 'persuasion research' separate? Sounds like a convenient excuse to me. But hey, maybe they're actually being careful about misuse. Still, I was hoping to play with it soon...
![RaymondWalker]()
Esto me preocupa un poco. Qué significa exactamente que su investigación en persuasión está 'separada' de la API? 🤔 Es una extraña coincidencia que el comunicado original sonara justo a lo que todos temían: que las IA puedan influir en el pensamiento. ¿Hay suficiente transparencia real en estos proyectos? Al menos corrigieron, pero deja mal sabor ese 'error' en el papel técnico.
![CharlesThomas]()
API統合の遅延は残念だけど、ホワイトペーパーの誤記をすぐ修正した姿勢は評価できるね。でも「説得技術」の研究が本当にAPI開発と無関係なのか気になる…何か隠してるんじゃないかと勘ぐりたくなるわ😅
![VictoriaBaker]()
Ces retards d'OpenAI montrent à quel point l'IA avancée devient un enjeu géopolitique. Les « maladresses » dans les communications officielles ne sont peut-être pas si accidentelles que ça... 😏 Cela me rappelle les débats sur le nucléaire au XXe siècle.
![ArthurBaker]()
OpenAI这波操作有点迷,延迟API整合还甩锅白皮书措辞?感觉他们在AI伦理上有点小心翼翼,怕被喷吧。不过这深层研究模型听起来挺牛,期待能早点用上!😉
東部時間午後4時11分更新:OpenAIは、白書の表現が不適切だったと説明し、説得研究がディープリサーチモデルのAPIを通じた公開決定と関連していると示唆していた。同社は白書を更新し、説得研究とディープリサーチモデルの公開計画が別であることを明確にした。元の記事は以下に続く:
OpenAIは、ディープリサーチツールの背後にあるAIモデルを開発者向けAPIに統合するのを控えることを決定した。この措置は、AIが人々の行動や信念に影響を与える能力に関連するリスクをよりよく理解するために取られた。
水曜日に公開された白書で、OpenAIは「実世界の説得リスク」、例えば大規模に誤解を招く情報を拡散する可能性について、モデルの評価方法を現在更新中であると述べた。
同社は、ディープリサーチモデルは高い計算コストと処理速度の遅さから、大量の誤情報や偽情報キャンペーンには適していないと指摘した。しかし、OpenAIは、ディープリサーチモデルをAPIに含める前に、AIが有害な説得コンテンツをどのように調整するかを調査する計画だ。
「説得へのアプローチを見直す間、このモデルはChatGPTでのみ展開し、APIには展開しない」とOpenAIは述べた。
AIが有害な意図で誤った情報や誤解を招く情報を拡散するために使用される可能性に対する懸念が高まっている。例えば、昨年、世界中で政治的なディープフェイクが急速に広がった。台湾の選挙日には、中国共産党に関連するグループが、AI生成の誤解を招く音声を使用して、親中候補を支持する政治家を装った。
AIはソーシャルエンジニアリング攻撃にもますます使用されている。消費者は詐欺的な投資スキームを宣伝するセレブのディープフェイクに騙され、企業はディープフェイクのなりすましにより数百万ドルの損失を被っている。
白書の中で、OpenAIはディープリサーチモデルの説得力に関するいくつかのテスト結果を共有した。このモデルは、OpenAIが最近発表したo3「推論」モデルの特化版で、ウェブ閲覧とデータ分析に最適化されている。
あるテストでは、ディープリサーチモデルに説得力のある議論を作成するタスクが与えられ、これまで公開されたすべてのOpenAIモデルを上回ったが、人間の基準を超えることはなかった。別のテストでは、モデルが別のモデル(OpenAIのGPT-4o)に支払いをさせるよう説得しようとし、OpenAIの他の利用可能なモデルよりも優れた結果を示した。
OpenAIは、テスト結果がディープリサーチモデルの能力の「下限」を表している可能性があると示唆した。「追加の足場や能力引き出しの改善により、観察されたパフォーマンスが大幅に向上する可能性がある」と同社は述べた。
OpenAIにさらなる詳細を問い合わせ、返答があればこの投稿を更新する。
一方、OpenAIの競合他社の少なくとも1社は躊躇していない。Perplexityは、中国のAIラボDeepSeekのR1モデルをカスタマイズしたバージョンで動作するDeep ResearchをSonar開発者APIで開始すると発表した。








 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
 OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
 Nvidia、来年の売上高の25%を資金提供を受けた研究所から得る見込み
Nvidiaは、同社のチップを購入するAI研究所に500億米ドル近くを投入し、総額5,000億米ドルを超える契約を確保した。8月26日、CFOのコレット・クレス氏はアナリストに対し、Nvidiaの財務基盤に支えられたこれらの研究所が、来年の同社事業の約4分の1を占める見込みであると伝えた。この仕組みは、しばしば「循環型資金調達」と呼ばれるが、アナリストがこの用語を考案する以前からNvidiaはこれ

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

OpenAIのDeep Research API統合延期、白紙の誤解が原因か?🤔 技術の進歩は速いが、説明不足は信頼を損なう。ユーザーとしては透明性の高い対応を期待したい。#AI #OpenAI
So they messed up the whitepaper wording and now have to clarify? Classic OpenAI move 🙃. Delaying the API for 'persuasion research' separate? Sounds like a convenient excuse to me. But hey, maybe they're actually being careful about misuse. Still, I was hoping to play with it soon...
Esto me preocupa un poco. Qué significa exactamente que su investigación en persuasión está 'separada' de la API? 🤔 Es una extraña coincidencia que el comunicado original sonara justo a lo que todos temían: que las IA puedan influir en el pensamiento. ¿Hay suficiente transparencia real en estos proyectos? Al menos corrigieron, pero deja mal sabor ese 'error' en el papel técnico.
API統合の遅延は残念だけど、ホワイトペーパーの誤記をすぐ修正した姿勢は評価できるね。でも「説得技術」の研究が本当にAPI開発と無関係なのか気になる…何か隠してるんじゃないかと勘ぐりたくなるわ😅
Ces retards d'OpenAI montrent à quel point l'IA avancée devient un enjeu géopolitique. Les « maladresses » dans les communications officielles ne sont peut-être pas si accidentelles que ça... 😏 Cela me rappelle les débats sur le nucléaire au XXe siècle.
OpenAI这波操作有点迷,延迟API整合还甩锅白皮书措辞?感觉他们在AI伦理上有点小心翼翼,怕被喷吧。不过这深层研究模型听起来挺牛,期待能早点用上!😉












