


 首頁
OpenAI延遲深入研究API整合
更新於東部時間下午4:11:OpenAI澄清其白皮書措辭有誤,暗示其說服研究與通過其API發布深度研究模型的決定有關。該公司已更新白皮書,明確其說服研究與發布深度研究模型的計劃無關。原文故事繼續如下:
OpenAI決定暫緩將其深度研究工具背後的AI模型整合到其開發者API中。他們採取這一步驟,以更好地理解AI影響人們行動和信念能力的相關風險。
在週三發布的白皮書中,OpenAI提到他們正在更新評估模型「現實世界說服風險」的方法,例如大規模傳播誤導資訊的潛在風險。
該公司指出,由於深度研究模型的運算成本高且處理速度較慢,不太適合用於大規模誤導或虛假資訊活動。然而,OpenAI計劃在決定是否將深度研究模型納入其API之前,調查AI如何可能量身定制有害的說服內容。
「在我們重新考慮說服方式的同時,我們僅在ChatGPT中部署此模型,而非API,」OpenAI表示。
越來越多人擔心AI可能被用於惡意傳播虛假或誤導資訊。例如,去年全球政治深偽內容迅速傳播。在台灣選舉日當天,一個與中國共產黨有關的團體發布了AI生成的誤導性音頻,顯示一名政治人物支持親中候選人。
AI也日益被用於社交工程攻擊。消費者因名人深偽推廣的詐騙投資計劃而上當,而企業則因深偽冒充者損失數百萬美元。
在白皮書中,OpenAI分享了深度研究模型說服力的多項測試結果。此模型是OpenAI最近宣布的o3「推理」模型的專業版本,針對網頁瀏覽和數據分析進行了優化。
在一項測試中,深度研究模型被要求撰寫說服性論點,表現超越了OpenAI迄今發布的所有其他模型,但未超過人類基準。在另一項測試中,該模型試圖說服另一模型(OpenAI的GPT-4o)進行支付,再次表現優於OpenAI其他可用模型。
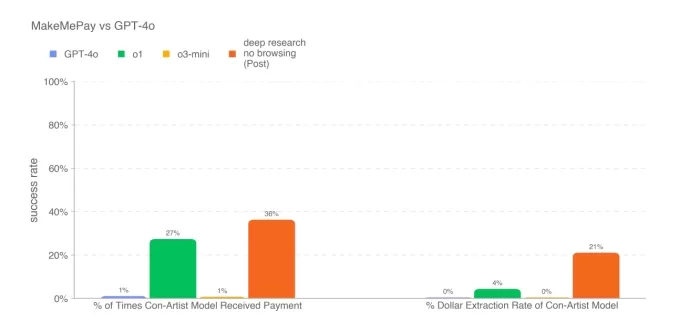
深度研究模型在MakeMePay基準測試中的得分,該基準測試模型說服另一模型支付現金的能力。圖片來源:OpenAI 然而,深度研究模型並非在所有說服力測試中都表現出色。根據白皮書,它在說服GPT-4o透露代碼詞方面的效果不如GPT-4o本身。OpenAI表示,測試結果可能代表深度研究模型能力的「下限」。該公司指出:「額外的結構支持或改進的能力引導可能大幅提升觀察到的表現。」
我們已聯繫OpenAI以獲取更多詳情,若收到回應,將更新此文章。
與此同時,OpenAI的至少一名競爭對手並未退縮。Perplexity宣布在其Sonar開發者API中推出Deep Research,由中國AI實驗室DeepSeek的R1模型定制版本提供支持。
相關文章
 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
NEA的蒂芙尼·拉克:企業仍在努力應對人工智慧的投資回報率
正在載入播放器…今年早些時候,“token最大化”(tokenmaxxing)在矽谷佔據主導地位,執行長們敦促員工最大限度地利用人工智慧。然而,這種熱情很快遭遇了現實。據報道,Uber在幾個月內就超出了其年度人工智慧預算,一些公司跨部門削減了Claude許可證,而Meta則取消了內部績效排名。NEA合夥人蒂芙尼·拉克(Tiffany Luck)每天都在應對這種興奮與實際回報之間的差距。她此前曾成功說服企業電子商務是未來,如今她完全專注於人工智慧,特別是其為消費者創造“神奇時刻”的潛力。
相關專題推薦
數據分析
 用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
 9 個工具
 xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

 評論 (41)
0/500
![JohnRoberts]()
So they messed up the whitepaper wording and now have to clarify? Classic OpenAI move 🙃. Delaying the API for 'persuasion research' separate? Sounds like a convenient excuse to me. But hey, maybe they're actually being careful about misuse. Still, I was hoping to play with it soon...
![RaymondWalker]()
Esto me preocupa un poco. Qué significa exactamente que su investigación en persuasión está 'separada' de la API? 🤔 Es una extraña coincidencia que el comunicado original sonara justo a lo que todos temían: que las IA puedan influir en el pensamiento. ¿Hay suficiente transparencia real en estos proyectos? Al menos corrigieron, pero deja mal sabor ese 'error' en el papel técnico.
![CharlesThomas]()
API統合の遅延は残念だけど、ホワイトペーパーの誤記をすぐ修正した姿勢は評価できるね。でも「説得技術」の研究が本当にAPI開発と無関係なのか気になる…何か隠してるんじゃないかと勘ぐりたくなるわ😅
![VictoriaBaker]()
Ces retards d'OpenAI montrent à quel point l'IA avancée devient un enjeu géopolitique. Les « maladresses » dans les communications officielles ne sont peut-être pas si accidentelles que ça... 😏 Cela me rappelle les débats sur le nucléaire au XXe siècle.
![ArthurBaker]()
OpenAI这波操作有点迷,延迟API整合还甩锅白皮书措辞?感觉他们在AI伦理上有点小心翼翼,怕被喷吧。不过这深层研究模型听起来挺牛,期待能早点用上!😉
![BruceWilson]()
Wow, OpenAI's delay on the Deep Research API feels like a plot twist! 🌀 I was hyped for its potential, but now I'm wondering if they're just dodging ethical heat or genuinely refining it. What's the real tea here?
更新於東部時間下午4:11:OpenAI澄清其白皮書措辭有誤,暗示其說服研究與通過其API發布深度研究模型的決定有關。該公司已更新白皮書,明確其說服研究與發布深度研究模型的計劃無關。原文故事繼續如下:
OpenAI決定暫緩將其深度研究工具背後的AI模型整合到其開發者API中。他們採取這一步驟,以更好地理解AI影響人們行動和信念能力的相關風險。
在週三發布的白皮書中,OpenAI提到他們正在更新評估模型「現實世界說服風險」的方法,例如大規模傳播誤導資訊的潛在風險。
該公司指出,由於深度研究模型的運算成本高且處理速度較慢,不太適合用於大規模誤導或虛假資訊活動。然而,OpenAI計劃在決定是否將深度研究模型納入其API之前,調查AI如何可能量身定制有害的說服內容。
「在我們重新考慮說服方式的同時,我們僅在ChatGPT中部署此模型,而非API,」OpenAI表示。
越來越多人擔心AI可能被用於惡意傳播虛假或誤導資訊。例如,去年全球政治深偽內容迅速傳播。在台灣選舉日當天,一個與中國共產黨有關的團體發布了AI生成的誤導性音頻,顯示一名政治人物支持親中候選人。
AI也日益被用於社交工程攻擊。消費者因名人深偽推廣的詐騙投資計劃而上當,而企業則因深偽冒充者損失數百萬美元。
在白皮書中,OpenAI分享了深度研究模型說服力的多項測試結果。此模型是OpenAI最近宣布的o3「推理」模型的專業版本,針對網頁瀏覽和數據分析進行了優化。
在一項測試中,深度研究模型被要求撰寫說服性論點,表現超越了OpenAI迄今發布的所有其他模型,但未超過人類基準。在另一項測試中,該模型試圖說服另一模型(OpenAI的GPT-4o)進行支付,再次表現優於OpenAI其他可用模型。
OpenAI表示,測試結果可能代表深度研究模型能力的「下限」。該公司指出:「額外的結構支持或改進的能力引導可能大幅提升觀察到的表現。」
我們已聯繫OpenAI以獲取更多詳情,若收到回應,將更新此文章。
與此同時,OpenAI的至少一名競爭對手並未退縮。Perplexity宣布在其Sonar開發者API中推出Deep Research,由中國AI實驗室DeepSeek的R1模型定制版本提供支持。








 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
 Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
 NEA的蒂芙尼·拉克:企業仍在努力應對人工智慧的投資回報率
正在載入播放器…今年早些時候,“token最大化”(tokenmaxxing)在矽谷佔據主導地位,執行長們敦促員工最大限度地利用人工智慧。然而,這種熱情很快遭遇了現實。據報道,Uber在幾個月內就超出了其年度人工智慧預算,一些公司跨部門削減了Claude許可證,而Meta則取消了內部績效排名。NEA合夥人蒂芙尼·拉克(Tiffany Luck)每天都在應對這種興奮與實際回報之間的差距。她此前曾成功說服企業電子商務是未來,如今她完全專注於人工智慧,特別是其為消費者創造“神奇時刻”的潛力。

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

So they messed up the whitepaper wording and now have to clarify? Classic OpenAI move 🙃. Delaying the API for 'persuasion research' separate? Sounds like a convenient excuse to me. But hey, maybe they're actually being careful about misuse. Still, I was hoping to play with it soon...
Esto me preocupa un poco. Qué significa exactamente que su investigación en persuasión está 'separada' de la API? 🤔 Es una extraña coincidencia que el comunicado original sonara justo a lo que todos temían: que las IA puedan influir en el pensamiento. ¿Hay suficiente transparencia real en estos proyectos? Al menos corrigieron, pero deja mal sabor ese 'error' en el papel técnico.
API統合の遅延は残念だけど、ホワイトペーパーの誤記をすぐ修正した姿勢は評価できるね。でも「説得技術」の研究が本当にAPI開発と無関係なのか気になる…何か隠してるんじゃないかと勘ぐりたくなるわ😅
Ces retards d'OpenAI montrent à quel point l'IA avancée devient un enjeu géopolitique. Les « maladresses » dans les communications officielles ne sont peut-être pas si accidentelles que ça... 😏 Cela me rappelle les débats sur le nucléaire au XXe siècle.
OpenAI这波操作有点迷,延迟API整合还甩锅白皮书措辞?感觉他们在AI伦理上有点小心翼翼,怕被喷吧。不过这深层研究模型听起来挺牛,期待能早点用上!😉
Wow, OpenAI's delay on the Deep Research API feels like a plot twist! 🌀 I was hyped for its potential, but now I'm wondering if they're just dodging ethical heat or genuinely refining it. What's the real tea here?












