


 首页
使用 Python AI 从单张图像创建 3D 模型,只需简单几步
将二维图像转化为三维模型的能力释放了多个行业的巨大潜力。本指南将探讨 Python 强大的人工智能和三维处理能力如何从单张图像中创建精细的三维网格。了解使之成为可能的尖端技术和实用工作流程。
主要亮点
人工智能驱动的转换:使用深度学习技术将平面图像转换为完全真实的三维模型。
Python 生态系统:利用专业库无缝生成三维模型。
端到端工作流程:遵循从图像到网格的成熟的六阶段流程。
灵活的图像源:使用现有照片或使用 AI 生成器创建自定义图像。
高级集成:与 Stable Diffusion 相结合,创造无限可能。
跨行业应用:将这些技术应用于游戏、建筑、产品设计等领域。
使用 Python AI 创建 3D 资产
从二维图像生成三维网格简介
深度学习和 3D 处理的融合给数字内容创作带来了革命性的变化。现在,现代技术可以将普通照片转换成完全纹理化的三维资产,为多个行业带来了新的创意可能性。这一突破实现了三维建模的平民化,使专业级的资产创建无需专业设备即可实现。
通过了解底层技术,我们可以发现实现这一转变的三个关键要素:
- 深度估计神经网络分析视觉线索,确定二维图像中的空间关系
- 点云处理将深度数据转换为空间坐标,形成模型框架
- 网格重建算法智能地将这些点连接成连续的曲面
Python 是实现这一工作流程的理想平台,它提供以下功能
- 强大的深度学习框架,如用于训练神经网络的 PyTorch
- 通过 NumPy 和 SciPy 进行高级数值计算
- 通过 Open3D 进行专业的三维处理,实现最终模型输出
三维生成的核心工作流程
图像到 3D 的转换过程遵循结构化的六步方法:
- 环境配置:使用所需的 AI 和 3D 处理库设置 Python 开发生态系统
- 源图像采集:使用摄像头或人工智能文本到图像系统采集或生成高质量的 2D 输入图像
- 图像优化:增强和准备源图像,以获得最高深度估计精度
- 深度计算:利用训练有素的神经网络从二维输入中获取空间信息
- 空间映射:将深度数据转换为三维点云表示法
- 最终网格构建:在点之间生成纹理表面,以完成模型
基本 Python 库
五个关键库构成了基于 Python 的 3D 网格生成的基础:
库 主要功能 主要功能 PyTorch 神经网络框架 GPU 加速训练、动态计算图 火炬视觉 计算机视觉支持 预训练模型、图像变换 NumPy 数值计算 高效数组运算、线性代数 Open3D 三维处理 点云处理、网格重建 SciPy 科学计算 高级算法、优化功能
详细流程分解
环境设置
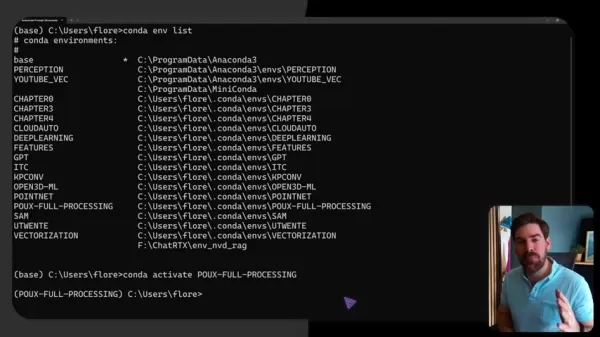
通过基于 Conda 的环境管理,适当的配置可确保无缝运行:
conda create -n 3dgen python=3.9 conda activate 3dgen pip install torch torchvision open3d numpy scipy
图像处理管道
优化源图像涉及多个增强阶段:
- 根据神经网络输入要求进行分辨率标准化
- 光照标准化,以实现一致的深度估计
- 增强对比度,突出结构细节
- 降低噪声,实现干净的几何重建
- 特征锐化,改善边缘检测
深度估计技术
现代神经网络可分析各种视觉深度线索:
- 相对物体大小比较
- 纹理梯度分析
- 遮挡关系
- 大气透视分析
- 阴影和照明模式
点云生成
创建空间坐标涉及复杂的投影:
- 摄像机固有参数校准
- 二维到三维坐标系转换
- 点密度优化
- 离群点过滤
- 空间降噪
网格构建技术
最终模型生成采用先进的曲面重建技术:
- 用于平滑网格的泊松曲面重构
- 高效拓扑创建的球透视
- 用于体积渲染的行进立方体
- 简化网格以优化性能
- 用于纹理贴图的 UV 展开
人工智能与高级集成
稳定的扩散实现
集成生成式人工智能,拓展创意可能性:
- 针对所需图像特征的文本提示工程
- 根据艺术风格要求选择模型
- 参数优化,实现高质量输出
- 用于迭代改进的批量处理
- 输出与 3D 管道规格保持一致
神经网络架构
关键的人工智能模型选择会影响重建质量:
- 基于 CNN 的单目深度估算器
- 全局上下文的变换器架构
- 结合多种方法的混合模型
- 保留细节的注意机制
- 用于综合分析的多尺度处理
实用实施指南
系统要求
优化硬件配置,确保流畅运行:
组件 最低配置 建议配置 图形处理器 4GB 内存 8GB+ VRAM(NVIDIA RTX) 内存 16GB 32GB+ 存储空间 256GB SSD 1TB NVMe 操作系统 Windows/Linux 用于生产的 Linux
行业应用
跨行业的变革性用例:
- 游戏快速创建环境和角色资产
- 建筑根据现场照片进行现有条件建模
- 产品设计:根据草图进行概念可视化
- 电子商务:根据标准产品图片创建 3D 产品视图
- 文化遗产:通过数字孪生保存文物
常见问题
高效处理需要哪些硬件?
配备至少 8GB VRAM 的专用英伟达™(NVIDIA®)图形处理器可大大加快计算速度,不过一些基本操作也可在配备足够内存的 CPU 上运行。
如何从具有挑战性的图像中提高网格质量?
多图像融合、手动深度提示和后处理完善技术可以提高低对比度或无纹理源图像的效果。
除了开源工具,还有其他商业工具吗?
有几个 SaaS 平台提供基于网络的三维生成服务,但定制化程度不如基于 Python 的解决方案,而且需要持续支付订阅费用。
输出的 3D 模型支持哪些文件格式?
管道通常输出行业标准格式,包括 OBJ、STL、PLY 和 glTF,以实现最大的软件兼容性。
相关文章
 苹果智能眼镜或将在WWDC27上首次亮相,重点突出隐私保护
彭博社的马克·古尔曼报道,苹果智能眼镜(内部代号 N50)计划于 2027 年 6 月的全球开发者大会(WWDC27)上首次亮相,零售版预计将于 2027 年秋季上市。该设备原定于今年晚些时候及 2027 年初发布,但现已推迟,以便进行进一步的产品完善并加强隐私保护协议。隐私仍是苹果智能眼镜战略的核心支柱。从 Meta 等竞争对手的隐私争议中吸取教训,苹果正在实施强有力的功能与政策。目前考虑的方案包括:完全移除摄像头,专注于人工智能交互、音频播放和通话;或保留摄像头但禁用照片和视频录制功能,仅
内部细节曝光:下一代 Gemini 算力紧张,内部团队在开发优先级和资源分配上存在分歧
报告显示,谷歌备受期待的下一代 Gemini 模型发布已被推迟。由于内部在开发优先级和资源分配上存在分歧,加上计算能力有限以及复杂的审批流程,导致发布时间延后了两个月。尽管谷歌拥有定制的 TPU 芯片,但由于模型训练、Google Cloud 服务以及众多消费和企业级 AI 应用对计算资源的需求相互竞争,谷歌仍面临计算资源短缺的问题。目前,高层管理人员正通过组织结构调整来解决这些部门间的冲突。与此同时,领导层也发生了变化,联合创始人谢尔盖·布林越来越多地参与到核心模型训练中,并倡导将资源专门用于
OpenAI 否认增长放缓担忧,称多个业务部门加速发展
针对外界对其销售增长放缓及未达内部基准的质疑,人工智能领域的领军企业 OpenAI 于 4 月 28 日(星期二)发表了一份信心十足的声明。该公司澄清称,其消费产品和企业服务正在快速推进,直接驳斥了近期关于业务放缓的猜测。针对该公司“未达成多项内部目标”的说法,OpenAI 将这些报道斥为“典型的标题党”。公司强调了企业对 AI 集成的强劲需求,并指出其广告业务早期增长前景良好。据 OpenAI 内部人士透露,公司内部情绪依然乐观。尽管市场竞争日益激烈,但公司正在向投资者传递信心,声称其商业
相关专题推荐
音乐创作
 最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
 8 个工具
 xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

 评论 (3)
0/500
![StevenGonzalez]()
Okay, let me try this with my old vacation photos first... the idea of turning a flat picture into something I can rotate and view from all angles is kind of wild. Hope the libraries mentioned are beginner-friendly! 🤞
![CharlesGonzalez]()
That's cool but isn't this getting too easy? Wonder how this will impact the jobs for 3D artists and game modelers. Hope they also talk about the limits of what a single image can do.
![JasonMartinez]()
竟然能從一張照片生成3D模型?這技術要是普及,建模師要失業了吧😅 不過想到可以用在文物保存上感覺蠻有意思的,改天來試試看能不能把我家貓主子做成3D模型
将二维图像转化为三维模型的能力释放了多个行业的巨大潜力。本指南将探讨 Python 强大的人工智能和三维处理能力如何从单张图像中创建精细的三维网格。了解使之成为可能的尖端技术和实用工作流程。
主要亮点
人工智能驱动的转换:使用深度学习技术将平面图像转换为完全真实的三维模型。
Python 生态系统:利用专业库无缝生成三维模型。
端到端工作流程:遵循从图像到网格的成熟的六阶段流程。
灵活的图像源:使用现有照片或使用 AI 生成器创建自定义图像。
高级集成:与 Stable Diffusion 相结合,创造无限可能。
跨行业应用:将这些技术应用于游戏、建筑、产品设计等领域。
使用 Python AI 创建 3D 资产
从二维图像生成三维网格简介
深度学习和 3D 处理的融合给数字内容创作带来了革命性的变化。现在,现代技术可以将普通照片转换成完全纹理化的三维资产,为多个行业带来了新的创意可能性。这一突破实现了三维建模的平民化,使专业级的资产创建无需专业设备即可实现。
通过了解底层技术,我们可以发现实现这一转变的三个关键要素:
- 深度估计神经网络分析视觉线索,确定二维图像中的空间关系
- 点云处理将深度数据转换为空间坐标,形成模型框架
- 网格重建算法智能地将这些点连接成连续的曲面
Python 是实现这一工作流程的理想平台,它提供以下功能
- 强大的深度学习框架,如用于训练神经网络的 PyTorch
- 通过 NumPy 和 SciPy 进行高级数值计算
- 通过 Open3D 进行专业的三维处理,实现最终模型输出
三维生成的核心工作流程
图像到 3D 的转换过程遵循结构化的六步方法:
- 环境配置:使用所需的 AI 和 3D 处理库设置 Python 开发生态系统
- 源图像采集:使用摄像头或人工智能文本到图像系统采集或生成高质量的 2D 输入图像
- 图像优化:增强和准备源图像,以获得最高深度估计精度
- 深度计算:利用训练有素的神经网络从二维输入中获取空间信息
- 空间映射:将深度数据转换为三维点云表示法
- 最终网格构建:在点之间生成纹理表面,以完成模型
基本 Python 库
五个关键库构成了基于 Python 的 3D 网格生成的基础:
| 库 | 主要功能 | 主要功能 |
|---|---|---|
| PyTorch | 神经网络框架 | GPU 加速训练、动态计算图 |
| 火炬视觉 | 计算机视觉支持 | 预训练模型、图像变换 |
| NumPy | 数值计算 | 高效数组运算、线性代数 |
| Open3D | 三维处理 | 点云处理、网格重建 |
| SciPy | 科学计算 | 高级算法、优化功能 |
详细流程分解
环境设置
通过基于 Conda 的环境管理,适当的配置可确保无缝运行:
conda create -n 3dgen python=3.9 conda activate 3dgen pip install torch torchvision open3d numpy scipy
图像处理管道
优化源图像涉及多个增强阶段:
- 根据神经网络输入要求进行分辨率标准化
- 光照标准化,以实现一致的深度估计
- 增强对比度,突出结构细节
- 降低噪声,实现干净的几何重建
- 特征锐化,改善边缘检测
深度估计技术
现代神经网络可分析各种视觉深度线索:
- 相对物体大小比较
- 纹理梯度分析
- 遮挡关系
- 大气透视分析
- 阴影和照明模式
点云生成
创建空间坐标涉及复杂的投影:
- 摄像机固有参数校准
- 二维到三维坐标系转换
- 点密度优化
- 离群点过滤
- 空间降噪
网格构建技术
最终模型生成采用先进的曲面重建技术:
- 用于平滑网格的泊松曲面重构
- 高效拓扑创建的球透视
- 用于体积渲染的行进立方体
- 简化网格以优化性能
- 用于纹理贴图的 UV 展开
人工智能与高级集成
稳定的扩散实现
集成生成式人工智能,拓展创意可能性:
- 针对所需图像特征的文本提示工程
- 根据艺术风格要求选择模型
- 参数优化,实现高质量输出
- 用于迭代改进的批量处理
- 输出与 3D 管道规格保持一致
神经网络架构
关键的人工智能模型选择会影响重建质量:
- 基于 CNN 的单目深度估算器
- 全局上下文的变换器架构
- 结合多种方法的混合模型
- 保留细节的注意机制
- 用于综合分析的多尺度处理
实用实施指南
系统要求
优化硬件配置,确保流畅运行:
| 组件 | 最低配置 | 建议配置 |
|---|---|---|
| 图形处理器 | 4GB 内存 | 8GB+ VRAM(NVIDIA RTX) |
| 内存 | 16GB | 32GB+ |
| 存储空间 | 256GB SSD | 1TB NVMe |
| 操作系统 | Windows/Linux | 用于生产的 Linux |
行业应用
跨行业的变革性用例:
- 游戏快速创建环境和角色资产
- 建筑根据现场照片进行现有条件建模
- 产品设计:根据草图进行概念可视化
- 电子商务:根据标准产品图片创建 3D 产品视图
- 文化遗产:通过数字孪生保存文物
常见问题
高效处理需要哪些硬件?
配备至少 8GB VRAM 的专用英伟达™(NVIDIA®)图形处理器可大大加快计算速度,不过一些基本操作也可在配备足够内存的 CPU 上运行。
如何从具有挑战性的图像中提高网格质量?
多图像融合、手动深度提示和后处理完善技术可以提高低对比度或无纹理源图像的效果。
除了开源工具,还有其他商业工具吗?
有几个 SaaS 平台提供基于网络的三维生成服务,但定制化程度不如基于 Python 的解决方案,而且需要持续支付订阅费用。
输出的 3D 模型支持哪些文件格式?
管道通常输出行业标准格式,包括 OBJ、STL、PLY 和 glTF,以实现最大的软件兼容性。








 苹果智能眼镜或将在WWDC27上首次亮相,重点突出隐私保护
彭博社的马克·古尔曼报道,苹果智能眼镜(内部代号 N50)计划于 2027 年 6 月的全球开发者大会(WWDC27)上首次亮相,零售版预计将于 2027 年秋季上市。该设备原定于今年晚些时候及 2027 年初发布,但现已推迟,以便进行进一步的产品完善并加强隐私保护协议。隐私仍是苹果智能眼镜战略的核心支柱。从 Meta 等竞争对手的隐私争议中吸取教训,苹果正在实施强有力的功能与政策。目前考虑的方案包括:完全移除摄像头,专注于人工智能交互、音频播放和通话;或保留摄像头但禁用照片和视频录制功能,仅
 内部细节曝光:下一代 Gemini 算力紧张,内部团队在开发优先级和资源分配上存在分歧
报告显示,谷歌备受期待的下一代 Gemini 模型发布已被推迟。由于内部在开发优先级和资源分配上存在分歧,加上计算能力有限以及复杂的审批流程,导致发布时间延后了两个月。尽管谷歌拥有定制的 TPU 芯片,但由于模型训练、Google Cloud 服务以及众多消费和企业级 AI 应用对计算资源的需求相互竞争,谷歌仍面临计算资源短缺的问题。目前,高层管理人员正通过组织结构调整来解决这些部门间的冲突。与此同时,领导层也发生了变化,联合创始人谢尔盖·布林越来越多地参与到核心模型训练中,并倡导将资源专门用于
 OpenAI 否认增长放缓担忧,称多个业务部门加速发展
针对外界对其销售增长放缓及未达内部基准的质疑,人工智能领域的领军企业 OpenAI 于 4 月 28 日(星期二)发表了一份信心十足的声明。该公司澄清称,其消费产品和企业服务正在快速推进,直接驳斥了近期关于业务放缓的猜测。针对该公司“未达成多项内部目标”的说法,OpenAI 将这些报道斥为“典型的标题党”。公司强调了企业对 AI 集成的强劲需求,并指出其广告业务早期增长前景良好。据 OpenAI 内部人士透露,公司内部情绪依然乐观。尽管市场竞争日益激烈,但公司正在向投资者传递信心,声称其商业

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

Okay, let me try this with my old vacation photos first... the idea of turning a flat picture into something I can rotate and view from all angles is kind of wild. Hope the libraries mentioned are beginner-friendly! 🤞
That's cool but isn't this getting too easy? Wonder how this will impact the jobs for 3D artists and game modelers. Hope they also talk about the limits of what a single image can do.
竟然能從一張照片生成3D模型?這技術要是普及,建模師要失業了吧😅 不過想到可以用在文物保存上感覺蠻有意思的,改天來試試看能不能把我家貓主子做成3D模型












