


 首页
DeepMind首席执行官Demis Hassabis宣布了Google的双子座和VEO AI模型的未来整合
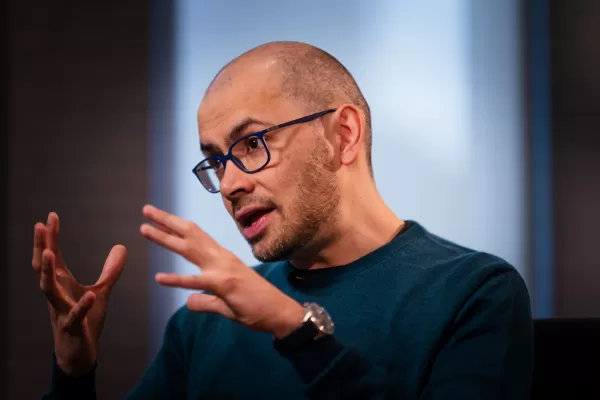
在最近一期由LinkedIn联合创始人Reid Hoffman共同主持的播客Possible中,Google DeepMind首席执行官Demis Hassabis分享了关于Google计划的一些激动人心的消息。他透露,Google计划将其Gemini AI模型与Veo视频生成模型合并。这种融合旨在增强Gemini对物理世界的理解,使其更擅长理解现实生活的动态。
Hassabis强调,Gemini从一开始就被设计为多模态。“我们一直以来都将Gemini,我们的基础模型,构建为多模态,”他解释道。这种方法的动机是什么?为一个真正能在日常生活中提供帮助的通用数字助手设定愿景。“一个……在现实世界中真正帮助你的助手,”Hassabis进一步阐述。
AI行业正稳步向所谓的“全能”模型发展——那些能够处理和合成各种类型媒体的模型。例如,Google的最新Gemini版本不仅能生成文本,还能生成音频和图像。与此同时,OpenAI的ChatGPT默认模型可以即时生成图像,包括令人愉悦的吉卜力工作室风格艺术。Amazon也不甘落后,计划在今年晚些时候推出“任意到任意”模型。
这些全能模型需要大量训练数据——包括图像、视频、音频和文本。Hassabis暗示,Veo的视频数据主要来自YouTube,这是Google拥有的一个宝库。“基本上,通过观看YouTube视频——大量的YouTube视频——[Veo 2]可以弄清楚,你知道的,世界的物理规律,”他指出。
Google此前曾对TechCrunch表示,其模型“可能”会使用“一些”YouTube内容进行训练,这与与YouTube创作者达成的协议一致。值得注意的是,去年Google扩展了其服务条款,部分是为了获取更多数据来训练其AI模型。
相关文章
 Gemini 为美国用户提供免费的个性化 AI 图片生成服务
周一,谷歌宣布,Gemini应用将把由Nano Banana驱动的个性化图像生成功能扩展至更广泛的用户群体。从今天起,美国所有符合条件的用户均可免费使用该功能,此前仅限Plus、Pro和Ultra订阅用户使用的限制已被取消。Gemini的“个人智能”功能于4月首次推出,可帮助用户生成符合其特定兴趣的图片。该功能使AI能够根据对用户偏好的理解来创建视觉内容,从而无需在提示词中明确详细说明这些要素。
Gemini的新功能即将集成到Google TV中
周三,谷歌公布了一系列即将登陆谷歌电视(Google TV)的新人工智能驱动功能,其中包括一个专门展示短视频的专区,该专区将把 YouTube Shorts 直接置于主屏幕上。这些更新的核心是围绕Gemini构建的增强功能。在Gemini标签页中,一个“创建”按钮可让用户访问名为Nano Banana和Veo的生成式AI工具。这些工具最初将在美国支持Gemini功能的TCL电视上推出,未来计划支持
“Made by Google ’26”发布会揭晓新产品:Pixel 11、Pixel Watch 5、Pixel Tag 以及增强版 Gemini 功能
在周三举行的“Made by Google 2026”发布会上,谷歌发布了一系列新产品,包括Pixel 11系列、Pixel Watch 5以及一款旨在与苹果AirTag竞争的追踪设备。该公司还重点展示了其全线设备中由Gemini驱动的几项新功能。Gemini在Pixel设备上的实用性进一步提升本次活动的大部分时间都用于展示Gemini以及即将登陆谷歌设备的其他人工智能功能。最值得关注的无障碍功能
相关专题推荐
设计与艺术
 最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
 9 个工具
 xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
设计与艺术
最佳AI创意构思工具,助力艺术家突破视觉瓶颈
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
音乐创作
适用于 TikTok 背景音乐、Reels 音频和创作者宣传音乐的 AI 节拍生成器
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

 评论 (2)
0/500
![EdwardJackson]()
The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
![RalphSanchez]()
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅
在最近一期由LinkedIn联合创始人Reid Hoffman共同主持的播客Possible中,Google DeepMind首席执行官Demis Hassabis分享了关于Google计划的一些激动人心的消息。他透露,Google计划将其Gemini AI模型与Veo视频生成模型合并。这种融合旨在增强Gemini对物理世界的理解,使其更擅长理解现实生活的动态。
Hassabis强调,Gemini从一开始就被设计为多模态。“我们一直以来都将Gemini,我们的基础模型,构建为多模态,”他解释道。这种方法的动机是什么?为一个真正能在日常生活中提供帮助的通用数字助手设定愿景。“一个……在现实世界中真正帮助你的助手,”Hassabis进一步阐述。
AI行业正稳步向所谓的“全能”模型发展——那些能够处理和合成各种类型媒体的模型。例如,Google的最新Gemini版本不仅能生成文本,还能生成音频和图像。与此同时,OpenAI的ChatGPT默认模型可以即时生成图像,包括令人愉悦的吉卜力工作室风格艺术。Amazon也不甘落后,计划在今年晚些时候推出“任意到任意”模型。
这些全能模型需要大量训练数据——包括图像、视频、音频和文本。Hassabis暗示,Veo的视频数据主要来自YouTube,这是Google拥有的一个宝库。“基本上,通过观看YouTube视频——大量的YouTube视频——[Veo 2]可以弄清楚,你知道的,世界的物理规律,”他指出。
Google此前曾对TechCrunch表示,其模型“可能”会使用“一些”YouTube内容进行训练,这与与YouTube创作者达成的协议一致。值得注意的是,去年Google扩展了其服务条款,部分是为了获取更多数据来训练其AI模型。








 Gemini 为美国用户提供免费的个性化 AI 图片生成服务
周一,谷歌宣布,Gemini应用将把由Nano Banana驱动的个性化图像生成功能扩展至更广泛的用户群体。从今天起,美国所有符合条件的用户均可免费使用该功能,此前仅限Plus、Pro和Ultra订阅用户使用的限制已被取消。Gemini的“个人智能”功能于4月首次推出,可帮助用户生成符合其特定兴趣的图片。该功能使AI能够根据对用户偏好的理解来创建视觉内容,从而无需在提示词中明确详细说明这些要素。
 Gemini的新功能即将集成到Google TV中
周三,谷歌公布了一系列即将登陆谷歌电视(Google TV)的新人工智能驱动功能,其中包括一个专门展示短视频的专区,该专区将把 YouTube Shorts 直接置于主屏幕上。这些更新的核心是围绕Gemini构建的增强功能。在Gemini标签页中,一个“创建”按钮可让用户访问名为Nano Banana和Veo的生成式AI工具。这些工具最初将在美国支持Gemini功能的TCL电视上推出,未来计划支持
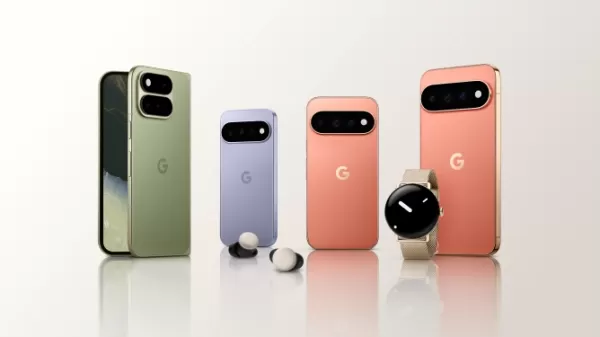 “Made by Google ’26”发布会揭晓新产品:Pixel 11、Pixel Watch 5、Pixel Tag 以及增强版 Gemini 功能
在周三举行的“Made by Google 2026”发布会上,谷歌发布了一系列新产品,包括Pixel 11系列、Pixel Watch 5以及一款旨在与苹果AirTag竞争的追踪设备。该公司还重点展示了其全线设备中由Gemini驱动的几项新功能。Gemini在Pixel设备上的实用性进一步提升本次活动的大部分时间都用于展示Gemini以及即将登陆谷歌设备的其他人工智能功能。最值得关注的无障碍功能

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅












