


 집
Deepmind CEO Demis Hassabis는 Google의 Gemini 및 Veo AI 모델의 향후 통합을 발표했습니다.
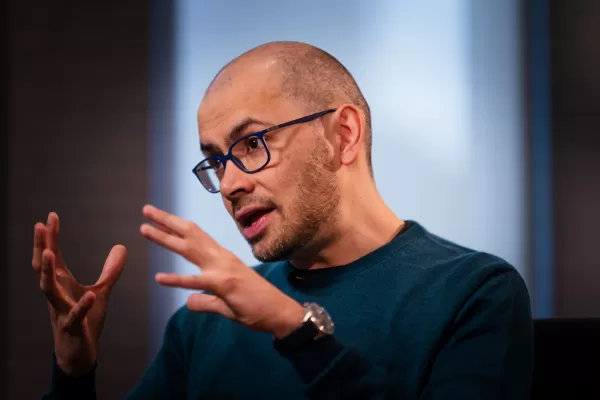
최근 팟캐스트 Possible 에피소드에서 LinkedIn 공동 창립자 Reid Hoffman이 공동 진행자로 출연한 가운데, Google DeepMind CEO Demis Hassabis가 Google의 계획에 대한 흥미로운 소식을 전했습니다. 그는 Google이 Gemini AI 모델을 Veo 비디오 생성 모델과 통합하려고 한다고 밝혔습니다. 이 융합은 Gemini가 물리적 세계를 더 잘 이해하도록 하여 실생활의 역학을 더 효과적으로 파악할 수 있게 하는 것을 목표로 합니다.
Hassabis는 Gemini가 처음부터 다중 모달로 설계되었다고 강조했습니다. "우리는 항상 우리의 기반 모델인 Gemini를 처음부터 다중 모달로 구축해왔습니다,"라고 그는 설명했습니다. 이 접근 방식의 동기는? 일상생활에서 진정으로 도움을 줄 수 있는 범용 디지털 비서를 만들겠다는 비전입니다. "실제 세상에서 … 당신을 실제로 돕는 비서,"라고 Hassabis는 자세히 설명했습니다.
AI 산업은 소위 "옴니" 모델—다양한 유형의 미디어를 처리하고 종합할 수 있는 모델—을 향해 꾸준히 발전하고 있습니다. 예를 들어, Google의 최신 Gemini 버전은 텍스트뿐만 아니라 오디오와 이미지도 생성할 수 있습니다. 한편, OpenAI의 ChatGPT 기본 모델은 즉석에서 이미지를 생성할 수 있으며, Studio Ghibli 스타일의 매력적인 예술 작품도 포함됩니다. Amazon도 뒤처지지 않고 있으며, 올해 말에 "모든 것에서 모든 것으로" 모델을 출시할 계획입니다.
이러한 옴니 모델은 이미지, 비디오, 오디오, 텍스트 등 막대한 양의 훈련 데이터를 요구합니다. Hassabis는 Veo의 비디오 데이터가 주로 YouTube에서 온다고 암시했습니다. YouTube는 Google이 소유한 보물 창고입니다. "기본적으로 YouTube 비디오를—아주 많은 YouTube 비디오를—보면서 [Veo 2]가 세상의 물리학을 파악할 수 있습니다,"라고 그는 언급했습니다.
Google은 이전에 TechCrunch에 자사 모델이 YouTube 크리에이터들과의 계약에 따라 "일부" YouTube 콘텐츠로 훈련될 수 있다고 언급한 바 있습니다. 작년에 Google이 AI 모델 훈련을 위해 더 많은 데이터에 접근하기 위해 서비스 약관을 확대한 점도 주목할 만합니다.
관련 기사
 Gemini는 미국 사용자에게 무료 맞춤형 AI 이미지 생성 서비스를 제공합니다
월요일, 구글은 ‘나노 바나나(Nano Banana)’ 기술을 기반으로 한 ‘제미니(Gemini)’ 앱의 맞춤형 이미지 생성 기능을 더 많은 사용자에게 확대한다고 밝혔습니다. 오늘부터 미국 내 모든 대상 사용자는 이 기능을 무료로 이용할 수 있게 되었으며, 기존에 ‘플러스(Plus)’, ‘프로(Pro)’, ‘울트라(Ultra)’ 구독자만 이용할 수 있었던
구글 TV에 곧 새로운 제미니 기능이 통합될 예정
수요일, 구글은 구글 TV에 도입될 일련의 새로운 AI 기반 기능을 공개했는데, 여기에는 유튜브 숏(YouTube Shorts)을 홈 화면에 바로 표시해 주는 단편 동영상 전용 섹션도 포함되어 있습니다.이번 업데이트의 핵심은 제미니(Gemini)를 기반으로 한 향상된 기능들입니다. 제미니 탭 내의 ‘만들기(Create)’ 버튼을 통해 사용자는 ‘나노 바나나
‘Made by Google ’26’에서 공개된 신제품: 픽셀 11, 픽셀 워치 5, 픽셀 태그, 그리고 강화된 제미니 기능
수요일 열린 ‘Made by Google 2026’ 행사에서 구글은 픽셀 11 시리즈, 픽셀 워치 5, 그리고 애플의 에어태그와 경쟁하기 위해 설계된 추적 기기를 비롯한 다양한 신제품을 공개했습니다. 또한 구글은 자사의 전체 기기 라인업에 걸쳐 제미니(Gemini)가 지원하는 여러 가지 새로운 기능을 강조했습니다.픽셀 기기에서 더욱 확장된 제미니의 활용도행
관련 특별 주제 추천
챗봇
 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 AI 역할극 채팅 앱
2026년 최신 최고 인기 AI 역할극 채팅 앱: 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 선택! XIX.AI는 무료와 유료 비교, 실제 테스트, 매주 업데이트되는 순위 등을 제공하는 강력한 혁신적인 컬렉션을 엄선합니다. 이 필수 도구들은 글쓰기 실력을 향상시키고, 유창성 관련 어려움을 극복하며, 모든 일상 상황에서 의사소통 효율성을 높이는 데 도움을 줍니다. 지금 바로 탐색하여 언어 성장을 위한 완벽한 도구를 발견하세요!
 10 도구
 xix.ai
음악 작곡
리믹스 제작, 샘플링 준비, 카라오케 마스터 파일 제작을 위한 AI 스템 분리 도구
2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai
데이터 분석
수익 대시보드, 퍼널 분석, 그리고 제품 지표를 위한 AI SQL 코파일럿
2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai
음악 작곡
노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

 의견 (2)
0/500
![EdwardJackson]()
The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
![RalphSanchez]()
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅
최근 팟캐스트 Possible 에피소드에서 LinkedIn 공동 창립자 Reid Hoffman이 공동 진행자로 출연한 가운데, Google DeepMind CEO Demis Hassabis가 Google의 계획에 대한 흥미로운 소식을 전했습니다. 그는 Google이 Gemini AI 모델을 Veo 비디오 생성 모델과 통합하려고 한다고 밝혔습니다. 이 융합은 Gemini가 물리적 세계를 더 잘 이해하도록 하여 실생활의 역학을 더 효과적으로 파악할 수 있게 하는 것을 목표로 합니다.
Hassabis는 Gemini가 처음부터 다중 모달로 설계되었다고 강조했습니다. "우리는 항상 우리의 기반 모델인 Gemini를 처음부터 다중 모달로 구축해왔습니다,"라고 그는 설명했습니다. 이 접근 방식의 동기는? 일상생활에서 진정으로 도움을 줄 수 있는 범용 디지털 비서를 만들겠다는 비전입니다. "실제 세상에서 … 당신을 실제로 돕는 비서,"라고 Hassabis는 자세히 설명했습니다.
AI 산업은 소위 "옴니" 모델—다양한 유형의 미디어를 처리하고 종합할 수 있는 모델—을 향해 꾸준히 발전하고 있습니다. 예를 들어, Google의 최신 Gemini 버전은 텍스트뿐만 아니라 오디오와 이미지도 생성할 수 있습니다. 한편, OpenAI의 ChatGPT 기본 모델은 즉석에서 이미지를 생성할 수 있으며, Studio Ghibli 스타일의 매력적인 예술 작품도 포함됩니다. Amazon도 뒤처지지 않고 있으며, 올해 말에 "모든 것에서 모든 것으로" 모델을 출시할 계획입니다.
이러한 옴니 모델은 이미지, 비디오, 오디오, 텍스트 등 막대한 양의 훈련 데이터를 요구합니다. Hassabis는 Veo의 비디오 데이터가 주로 YouTube에서 온다고 암시했습니다. YouTube는 Google이 소유한 보물 창고입니다. "기본적으로 YouTube 비디오를—아주 많은 YouTube 비디오를—보면서 [Veo 2]가 세상의 물리학을 파악할 수 있습니다,"라고 그는 언급했습니다.
Google은 이전에 TechCrunch에 자사 모델이 YouTube 크리에이터들과의 계약에 따라 "일부" YouTube 콘텐츠로 훈련될 수 있다고 언급한 바 있습니다. 작년에 Google이 AI 모델 훈련을 위해 더 많은 데이터에 접근하기 위해 서비스 약관을 확대한 점도 주목할 만합니다.








 Gemini는 미국 사용자에게 무료 맞춤형 AI 이미지 생성 서비스를 제공합니다
월요일, 구글은 ‘나노 바나나(Nano Banana)’ 기술을 기반으로 한 ‘제미니(Gemini)’ 앱의 맞춤형 이미지 생성 기능을 더 많은 사용자에게 확대한다고 밝혔습니다. 오늘부터 미국 내 모든 대상 사용자는 이 기능을 무료로 이용할 수 있게 되었으며, 기존에 ‘플러스(Plus)’, ‘프로(Pro)’, ‘울트라(Ultra)’ 구독자만 이용할 수 있었던
 구글 TV에 곧 새로운 제미니 기능이 통합될 예정
수요일, 구글은 구글 TV에 도입될 일련의 새로운 AI 기반 기능을 공개했는데, 여기에는 유튜브 숏(YouTube Shorts)을 홈 화면에 바로 표시해 주는 단편 동영상 전용 섹션도 포함되어 있습니다.이번 업데이트의 핵심은 제미니(Gemini)를 기반으로 한 향상된 기능들입니다. 제미니 탭 내의 ‘만들기(Create)’ 버튼을 통해 사용자는 ‘나노 바나나
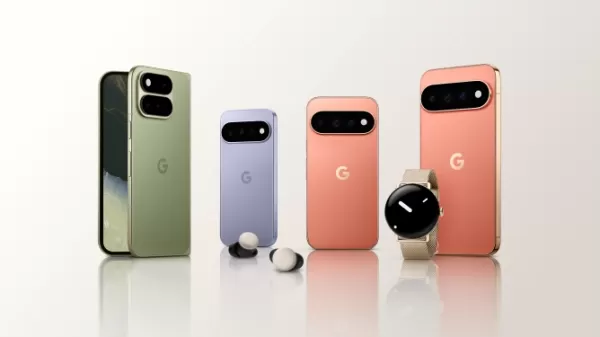 ‘Made by Google ’26’에서 공개된 신제품: 픽셀 11, 픽셀 워치 5, 픽셀 태그, 그리고 강화된 제미니 기능
수요일 열린 ‘Made by Google 2026’ 행사에서 구글은 픽셀 11 시리즈, 픽셀 워치 5, 그리고 애플의 에어태그와 경쟁하기 위해 설계된 추적 기기를 비롯한 다양한 신제품을 공개했습니다. 또한 구글은 자사의 전체 기기 라인업에 걸쳐 제미니(Gemini)가 지원하는 여러 가지 새로운 기능을 강조했습니다.픽셀 기기에서 더욱 확장된 제미니의 활용도행

2026년 최신 최고 인기 AI 역할극 채팅 앱: 언어 연습, 면접 준비 및 일상 유창성을 위한 최고의 선택! XIX.AI는 무료와 유료 비교, 실제 테스트, 매주 업데이트되는 순위 등을 제공하는 강력한 혁신적인 컬렉션을 엄선합니다. 이 필수 도구들은 글쓰기 실력을 향상시키고, 유창성 관련 어려움을 극복하며, 모든 일상 상황에서 의사소통 효율성을 높이는 데 도움을 줍니다. 지금 바로 탐색하여 언어 성장을 위한 완벽한 도구를 발견하세요!
10 도구
xix.ai

2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai

2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅












