


 首頁
DeepMind首席執行官Demis Hassabis宣布了Google的雙子座和VEO AI模型的未來整合
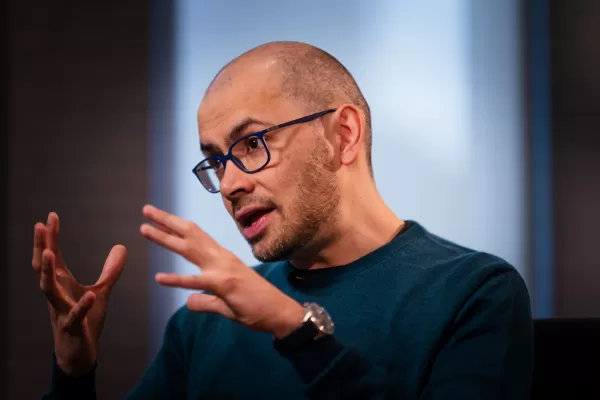
在最近一集的播客《Possible》中,由LinkedIn共同創辦人Reid Hoffman共同主持,Google DeepMind首席執行官Demis Hassabis分享了關於Google計劃的一些令人振奮的消息。他透露,Google正計劃將其Gemini AI模型與Veo視頻生成模型合併。這一融合旨在增強Gemini對物理世界的理解,使其更擅長理解現實生活的動態。
Hassabis強調,從一開始,Gemini就被設計為多模態。「我們一直以來都將Gemini,我們的基礎模型,構建為從一開始就具備多模態功能,」他解釋道。這一方法的動機是什麼?是為了打造一個真正能在日常生活中提供幫助的通用數位助理。「一個……在現實世界中真正幫助你的助理,」Hassabis詳細闡述。
AI產業正穩步朝著你可能稱之為「全能」模型的方向發展——那些能夠處理和合成各種類型媒體的模型。例如,Google的最新Gemini迭代版本不僅能生成文本,還能生成音頻和圖像。與此同時,OpenAI的ChatGPT預設模型可以即時生成圖像,包括令人愉悅的吉卜力工作室風格藝術。Amazon也不落後,計劃在今年晚些時候推出一個「任意到任意」的模型。
這些全能模型需要大量的訓練數據——想想圖像、視頻、音頻和文本。Hassabis暗示,Veo的視頻數據主要來自YouTube,這是Google擁有的寶貴資源。「基本上,通過觀看YouTube視頻——大量的YouTube視頻——[Veo 2]可以弄清楚,你知道的,世界的物理規律,」他指出。
Google此前曾向TechCrunch提到,其模型「可能」會使用「部分」YouTube內容進行訓練,這與與YouTube創作者達成的協議一致。值得注意的是,去年Google擴展了其服務條款,部分原因是為了獲得更多用於訓練其AI模型的數據。
相關文章
 Gemini 向美國用戶提供免費的個人化 AI 圖片生成服務
週一,Google 宣布 Gemini 應用程式將其由 Nano Banana 驅動的個人化影像生成功能,擴展至更廣泛的用戶群。自今日起,美國所有符合資格的用戶均可免費使用此功能,取消了先前僅限 Plus、Pro 和 Ultra 訂閱用戶才能使用的限制。Gemini 的「個人智慧」功能於四月首次推出,讓使用者能生成符合其特定興趣的圖片。此功能使 AI 能根據對您偏好的理解來創作視覺內容,無需在提示
Gemini 的新功能預計將很快整合至 Google TV
週三,Google 公布了一系列即將登陸 Google TV 的人工智慧驅動新功能,其中包括一個專門的短影片區塊,將把 YouTube Shorts 直接置於主畫面。這些更新的核心在於圍繞 Gemini 打造的增強功能。在 Gemini 標籤頁中,一個「創作」按鈕讓使用者能存取名為 Nano Banana 和 Veo 的生成式 AI 工具。這些工具最初將在美國境內支援 Gemini 的 TCL 電
「Made by Google ’26」發表會揭曉新產品:Pixel 11、Pixel Watch 5、Pixel Tag 以及強化版的 Gemini 功能
在週三舉行的「Made by Google 2026」活動中,Google 發表了一系列新產品,包括 Pixel 11 系列、Pixel Watch 5,以及一款專為與 Apple 的 AirTag 競爭而設計的追蹤裝置。該公司還特別強調了其全系列裝置中由 Gemini 驅動的多項新功能。Gemini 在 Pixel 裝置上展現更廣泛的應用活動中相當大篇幅都用於展示 Gemini 以及即將登陸 G
相關專題推薦
聊天機器人
 最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
 12 個工具
 xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
數據分析
最佳人工智慧資料清洗工具:快速處理缺失值與重複資料
2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai
設計與藝術
最佳AI創意構思工具,助力藝術家突破視覺瓶頸
2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

 評論 (2)
0/500
![EdwardJackson]()
The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
![RalphSanchez]()
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅
在最近一集的播客《Possible》中,由LinkedIn共同創辦人Reid Hoffman共同主持,Google DeepMind首席執行官Demis Hassabis分享了關於Google計劃的一些令人振奮的消息。他透露,Google正計劃將其Gemini AI模型與Veo視頻生成模型合併。這一融合旨在增強Gemini對物理世界的理解,使其更擅長理解現實生活的動態。
Hassabis強調,從一開始,Gemini就被設計為多模態。「我們一直以來都將Gemini,我們的基礎模型,構建為從一開始就具備多模態功能,」他解釋道。這一方法的動機是什麼?是為了打造一個真正能在日常生活中提供幫助的通用數位助理。「一個……在現實世界中真正幫助你的助理,」Hassabis詳細闡述。
AI產業正穩步朝著你可能稱之為「全能」模型的方向發展——那些能夠處理和合成各種類型媒體的模型。例如,Google的最新Gemini迭代版本不僅能生成文本,還能生成音頻和圖像。與此同時,OpenAI的ChatGPT預設模型可以即時生成圖像,包括令人愉悅的吉卜力工作室風格藝術。Amazon也不落後,計劃在今年晚些時候推出一個「任意到任意」的模型。
這些全能模型需要大量的訓練數據——想想圖像、視頻、音頻和文本。Hassabis暗示,Veo的視頻數據主要來自YouTube,這是Google擁有的寶貴資源。「基本上,通過觀看YouTube視頻——大量的YouTube視頻——[Veo 2]可以弄清楚,你知道的,世界的物理規律,」他指出。
Google此前曾向TechCrunch提到,其模型「可能」會使用「部分」YouTube內容進行訓練,這與與YouTube創作者達成的協議一致。值得注意的是,去年Google擴展了其服務條款,部分原因是為了獲得更多用於訓練其AI模型的數據。








 Gemini 向美國用戶提供免費的個人化 AI 圖片生成服務
週一,Google 宣布 Gemini 應用程式將其由 Nano Banana 驅動的個人化影像生成功能,擴展至更廣泛的用戶群。自今日起,美國所有符合資格的用戶均可免費使用此功能,取消了先前僅限 Plus、Pro 和 Ultra 訂閱用戶才能使用的限制。Gemini 的「個人智慧」功能於四月首次推出,讓使用者能生成符合其特定興趣的圖片。此功能使 AI 能根據對您偏好的理解來創作視覺內容,無需在提示
 Gemini 的新功能預計將很快整合至 Google TV
週三,Google 公布了一系列即將登陸 Google TV 的人工智慧驅動新功能,其中包括一個專門的短影片區塊,將把 YouTube Shorts 直接置於主畫面。這些更新的核心在於圍繞 Gemini 打造的增強功能。在 Gemini 標籤頁中,一個「創作」按鈕讓使用者能存取名為 Nano Banana 和 Veo 的生成式 AI 工具。這些工具最初將在美國境內支援 Gemini 的 TCL 電
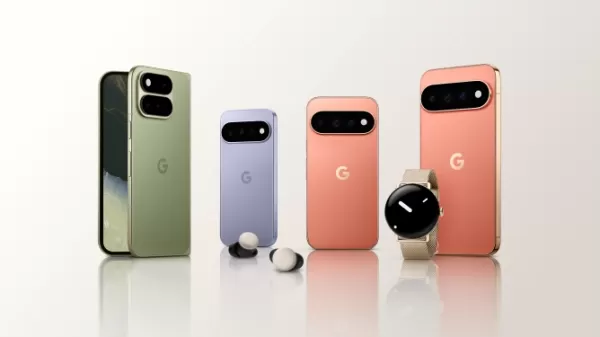 「Made by Google ’26」發表會揭曉新產品:Pixel 11、Pixel Watch 5、Pixel Tag 以及強化版的 Gemini 功能
在週三舉行的「Made by Google 2026」活動中,Google 發表了一系列新產品,包括 Pixel 11 系列、Pixel Watch 5,以及一款專為與 Apple 的 AirTag 競爭而設計的追蹤裝置。該公司還特別強調了其全系列裝置中由 Gemini 驅動的多項新功能。Gemini 在 Pixel 裝置上展現更廣泛的應用活動中相當大篇幅都用於展示 Gemini 以及即將登陸 G

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

The integration of Gemini and Veo sounds promising! Could this be the key to generating truly coherent multimodal content, or are we just stitching together different black boxes? The computational cost for such combined models might be enormous though. A fascinating glimpse into the future roadmap of Google's AI.
Wow, merging Gemini with Veo sounds like a game-changer! Can't wait to see how this powers up video creation. But, like, is Google trying to dominate every AI corner now? 😅












