


 首页
Codex 为 GPT-5.6 Sol 提供了 100 万个新的上下文数据点,ChatGPT 用户也可使用
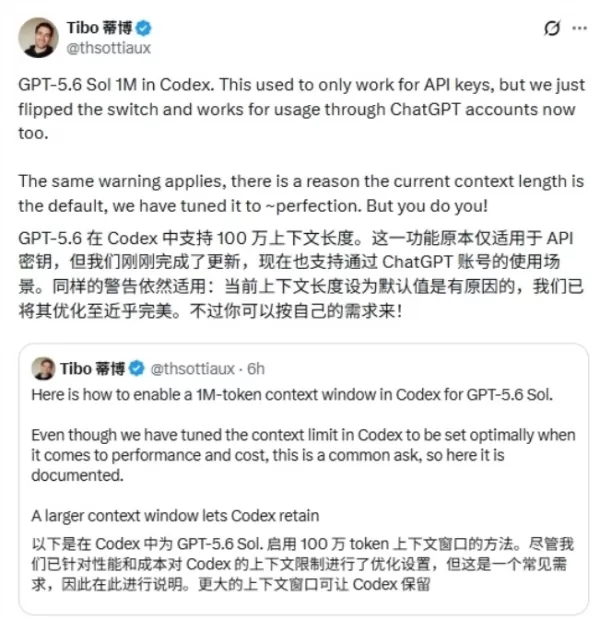
负责OpenAI旗下Codex和ChatGPT项目的工程师Tibo在X平台发布消息称,Codex中GPT-5.6 Sol模型的100万令牌上下文窗口功能,现已不再仅限于API密钥持有者,ChatGPT账户用户也可使用该功能。 这一变更消除了此前的一项限制,该限制曾迫使订阅用户在处理大规模任务时不得不截断长期项目历史记录。
订阅用户可手动启用100万令牌上下文设置
蒂博解释称,Codex中的GPT-5.6 Sol现支持100万令牌的上下文长度,这一功能此前仅限API密钥持有者使用。 他指出,该功能已通过 ChatGPT 账户启用,持有 Plus、Pro 或其他订阅套餐的用户在使用 Codex 编程助手时,可手动配置以充分利用 105 万令牌的容量。
更大的上下文窗口使 Codex 能够在自动压缩启动前保留更多的代码片段、工具输出和对话历史记录,这对大规模代码库重构、复杂调试和长时间会话等专业用例特别有益。对于管理生产级代码库的开发者而言,这一改进直接解决了此前频繁出现的上下文耗尽问题。
默认设置是经过慎重考量的;启用该功能需审慎权衡
Tibo 还强调,当前的默认上下文长度是权衡性能需求与成本考量后的结果,而非随意设定。他建议用户根据自身需求做出明智的决策。多位开发者补充道,得益于 Codex 的服务器端压缩技术,默认配置对于大多数常规任务已足够使用。
尽管如此,仍有部分用户反映,启用“100 万令牌”上下文设置会导致订阅配额消耗加快,单次高强度会话就可能耗尽其每周配额的相当一部分。专家建议仅在必要时启用此功能,而非将其作为日常使用的默认设置,以防止关键项目过早触及使用上限。
相关文章
 德国研究联盟发布开源人工智能模型Soofi
德国人工智能协会(German Association for Artificial Intelligence)正式发布了 Soofi S30B-A3B,这是一款全新的开源大型语言模型。这一里程碑事件推动了欧洲自主 AI 基础设施的发展,并以高性能和效率为重点,重振了开源领域。Soofi S30B-A3B 采用了一种平衡效率与能力的创新架构。该模型结合了混合专家(MoE)设计、Mamba-2 以及标准注意力层,包含 316 亿个参数,但每个令牌仅激活约 32 亿个参数。这种方法大幅降低了计算成本
丰田64亿美元机器人估算使物理人工智能成为焦点
丰田汽车预计,自2028年起,在其制造设施、子公司及关键供应商中全面推广自动化,可能需要约40万台机器人,年支出约为1万亿日元(64亿美元)。据路透社报道,这一潜在投资方案已于9月初向投资者展示。丰田尚未确认全额投资是否会推进,也未说明如此规模的支出将持续多久。这40万台机器人的估算涵盖了现有设备的替换和新设备的安装,包括人形和非人形系统。该投资范围包括工业机器人、自动化物流以及工厂车间内的未来协作机器人。丰田目前在各个制造阶段利用并测试机器人技术。在其2026财年财务结果中,公司强调了涉及零部
Meta 在消费级硬件上为本地 AI 代理开源了具有 300 亿参数的 Muse Glimmer
8月10日,Meta推出了Muse Glimmer,这是一款旨在赋能消费级硬件上本地AI代理的开源模型,标志着其“个人超级智能”战略的关键一步。拥有300亿参数,该模型是Meta于4月推出的闭源Muse Spark的开源对应版本。Muse Glimmer以Apache 2.0许可证发布,允许开发者自由下载、修改和调整权重。专为复杂的多步代理任务而构建,Muse Glimmer可以调用工具、编写和调试代码、管理文件和截图,并执行扩展工作流。该模型支持文本和图像,使用超过100种语言进行训练,可在
相关专题推荐
生产率
 面向忙碌专业人士的AI任务规划工具
2026年最新最佳、评分最高的AI任务规划工具,专为忙碌的专业人士打造!XIX.AI精心精选了一系列功能强大、具有颠覆性的高效工具,帮助用户优化工作流程、提升工作效率,并克服日常日程安排的挑战。每款工具都经过严格的实际测试,以确保其可靠性。 获取免费版与付费版的对比指南,发现能助您发挥 AI 优势的完美工具。立即探索!
 15 个工具
 xix.ai
聊天机器人
顶级 AI 客户聊天机器人:全天候解答常见问题并筛选潜在客户
2026 年最新顶级 AI 客户聊天机器人精选列表中的佼佼者,是即时回答客户常见问题并全天候筛选潜在客户的最优解决方案。XIX.AI 进行了严格的真实世界测试,提供详细的免费与付费版对比以及最新排名,帮助您找到能够显著提升生产力的强大变革性工具。立即探索,发现您完美的 AI 聊天机器人解决方案!
9 个工具
xix.ai
设计与艺术
面向广告创意团队的AI分镜生成器
2026年广告创意团队必备的最新最佳AI分镜生成器!XIX.AI 通过实际测试和每周更新的严格排名,精心甄选出一份备受好评的强大且具有颠覆性的工具清单,帮助团队更快地创作令人惊艳的视觉内容。 通过免费版与付费版的对比,找到最适合您工作流程的工具。立即探索,在广告创作中释放您的AI优势!
8 个工具
xix.ai
聊天机器人
用于内部文档的AI知识聊天机器人工具
2026年最新、最受欢迎且评价最高的内部文档AI知识聊天机器人工具已登陆XIX.AI!这份精心筛选的清单汇集了功能强大且具有革命性意义的解决方案,它们能帮助团队快速生成高质量内容、简化文档创建流程并克服常见的写作难题,从而显著提升工作效率。 我们进行了严格的实际测试,并提供每周更新的免费版与付费版对比分析以及详细排名,助您找到最符合需求的必试之选。立即探索,发现最适合您的工具!
12 个工具
xix.ai
文字转语音
最佳 AI 文字转语音工具:为视频制作自然配音
2026 年最新最佳顶级评分 AI 文本转语音工具,专为制作视频中的自然配音而精心策划。XIX.AI 提供强大且改变游戏规则的方案,提升写作效率,助你突破创作瓶颈。我们进行真实世界测试,提供免费与付费版对比,并每周更新排名。经过严格评估后重点推荐必试选项。立即探索,发现提升视频质量的完美工具。
9 个工具
xix.ai
金融
最佳人工智能欺诈检测工具:在损失扩大前发现可疑模式
由 XIX.AI 精选的 2026 年最新、最佳、评分最高的 AI 欺诈检测工具,提供功能强大且具有变革性的解决方案,可快速识别可疑模式,防止造成巨额损失。 获取免费版与付费版的对比分析、实际测试结果以及详细排名,助您选择必试方案,从而提升安全防护效率。立即探索,释放您的AI优势。
10 个工具
xix.ai

 评论 (0)
0/500
负责OpenAI旗下Codex和ChatGPT项目的工程师Tibo在X平台发布消息称,Codex中GPT-5.6 Sol模型的100万令牌上下文窗口功能,现已不再仅限于API密钥持有者,ChatGPT账户用户也可使用该功能。 这一变更消除了此前的一项限制,该限制曾迫使订阅用户在处理大规模任务时不得不截断长期项目历史记录。
订阅用户可手动启用100万令牌上下文设置
蒂博解释称,Codex中的GPT-5.6 Sol现支持100万令牌的上下文长度,这一功能此前仅限API密钥持有者使用。 他指出,该功能已通过 ChatGPT 账户启用,持有 Plus、Pro 或其他订阅套餐的用户在使用 Codex 编程助手时,可手动配置以充分利用 105 万令牌的容量。
更大的上下文窗口使 Codex 能够在自动压缩启动前保留更多的代码片段、工具输出和对话历史记录,这对大规模代码库重构、复杂调试和长时间会话等专业用例特别有益。对于管理生产级代码库的开发者而言,这一改进直接解决了此前频繁出现的上下文耗尽问题。
默认设置是经过慎重考量的;启用该功能需审慎权衡
Tibo 还强调,当前的默认上下文长度是权衡性能需求与成本考量后的结果,而非随意设定。他建议用户根据自身需求做出明智的决策。多位开发者补充道,得益于 Codex 的服务器端压缩技术,默认配置对于大多数常规任务已足够使用。
尽管如此,仍有部分用户反映,启用“100 万令牌”上下文设置会导致订阅配额消耗加快,单次高强度会话就可能耗尽其每周配额的相当一部分。专家建议仅在必要时启用此功能,而非将其作为日常使用的默认设置,以防止关键项目过早触及使用上限。








 德国研究联盟发布开源人工智能模型Soofi
德国人工智能协会(German Association for Artificial Intelligence)正式发布了 Soofi S30B-A3B,这是一款全新的开源大型语言模型。这一里程碑事件推动了欧洲自主 AI 基础设施的发展,并以高性能和效率为重点,重振了开源领域。Soofi S30B-A3B 采用了一种平衡效率与能力的创新架构。该模型结合了混合专家(MoE)设计、Mamba-2 以及标准注意力层,包含 316 亿个参数,但每个令牌仅激活约 32 亿个参数。这种方法大幅降低了计算成本
 丰田64亿美元机器人估算使物理人工智能成为焦点
丰田汽车预计,自2028年起,在其制造设施、子公司及关键供应商中全面推广自动化,可能需要约40万台机器人,年支出约为1万亿日元(64亿美元)。据路透社报道,这一潜在投资方案已于9月初向投资者展示。丰田尚未确认全额投资是否会推进,也未说明如此规模的支出将持续多久。这40万台机器人的估算涵盖了现有设备的替换和新设备的安装,包括人形和非人形系统。该投资范围包括工业机器人、自动化物流以及工厂车间内的未来协作机器人。丰田目前在各个制造阶段利用并测试机器人技术。在其2026财年财务结果中,公司强调了涉及零部
 Meta 在消费级硬件上为本地 AI 代理开源了具有 300 亿参数的 Muse Glimmer
8月10日,Meta推出了Muse Glimmer,这是一款旨在赋能消费级硬件上本地AI代理的开源模型,标志着其“个人超级智能”战略的关键一步。拥有300亿参数,该模型是Meta于4月推出的闭源Muse Spark的开源对应版本。Muse Glimmer以Apache 2.0许可证发布,允许开发者自由下载、修改和调整权重。专为复杂的多步代理任务而构建,Muse Glimmer可以调用工具、编写和调试代码、管理文件和截图,并执行扩展工作流。该模型支持文本和图像,使用超过100种语言进行训练,可在
2026年最新最佳、评分最高的AI任务规划工具,专为忙碌的专业人士打造!XIX.AI精心精选了一系列功能强大、具有颠覆性的高效工具,帮助用户优化工作流程、提升工作效率,并克服日常日程安排的挑战。每款工具都经过严格的实际测试,以确保其可靠性。 获取免费版与付费版的对比指南,发现能助您发挥 AI 优势的完美工具。立即探索!
15 个工具
xix.ai
2026 年最新顶级 AI 客户聊天机器人精选列表中的佼佼者,是即时回答客户常见问题并全天候筛选潜在客户的最优解决方案。XIX.AI 进行了严格的真实世界测试,提供详细的免费与付费版对比以及最新排名,帮助您找到能够显著提升生产力的强大变革性工具。立即探索,发现您完美的 AI 聊天机器人解决方案!
9 个工具
xix.ai
2026年广告创意团队必备的最新最佳AI分镜生成器!XIX.AI 通过实际测试和每周更新的严格排名,精心甄选出一份备受好评的强大且具有颠覆性的工具清单,帮助团队更快地创作令人惊艳的视觉内容。 通过免费版与付费版的对比,找到最适合您工作流程的工具。立即探索,在广告创作中释放您的AI优势!
8 个工具
xix.ai
2026年最新、最受欢迎且评价最高的内部文档AI知识聊天机器人工具已登陆XIX.AI!这份精心筛选的清单汇集了功能强大且具有革命性意义的解决方案,它们能帮助团队快速生成高质量内容、简化文档创建流程并克服常见的写作难题,从而显著提升工作效率。 我们进行了严格的实际测试,并提供每周更新的免费版与付费版对比分析以及详细排名,助您找到最符合需求的必试之选。立即探索,发现最适合您的工具!
12 个工具
xix.ai
2026 年最新最佳顶级评分 AI 文本转语音工具,专为制作视频中的自然配音而精心策划。XIX.AI 提供强大且改变游戏规则的方案,提升写作效率,助你突破创作瓶颈。我们进行真实世界测试,提供免费与付费版对比,并每周更新排名。经过严格评估后重点推荐必试选项。立即探索,发现提升视频质量的完美工具。
9 个工具
xix.ai
由 XIX.AI 精选的 2026 年最新、最佳、评分最高的 AI 欺诈检测工具,提供功能强大且具有变革性的解决方案,可快速识别可疑模式,防止造成巨额损失。 获取免费版与付费版的对比分析、实际测试结果以及详细排名,助您选择必试方案,从而提升安全防护效率。立即探索,释放您的AI优势。
10 个工具
xix.ai












