


 Maison
Codex fournit un million de nouveaux points de données contextuels pour GPT-5.6 Sol, également accessibles aux utilisateurs de ChatGPT
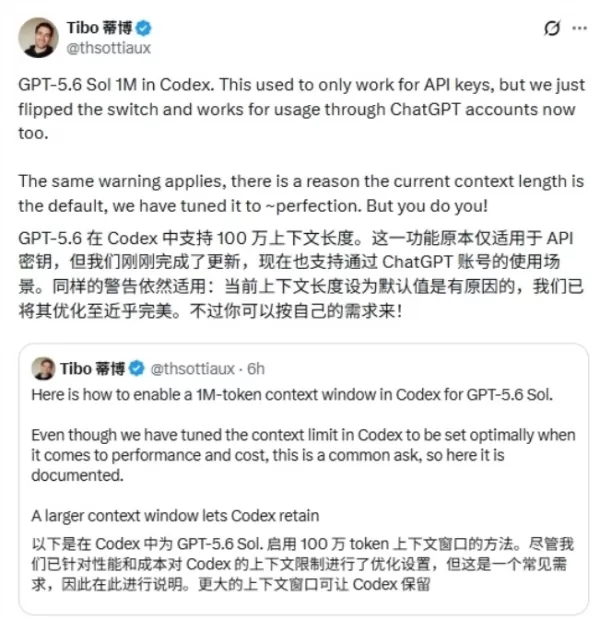
L'ingénieur Tibo, responsable de Codex et ChatGPT chez OpenAI, a annoncé sur X que la fonctionnalité de fenêtre de contexte d'un million de tokens du modèle GPT-5.6 Sol intégré à Codex n'était désormais plus réservée aux détenteurs d'une clé API, mais qu'elle était également accessible aux utilisateurs disposant d'un compte ChatGPT. Ce changement supprime la limitation précédente qui obligeait les utilisateurs abonnés à interrompre l’historique de leurs projets à long terme lorsqu’ils traitaient des tâches de grande envergure.
Les utilisateurs abonnés peuvent activer manuellement le paramètre de contexte d’un million de tokens
Tibo a expliqué que le modèle GPT-5.6 Sol de Codex prend désormais en charge une longueur de contexte de 1 million de tokens, une fonctionnalité auparavant réservée exclusivement aux détenteurs de clés API. Il a précisé que cette fonctionnalité a déjà été activée via les comptes ChatGPT et que les utilisateurs disposant d’un abonnement Plus, Pro ou d’autres formules peuvent la configurer manuellement pour exploiter pleinement la capacité de 1,05 million de tokens lorsqu’ils travaillent avec l’agent de programmation Codex.
Une fenêtre de contexte plus grande permet à Codex de conserver davantage d’extraits de code, de résultats d’outils et d’historique de conversation avant que la compression automatique ne se déclenche, ce qui est particulièrement avantageux pour des cas d’utilisation professionnels tels que la restructuration de bases de code à grande échelle, le débogage complexe et les sessions prolongées. Pour les développeurs gérant des dépôts de niveau production, cette amélioration résout directement le problème antérieur d’épuisement fréquent du contexte.
Le paramètre par défaut a été soigneusement choisi ; son activation nécessite une réflexion approfondie
Tibo a également souligné que la longueur de contexte par défaut actuelle résulte d’un équilibre entre les besoins en performances et les considérations de coût, et n’a pas été fixée de manière arbitraire. Il a conseillé aux utilisateurs de prendre une décision éclairée en fonction de leurs propres besoins. Plusieurs développeurs ont ajouté que, grâce à la technologie de compression côté serveur de Codex, la configuration par défaut est suffisante pour la plupart des tâches courantes.
Néanmoins, certains utilisateurs ont signalé que l’activation du paramètre de contexte d’un million de tokens entraîne une consommation plus rapide de leurs quotas d’abonnement, une seule session intensive pouvant potentiellement épuiser une part significative de leur allocation hebdomadaire. Les experts recommandent de n’activer cette fonctionnalité qu’en cas de nécessité, plutôt que de la définir comme paramètre par défaut pour une utilisation quotidienne, afin d’éviter d’atteindre prématurément les limites d’utilisation sur des projets critiques.
Article connexe
 Le consortium de recherche allemand dévoile le modèle d'IA open-source Soofi
L'Association allemande pour l'intelligence artificielle a officiellement lancé Soofi S30B-A3B, un nouveau modèle de langage large open source. Cette étape marque une avancée majeure pour l'infrastructure souveraine européenne en matière d'IA et dyna
L'estimation de 6,4 milliards de dollars de Toyota consacrée à la robotique place l'IA physique sous les projecteurs
Toyota Motor prévoit que le déploiement de l’automatisation dans ses installations de fabrication, ses filiales et ses principaux fournisseurs pourrait nécessiter environ 400 000 robots et une dépense annuelle d’environ 1 000 milliards de yens (6,4 m
Meta Open-Sources 30B-Parameter Muse Glimmer for Local AI Agent on Consumer Hardware
Le 10 août, Meta a lancé Muse Glimmer, un modèle open source conçu pour autonomiser les agents IA locaux sur le matériel grand public, marquant une étape clé de sa stratégie « Superintelligence Personnelle ». Avec 30 milliards de paramètres, ce modèl
Recommandations de sujets spéciaux liés
Productivité
 Outils de planification des tâches basés sur l'IA pour les professionnels très occupés
Les meilleurs outils de planification des tâches basés sur l'IA de 2026, les mieux notés, pour les professionnels très occupés ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, d'une grande efficacité, qui aident les utilisateurs à rationaliser leurs flux de travail, à booster leur productivité et à surmonter les défis quotidiens liés à la planification. Chaque option est soumise à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez notre comparatif entre les versions gratuites et payantes et découvrez l'outil idéal pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
 15 outils
 xix.ai
chatbot
Top des chatbots clients IA : Répondez aux FAQ et qualifiez les prospects 24h/24 et 7j/7
Les chatbots clients IA les mieux notés de 2026, présentés dans cette liste sélectionnée, sont les meilleures solutions pour répondre instantanément aux questions fréquentes des clients et qualifier les prospects 24h/24 et 7j/7. XIX.AI a réalisé des tests rigoureux en conditions réelles pour fournir une comparaison détaillée entre les versions gratuite et payante, ainsi que des classements à jour, vous aidant ainsi à trouver un outil puissant et transformateur qui améliore considérablement la productivité. Explorez dès maintenant pour découvrir votre solution de chatbot IA idéale !
9 outils
xix.ai
Conception et art
Générateurs de storyboards basés sur l'IA destinés aux équipes créatives publicitaires
Les meilleurs générateurs de storyboards basés sur l'IA de 2026 pour les équipes créatives publicitaires ! XIX.AI a sélectionné une liste des outils les mieux notés, à la fois puissants et révolutionnaires, qui aident les équipes à créer plus rapidement des contenus visuels époustouflants, grâce à des tests en conditions réelles et à un classement rigoureux mis à jour chaque semaine. Profitez d'une comparaison entre les versions gratuites et payantes pour trouver celle qui correspond le mieux à votre flux de travail. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA dans la création publicitaire !
8 outils
xix.ai
chatbot
Outils de chatbot de connaissances IA pour la documentation interne
2026 Dernières Meilleures Outils de Chatbot IA les mieux notés pour la Documentation Interne sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité en aidant les équipes à générer rapidement du contenu de haute qualité, rationaliser la création de documentation et surmonner les défis courants d’écriture. Nous effectuons des tests rigoureux en conditions réelles et fournissons une comparaison hebdomadaire gratuite vs payante ainsi que des classements détaillés pour vous aider à trouver l’option incontournable qui correspond le mieux à vos besoins. Explorez dès maintenant pour découvrir votre outil parfait !
12 outils
xix.ai
Synthèse vocale
Meilleurs outils d’IA de synthèse vocale : créez des voix off naturelles pour vos vidéos
2026 Derniers Meilleurs Outils de Synthèse Vocale par IA les mieux notés, sélectionnés pour créer des voix off naturelles dans les vidéos. XIX.AI propose des solutions puissantes et révolutionnaires qui améliorent l'efficacité de l'écriture et vous aident à surmonner les blocages créatifs. Nous réalisons des tests en conditions réelles, proposons des comparaisons entre versions gratuites et payantes, et mettons à jour nos classements chaque semaine. Les options incontournables sont mises en avant sur la base d'évaluations rigoureuses. Explorez dès maintenant pour découvrir l'outil parfait afin d'améliorer la qualité de vos vidéos.
9 outils
xix.ai
Finance
Les meilleurs outils de détection des fraudes basés sur l'IA : repérez les comportements suspects avant que les pertes ne s'aggravent
Les meilleurs outils de détection des fraudes basés sur l'IA de 2026, sélectionnés par XIX.AI, offrent des solutions puissantes et révolutionnaires pour repérer rapidement les comportements suspects et éviter des pertes coûteuses. Découvrez une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à choisir l'option incontournable qui renforcera l'efficacité de votre sécurité. Explorez dès maintenant pour exploiter pleinement votre avantage en matière d’IA.
10 outils
xix.ai

 commentaires (0)
L'ingénieur Tibo, responsable de Codex et ChatGPT chez OpenAI, a annoncé sur X que la fonctionnalité de fenêtre de contexte d'un million de tokens du modèle GPT-5.6 Sol intégré à Codex n'était désormais plus réservée aux détenteurs d'une clé API, mais qu'elle était également accessible aux utilisateurs disposant d'un compte ChatGPT. Ce changement supprime la limitation précédente qui obligeait les utilisateurs abonnés à interrompre l’historique de leurs projets à long terme lorsqu’ils traitaient des tâches de grande envergure.
Les utilisateurs abonnés peuvent activer manuellement le paramètre de contexte d’un million de tokens
Tibo a expliqué que le modèle GPT-5.6 Sol de Codex prend désormais en charge une longueur de contexte de 1 million de tokens, une fonctionnalité auparavant réservée exclusivement aux détenteurs de clés API. Il a précisé que cette fonctionnalité a déjà été activée via les comptes ChatGPT et que les utilisateurs disposant d’un abonnement Plus, Pro ou d’autres formules peuvent la configurer manuellement pour exploiter pleinement la capacité de 1,05 million de tokens lorsqu’ils travaillent avec l’agent de programmation Codex.
Une fenêtre de contexte plus grande permet à Codex de conserver davantage d’extraits de code, de résultats d’outils et d’historique de conversation avant que la compression automatique ne se déclenche, ce qui est particulièrement avantageux pour des cas d’utilisation professionnels tels que la restructuration de bases de code à grande échelle, le débogage complexe et les sessions prolongées. Pour les développeurs gérant des dépôts de niveau production, cette amélioration résout directement le problème antérieur d’épuisement fréquent du contexte.
Le paramètre par défaut a été soigneusement choisi ; son activation nécessite une réflexion approfondie
Tibo a également souligné que la longueur de contexte par défaut actuelle résulte d’un équilibre entre les besoins en performances et les considérations de coût, et n’a pas été fixée de manière arbitraire. Il a conseillé aux utilisateurs de prendre une décision éclairée en fonction de leurs propres besoins. Plusieurs développeurs ont ajouté que, grâce à la technologie de compression côté serveur de Codex, la configuration par défaut est suffisante pour la plupart des tâches courantes.
Néanmoins, certains utilisateurs ont signalé que l’activation du paramètre de contexte d’un million de tokens entraîne une consommation plus rapide de leurs quotas d’abonnement, une seule session intensive pouvant potentiellement épuiser une part significative de leur allocation hebdomadaire. Les experts recommandent de n’activer cette fonctionnalité qu’en cas de nécessité, plutôt que de la définir comme paramètre par défaut pour une utilisation quotidienne, afin d’éviter d’atteindre prématurément les limites d’utilisation sur des projets critiques.








 Le consortium de recherche allemand dévoile le modèle d'IA open-source Soofi
L'Association allemande pour l'intelligence artificielle a officiellement lancé Soofi S30B-A3B, un nouveau modèle de langage large open source. Cette étape marque une avancée majeure pour l'infrastructure souveraine européenne en matière d'IA et dyna
 L'estimation de 6,4 milliards de dollars de Toyota consacrée à la robotique place l'IA physique sous les projecteurs
Toyota Motor prévoit que le déploiement de l’automatisation dans ses installations de fabrication, ses filiales et ses principaux fournisseurs pourrait nécessiter environ 400 000 robots et une dépense annuelle d’environ 1 000 milliards de yens (6,4 m
 Meta Open-Sources 30B-Parameter Muse Glimmer for Local AI Agent on Consumer Hardware
Le 10 août, Meta a lancé Muse Glimmer, un modèle open source conçu pour autonomiser les agents IA locaux sur le matériel grand public, marquant une étape clé de sa stratégie « Superintelligence Personnelle ». Avec 30 milliards de paramètres, ce modèl
Les meilleurs outils de planification des tâches basés sur l'IA de 2026, les mieux notés, pour les professionnels très occupés ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, d'une grande efficacité, qui aident les utilisateurs à rationaliser leurs flux de travail, à booster leur productivité et à surmonter les défis quotidiens liés à la planification. Chaque option est soumise à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez notre comparatif entre les versions gratuites et payantes et découvrez l'outil idéal pour tirer pleinement parti de l'IA. Découvrez-les dès maintenant !
15 outils
xix.ai
Les chatbots clients IA les mieux notés de 2026, présentés dans cette liste sélectionnée, sont les meilleures solutions pour répondre instantanément aux questions fréquentes des clients et qualifier les prospects 24h/24 et 7j/7. XIX.AI a réalisé des tests rigoureux en conditions réelles pour fournir une comparaison détaillée entre les versions gratuite et payante, ainsi que des classements à jour, vous aidant ainsi à trouver un outil puissant et transformateur qui améliore considérablement la productivité. Explorez dès maintenant pour découvrir votre solution de chatbot IA idéale !
9 outils
xix.ai
Les meilleurs générateurs de storyboards basés sur l'IA de 2026 pour les équipes créatives publicitaires ! XIX.AI a sélectionné une liste des outils les mieux notés, à la fois puissants et révolutionnaires, qui aident les équipes à créer plus rapidement des contenus visuels époustouflants, grâce à des tests en conditions réelles et à un classement rigoureux mis à jour chaque semaine. Profitez d'une comparaison entre les versions gratuites et payantes pour trouver celle qui correspond le mieux à votre flux de travail. Découvrez-les dès maintenant pour exploiter pleinement le potentiel de l'IA dans la création publicitaire !
8 outils
xix.ai
2026 Dernières Meilleures Outils de Chatbot IA les mieux notés pour la Documentation Interne sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui augmentent considérablement la productivité en aidant les équipes à générer rapidement du contenu de haute qualité, rationaliser la création de documentation et surmonner les défis courants d’écriture. Nous effectuons des tests rigoureux en conditions réelles et fournissons une comparaison hebdomadaire gratuite vs payante ainsi que des classements détaillés pour vous aider à trouver l’option incontournable qui correspond le mieux à vos besoins. Explorez dès maintenant pour découvrir votre outil parfait !
12 outils
xix.ai
2026 Derniers Meilleurs Outils de Synthèse Vocale par IA les mieux notés, sélectionnés pour créer des voix off naturelles dans les vidéos. XIX.AI propose des solutions puissantes et révolutionnaires qui améliorent l'efficacité de l'écriture et vous aident à surmonner les blocages créatifs. Nous réalisons des tests en conditions réelles, proposons des comparaisons entre versions gratuites et payantes, et mettons à jour nos classements chaque semaine. Les options incontournables sont mises en avant sur la base d'évaluations rigoureuses. Explorez dès maintenant pour découvrir l'outil parfait afin d'améliorer la qualité de vos vidéos.
9 outils
xix.ai
Les meilleurs outils de détection des fraudes basés sur l'IA de 2026, sélectionnés par XIX.AI, offrent des solutions puissantes et révolutionnaires pour repérer rapidement les comportements suspects et éviter des pertes coûteuses. Découvrez une comparaison entre les versions gratuites et payantes, des tests en conditions réelles et des classements détaillés pour vous aider à choisir l'option incontournable qui renforcera l'efficacité de votre sécurité. Explorez dès maintenant pour exploiter pleinement votre avantage en matière d’IA.
10 outils
xix.ai












