


 Hogar
Codex aporta un millón de nuevos puntos de datos contextuales para GPT-5.6 Sol, que también estarán disponibles para los usuarios de ChatGPT
El ingeniero Tibo, responsable de Codex y ChatGPT en OpenAI, ha compartido una noticia en X en la que indica que la función de ventana de contexto de 1 millón de tokens del modelo GPT-5.6 Sol, integrado en Codex, ya está disponible no solo para los titulares de claves API, sino también para los usuarios de cuentas de ChatGPT. Este cambio elimina la limitación anterior que obligaba a los usuarios suscritos a recortar los historiales de proyectos a largo plazo al abordar tareas a gran escala.
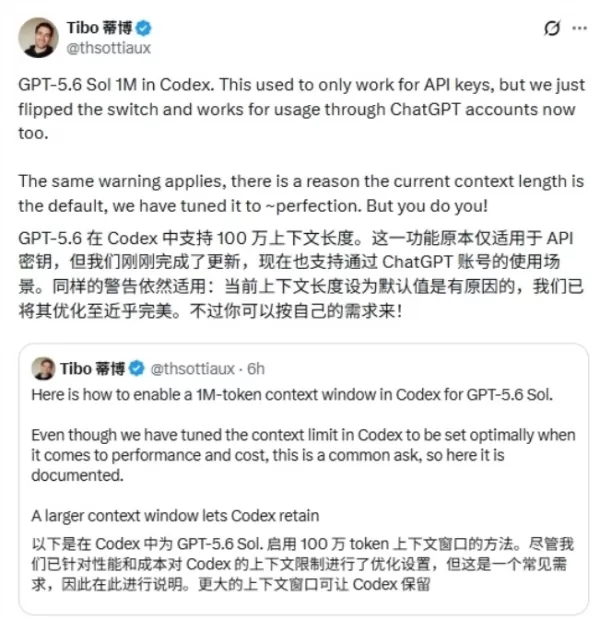
Los usuarios suscritos pueden activar manualmente la configuración de contexto de un millón de tokens
Tibo explicó que GPT-5.6 Sol en Codex admite ahora una longitud de contexto de un millón de tokens, una capacidad que antes estaba reservada exclusivamente a los titulares de claves API. Señaló que la función ya se ha activado a través de las cuentas de ChatGPT y que los usuarios con planes de suscripción Plus, Pro u otros pueden configurarla manualmente para aprovechar toda la capacidad de 1,05 millones de tokens al trabajar con el agente de programación de Codex.
Una ventana de contexto más amplia permite a Codex conservar más fragmentos de código, resultados de herramientas e historial de conversaciones antes de que se active la compresión automática, lo cual resulta especialmente beneficioso para casos de uso profesional, como la reestructuración de bases de código a gran escala, la depuración compleja y las sesiones prolongadas. Para los desarrolladores que gestionan repositorios a nivel de producción, esta mejora resuelve directamente el problema anterior del agotamiento frecuente del contexto.
La configuración predeterminada se eligió cuidadosamente; habilitarla requiere una reflexión minuciosa
Tibo también destacó que la longitud predeterminada actual del contexto es el resultado de equilibrar las necesidades de rendimiento con las consideraciones de coste, y no se ha establecido de forma arbitraria. Aconsejó a los usuarios que tomaran una decisión informada basada en sus propios requisitos. Varios desarrolladores añadieron que, gracias a la tecnología de compresión del lado del servidor de Codex, la configuración predeterminada es suficiente para la mayoría de las tareas rutinarias.
No obstante, algunos usuarios han informado de que activar la configuración de contexto de un millón de tokens provoca un consumo más rápido de sus cuotas de suscripción, pudiendo una sola sesión intensiva agotar una parte significativa de su asignación semanal. Los expertos recomiendan habilitar esta función solo cuando sea necesario, en lugar de como configuración predeterminada para el uso diario, a fin de evitar alcanzar los límites de uso prematuramente en proyectos críticos.
Artículo relacionado
 El Consorcio de Investigación Alemán Desvela el Modelo de IA de Código Abierto Soofi
La Asociación Alemana de Inteligencia Artificial ha lanzado oficialmente Soofi S30B-A3B, un nuevo modelo de lenguaje grande de código abierto. Este hito avanza la infraestructura de IA soberana de Europa y revitaliza el sector de código abierto con u
La estimación de 6.400 millones de dólares de Toyota en robótica pone la IA física en el centro de atención
Toyota Motor proyecta que la implementación de la automatización en sus instalaciones de fabricación, filiales y proveedores clave podría requerir aproximadamente 400.000 robots y un gasto anual de unos 1 billón de yenes (6.400 millones de dólares) a
Meta abre el código fuente de Muse Glimmer de 30 mil millones de parámetros para agentes de IA locales en hardware de consumo
El 10 de agosto, Meta lanzó Muse Glimmer, un modelo de código abierto diseñado para potenciar agentes de IA locales en hardware de consumo, marcando un paso clave en su estrategia de «Superinteligencia Personal». Con 30.000 millones de parámetros, es
Recomendaciones de temas especiales relacionados
Productividad
 Herramientas de planificación de tareas basadas en IA para profesionales con una agenda apretada
¡Las mejores herramientas de planificación de tareas con IA mejor valoradas de 2026 para profesionales ocupados! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias y altamente eficientes que ayudan a los usuarios a optimizar los flujos de trabajo, aumentar la productividad y superar los retos diarios de planificación. Cada opción se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad. Consigue una comparación entre las versiones gratuitas y de pago y descubre la herramienta perfecta para sacar el máximo partido a la IA. ¡Explora ahora!
 15 herramientas
 xix.ai
chatbot
Principales chatbots de atención al cliente con IA: Responder preguntas frecuentes y calificar prospectos 24/7
2026 Últimas chatbots de atención al cliente con IA mejor valoradas destacadas en esta lista seleccionada son las mejores soluciones para responder instantáneamente a las preguntas frecuentes de los clientes y calificar prospectos las 24 horas del día. XIX.AI ha realizado pruebas rigurosas en el mundo real para ofrecer una comparación detallada entre versión gratuita y de pago junto con clasificaciones actualizadas, ayudándote a encontrar una poderosa herramienta que cambia las reglas del juego y aumenta significativamente la productividad. Explora ahora para descubrir tu solución perfecta de chatbot con IA!
9 herramientas
xix.ai
Diseño y Arte
Generadores de guiones gráficos basados en IA para equipos creativos publicitarios
¡Los mejores generadores de storyboards con IA de 2026 para equipos creativos publicitarios! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los equipos a crear contenidos visuales impresionantes más rápidamente, gracias a pruebas en el mundo real y a rigurosas clasificaciones que se actualizan semanalmente. Disfruta de una comparación entre las opciones gratuitas y las de pago para encontrar la que mejor se adapte a tu flujo de trabajo. ¡Explora ahora mismo para sacar el máximo partido a la IA en la creación publicitaria!
8 herramientas
xix.ai
chatbot
Herramientas de Chatbot de Conocimiento de IA para Documentación Interna
¡Aquí están las mejores herramientas de chatbot de conocimiento con IA más recientes y mejor valoradas de 2026 para documentación interna en XIX.AI! Esta lista seleccionada incluye soluciones poderosas que cambian las reglas del juego y aumentan significativamente la productividad al ayudar a los equipos a generar rápidamente contenido de alta calidad, optimizar la creación de documentación y superar los desafíos comunes de redacción. Realizamos pruebas rigurosas en el mundo real y proporcionamos una comparación semanal actualizada entre versiones gratuitas y de pago, junto con clasificaciones detalladas, para ayudarte a encontrar la opción que mejor se adapte a tus necesidades. ¡Explora ahora para descubrir tu herramienta perfecta!
12 herramientas
xix.ai
Texto a voz
Mejores herramientas de IA de texto a voz: crea doblajes naturales para videos
2026 Últimas Mejores Herramientas de Texto a Voz con IA Mejor Valoradas Seleccionadas para Crear Doblajes Naturales en Videos. XIX.AI ofrece soluciones poderosas y revolucionarias que aumentan la eficiencia de escritura y te ayudan a superar los cuellos de botella en la creación. Realizamos pruebas en el mundo real, ofrecemos comparaciones entre versiones gratuitas y de pago, y actualizamos nuestras clasificaciones semanalmente. Las opciones imprescindibles se destacan basándose en evaluaciones rigurosas. Explora ahora para Descubrir tu herramienta perfecta para mejorar la calidad del video.
9 herramientas
xix.ai
Finanzas
Las mejores herramientas de detección de fraudes basadas en IA: identifica patrones sospechosos antes de que las pérdidas aumenten
Las mejores herramientas de detección de fraude mediante IA de 2026, seleccionadas por XIX.AI, ofrecen potentes soluciones revolucionarias para detectar rápidamente patrones sospechosos y evitar pérdidas costosas. Consigue una comparación entre las opciones gratuitas y de pago, pruebas en situaciones reales y clasificaciones detalladas que te ayudarán a elegir la opción imprescindible que potencie la eficacia de tu seguridad. Explora ahora para sacar el máximo partido a tu ventaja en IA.
10 herramientas
xix.ai

 comentario (0)
0/500
El ingeniero Tibo, responsable de Codex y ChatGPT en OpenAI, ha compartido una noticia en X en la que indica que la función de ventana de contexto de 1 millón de tokens del modelo GPT-5.6 Sol, integrado en Codex, ya está disponible no solo para los titulares de claves API, sino también para los usuarios de cuentas de ChatGPT. Este cambio elimina la limitación anterior que obligaba a los usuarios suscritos a recortar los historiales de proyectos a largo plazo al abordar tareas a gran escala.
Los usuarios suscritos pueden activar manualmente la configuración de contexto de un millón de tokens
Tibo explicó que GPT-5.6 Sol en Codex admite ahora una longitud de contexto de un millón de tokens, una capacidad que antes estaba reservada exclusivamente a los titulares de claves API. Señaló que la función ya se ha activado a través de las cuentas de ChatGPT y que los usuarios con planes de suscripción Plus, Pro u otros pueden configurarla manualmente para aprovechar toda la capacidad de 1,05 millones de tokens al trabajar con el agente de programación de Codex.
Una ventana de contexto más amplia permite a Codex conservar más fragmentos de código, resultados de herramientas e historial de conversaciones antes de que se active la compresión automática, lo cual resulta especialmente beneficioso para casos de uso profesional, como la reestructuración de bases de código a gran escala, la depuración compleja y las sesiones prolongadas. Para los desarrolladores que gestionan repositorios a nivel de producción, esta mejora resuelve directamente el problema anterior del agotamiento frecuente del contexto.
La configuración predeterminada se eligió cuidadosamente; habilitarla requiere una reflexión minuciosa
Tibo también destacó que la longitud predeterminada actual del contexto es el resultado de equilibrar las necesidades de rendimiento con las consideraciones de coste, y no se ha establecido de forma arbitraria. Aconsejó a los usuarios que tomaran una decisión informada basada en sus propios requisitos. Varios desarrolladores añadieron que, gracias a la tecnología de compresión del lado del servidor de Codex, la configuración predeterminada es suficiente para la mayoría de las tareas rutinarias.
No obstante, algunos usuarios han informado de que activar la configuración de contexto de un millón de tokens provoca un consumo más rápido de sus cuotas de suscripción, pudiendo una sola sesión intensiva agotar una parte significativa de su asignación semanal. Los expertos recomiendan habilitar esta función solo cuando sea necesario, en lugar de como configuración predeterminada para el uso diario, a fin de evitar alcanzar los límites de uso prematuramente en proyectos críticos.








 El Consorcio de Investigación Alemán Desvela el Modelo de IA de Código Abierto Soofi
La Asociación Alemana de Inteligencia Artificial ha lanzado oficialmente Soofi S30B-A3B, un nuevo modelo de lenguaje grande de código abierto. Este hito avanza la infraestructura de IA soberana de Europa y revitaliza el sector de código abierto con u
 La estimación de 6.400 millones de dólares de Toyota en robótica pone la IA física en el centro de atención
Toyota Motor proyecta que la implementación de la automatización en sus instalaciones de fabricación, filiales y proveedores clave podría requerir aproximadamente 400.000 robots y un gasto anual de unos 1 billón de yenes (6.400 millones de dólares) a
 Meta abre el código fuente de Muse Glimmer de 30 mil millones de parámetros para agentes de IA locales en hardware de consumo
El 10 de agosto, Meta lanzó Muse Glimmer, un modelo de código abierto diseñado para potenciar agentes de IA locales en hardware de consumo, marcando un paso clave en su estrategia de «Superinteligencia Personal». Con 30.000 millones de parámetros, es
¡Las mejores herramientas de planificación de tareas con IA mejor valoradas de 2026 para profesionales ocupados! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias y altamente eficientes que ayudan a los usuarios a optimizar los flujos de trabajo, aumentar la productividad y superar los retos diarios de planificación. Cada opción se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad. Consigue una comparación entre las versiones gratuitas y de pago y descubre la herramienta perfecta para sacar el máximo partido a la IA. ¡Explora ahora!
15 herramientas
xix.ai
2026 Últimas chatbots de atención al cliente con IA mejor valoradas destacadas en esta lista seleccionada son las mejores soluciones para responder instantáneamente a las preguntas frecuentes de los clientes y calificar prospectos las 24 horas del día. XIX.AI ha realizado pruebas rigurosas en el mundo real para ofrecer una comparación detallada entre versión gratuita y de pago junto con clasificaciones actualizadas, ayudándote a encontrar una poderosa herramienta que cambia las reglas del juego y aumenta significativamente la productividad. Explora ahora para descubrir tu solución perfecta de chatbot con IA!
9 herramientas
xix.ai
¡Los mejores generadores de storyboards con IA de 2026 para equipos creativos publicitarios! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que ayudan a los equipos a crear contenidos visuales impresionantes más rápidamente, gracias a pruebas en el mundo real y a rigurosas clasificaciones que se actualizan semanalmente. Disfruta de una comparación entre las opciones gratuitas y las de pago para encontrar la que mejor se adapte a tu flujo de trabajo. ¡Explora ahora mismo para sacar el máximo partido a la IA en la creación publicitaria!
8 herramientas
xix.ai
¡Aquí están las mejores herramientas de chatbot de conocimiento con IA más recientes y mejor valoradas de 2026 para documentación interna en XIX.AI! Esta lista seleccionada incluye soluciones poderosas que cambian las reglas del juego y aumentan significativamente la productividad al ayudar a los equipos a generar rápidamente contenido de alta calidad, optimizar la creación de documentación y superar los desafíos comunes de redacción. Realizamos pruebas rigurosas en el mundo real y proporcionamos una comparación semanal actualizada entre versiones gratuitas y de pago, junto con clasificaciones detalladas, para ayudarte a encontrar la opción que mejor se adapte a tus necesidades. ¡Explora ahora para descubrir tu herramienta perfecta!
12 herramientas
xix.ai
2026 Últimas Mejores Herramientas de Texto a Voz con IA Mejor Valoradas Seleccionadas para Crear Doblajes Naturales en Videos. XIX.AI ofrece soluciones poderosas y revolucionarias que aumentan la eficiencia de escritura y te ayudan a superar los cuellos de botella en la creación. Realizamos pruebas en el mundo real, ofrecemos comparaciones entre versiones gratuitas y de pago, y actualizamos nuestras clasificaciones semanalmente. Las opciones imprescindibles se destacan basándose en evaluaciones rigurosas. Explora ahora para Descubrir tu herramienta perfecta para mejorar la calidad del video.
9 herramientas
xix.ai
Las mejores herramientas de detección de fraude mediante IA de 2026, seleccionadas por XIX.AI, ofrecen potentes soluciones revolucionarias para detectar rápidamente patrones sospechosos y evitar pérdidas costosas. Consigue una comparación entre las opciones gratuitas y de pago, pruebas en situaciones reales y clasificaciones detalladas que te ayudarán a elegir la opción imprescindible que potencie la eficacia de tu seguridad. Explora ahora para sacar el máximo partido a tu ventaja en IA.
10 herramientas
xix.ai












