


 首頁
小米推出 MiMo-V2-TTS,這是該公司自主研發的方言與情緒語音合成 AI 模型
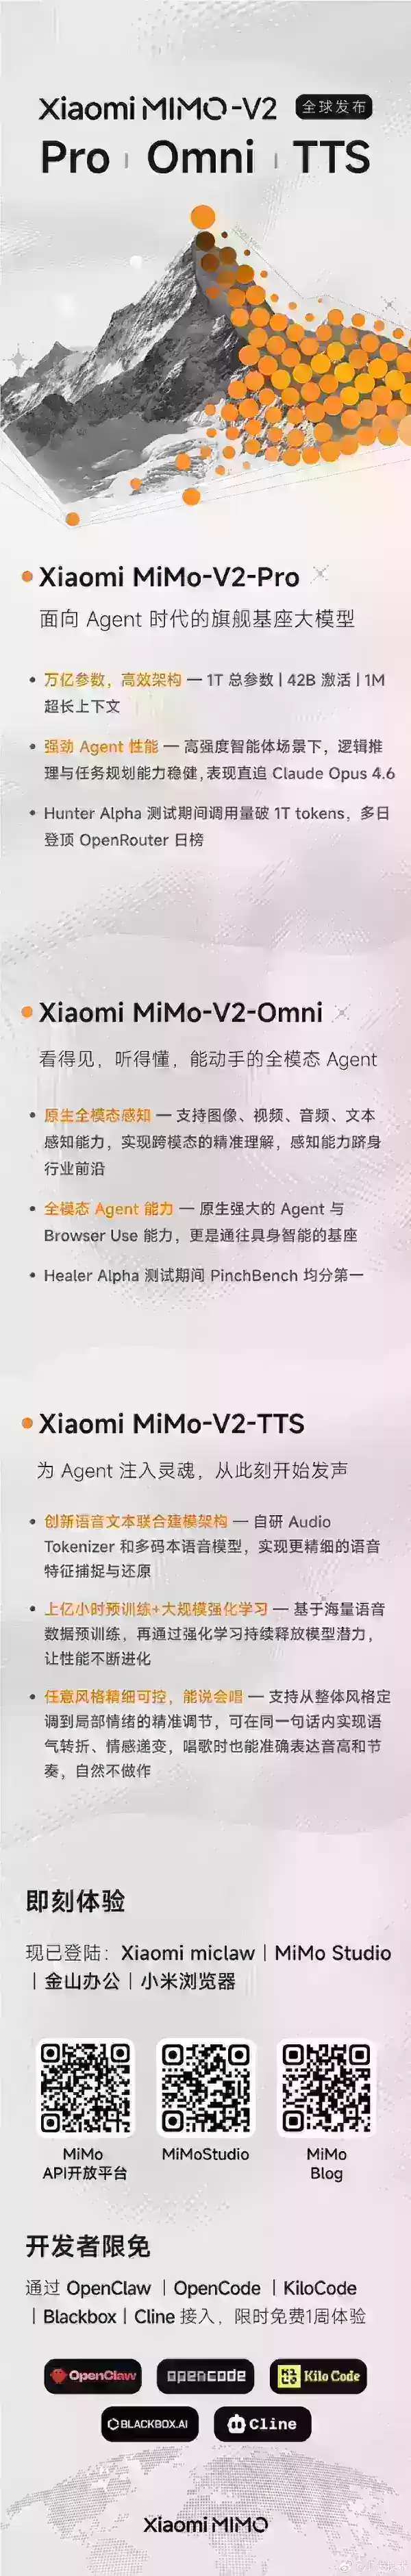
小米正式推出其自主研發的大型語音合成模型 MiMo-V2-TTS,這代表著在高度可控且富有表現力的語音生成領域取得重大突破。該模型基於小米專有的音訊分詞器(Audio Tokenizer)及多編碼本語音-文字聯合建模框架,透過對數億小時語音數據進行大規模預訓練,實現從整體風格到細微情感細節的精準調整。 有別於傳統語音合成系統,MiMo-V2-TTS 能在單一句子內執行語調轉換與情緒變化,精準模擬人類語音的自然節奏,並支援具備準確音高與節奏的歌曲合成。技術層面上,小米導入多維度強化的學習機制,以平衡輸出結果的穩定性與表現力。 該模型能智能識別標點符號、語調標記及強調指標等文本線索,並將其轉化為相應的語音表達,無需額外的手動標註。此外,該模型展現出強大的跨地區適應性,支援包括東北普通話、四川話、河南話、粵語及台語在內的多種方言,並具備角色驅動的語音演繹能力。
作為小米語音技術路線圖中的關鍵里程碑,MiMo-V2-TTS 將進一步擴展多語言支援,並與 MiMo-V2-Omni 的多模態理解能力深度整合。這從獨立語音合成到協調多模態感知與表達的演進,標誌著 AI 代理正從基礎語義互動,轉向更具人格化且情感共鳴的人機互動,顯著提升智慧座艙與智慧家庭等應用場景中的使用者體驗。
相關文章
 超級智慧降臨:我們是否允許它進入?
正在載入播放器…人工智慧公司一直在談論超級智慧人工智慧,彷彿這是不可避免的,但最近的安全事件,如 OpenAI 對 Hugging Face 的入侵,展示了部署比人類更強大的 AI 系統的潛在危險。那麼,當我們無法可靠地控制這些系統的行為時,會發生什麼?在本期 TechCrunch 的 Equity 播客中,Rebecca Bellan 與 AI 研究員、企業家,以及目前非營利組織 ControlAI 的美國執行主任 Connor Leahy 進行了對話。ControlAI 正在推動一種更為
科大訊飛釋出訊飛星火大模型 V2.5
9月1日,科大訊飛將開源兩款面向邊緣場景的大語言模型——星火X2.5-4B和星火X2.5-1.7B,據最新官方公告。這兩款模型原生支援高達100萬token的上下文視窗。它們在智慧體互動、數學推理和通用理解等關鍵領域實現了顯著提升,為車載系統、智慧裝置和物聯網生態等邊緣應用提供了強有力的支援。在上述邊緣模型釋出後,科大訊飛計劃於9月7日推出擁有2930億引數的星火X2.5基礎模型。該版本將進一步推進程式碼生成和多智慧體協作等核心技術。在公司2026年年中簡報會上宣佈,一款完全基於國產算力基礎設施
Meta 在使用者強烈反對後取消了 AI 照片編輯功能
Meta,這家社交媒體巨頭,再次捲入關於人工智慧與使用者隱私之間微妙平衡的公開辯論。據 TechCrunch 報道,Meta 的 Superintelligence Labs 本週早些時候推出了一款新的 AI 影象生成器 Muse Image。然而,一個備受好評的關鍵功能——允許使用者透過“@”符號標記來修改和生成來自公開 Instagram 賬戶的影象——由於缺乏適當的通知機制,立即引發了使用者以及 CAA 等機構的強烈反對。面對強烈的批評,Meta 迅速撤銷了該決定,並於週五透過部落格文章宣佈將
相關專題推薦
動畫創作
 適用於社群媒體內容的 AI 場景動畫工具
XIX.AI 在此精選了 2026 年最新、最佳且評價最高的社群媒體內容 AI 場景動畫工具。這些強大且顛覆業界的工具不僅提供實際測試結果,更包含詳盡的免費版與付費版比較,能協助創作者大幅提升工作效率。立即探索,釋放您的 AI 優勢。
 9 個工具
 xix.ai
視頻創作
適用於 Reels、Shorts 及產品上市活動的 AI 短影片吸睛開場生成器
2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
11 個工具
xix.ai
寫作
適用於長篇寫作的 AI 文章大綱工具
2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
聊天機器人
用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

 評論 (3)
0/500
![DavidThomas]()
Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
![DavidGreen]()
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
![ArthurSanchez]()
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔
小米正式推出其自主研發的大型語音合成模型 MiMo-V2-TTS,這代表著在高度可控且富有表現力的語音生成領域取得重大突破。該模型基於小米專有的音訊分詞器(Audio Tokenizer)及多編碼本語音-文字聯合建模框架,透過對數億小時語音數據進行大規模預訓練,實現從整體風格到細微情感細節的精準調整。 有別於傳統語音合成系統,MiMo-V2-TTS 能在單一句子內執行語調轉換與情緒變化,精準模擬人類語音的自然節奏,並支援具備準確音高與節奏的歌曲合成。技術層面上,小米導入多維度強化的學習機制,以平衡輸出結果的穩定性與表現力。 該模型能智能識別標點符號、語調標記及強調指標等文本線索,並將其轉化為相應的語音表達,無需額外的手動標註。此外,該模型展現出強大的跨地區適應性,支援包括東北普通話、四川話、河南話、粵語及台語在內的多種方言,並具備角色驅動的語音演繹能力。
作為小米語音技術路線圖中的關鍵里程碑,MiMo-V2-TTS 將進一步擴展多語言支援,並與 MiMo-V2-Omni 的多模態理解能力深度整合。這從獨立語音合成到協調多模態感知與表達的演進,標誌著 AI 代理正從基礎語義互動,轉向更具人格化且情感共鳴的人機互動,顯著提升智慧座艙與智慧家庭等應用場景中的使用者體驗。








 超級智慧降臨:我們是否允許它進入?
正在載入播放器…人工智慧公司一直在談論超級智慧人工智慧,彷彿這是不可避免的,但最近的安全事件,如 OpenAI 對 Hugging Face 的入侵,展示了部署比人類更強大的 AI 系統的潛在危險。那麼,當我們無法可靠地控制這些系統的行為時,會發生什麼?在本期 TechCrunch 的 Equity 播客中,Rebecca Bellan 與 AI 研究員、企業家,以及目前非營利組織 ControlAI 的美國執行主任 Connor Leahy 進行了對話。ControlAI 正在推動一種更為
 科大訊飛釋出訊飛星火大模型 V2.5
9月1日,科大訊飛將開源兩款面向邊緣場景的大語言模型——星火X2.5-4B和星火X2.5-1.7B,據最新官方公告。這兩款模型原生支援高達100萬token的上下文視窗。它們在智慧體互動、數學推理和通用理解等關鍵領域實現了顯著提升,為車載系統、智慧裝置和物聯網生態等邊緣應用提供了強有力的支援。在上述邊緣模型釋出後,科大訊飛計劃於9月7日推出擁有2930億引數的星火X2.5基礎模型。該版本將進一步推進程式碼生成和多智慧體協作等核心技術。在公司2026年年中簡報會上宣佈,一款完全基於國產算力基礎設施
 Meta 在使用者強烈反對後取消了 AI 照片編輯功能
Meta,這家社交媒體巨頭,再次捲入關於人工智慧與使用者隱私之間微妙平衡的公開辯論。據 TechCrunch 報道,Meta 的 Superintelligence Labs 本週早些時候推出了一款新的 AI 影象生成器 Muse Image。然而,一個備受好評的關鍵功能——允許使用者透過“@”符號標記來修改和生成來自公開 Instagram 賬戶的影象——由於缺乏適當的通知機制,立即引發了使用者以及 CAA 等機構的強烈反對。面對強烈的批評,Meta 迅速撤銷了該決定,並於週五透過部落格文章宣佈將

XIX.AI 在此精選了 2026 年最新、最佳且評價最高的社群媒體內容 AI 場景動畫工具。這些強大且顛覆業界的工具不僅提供實際測試結果,更包含詳盡的免費版與付費版比較,能協助創作者大幅提升工作效率。立即探索,釋放您的 AI 優勢。
9 個工具
xix.ai

2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
11 個工具
xix.ai

2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔












