


 Heim
Xiaomi stellt MiMo-V2-TTS vor, sein selbst entwickeltes KI-Modell für die Synthese von Dialekt- und emotionsbasierten Stimmen
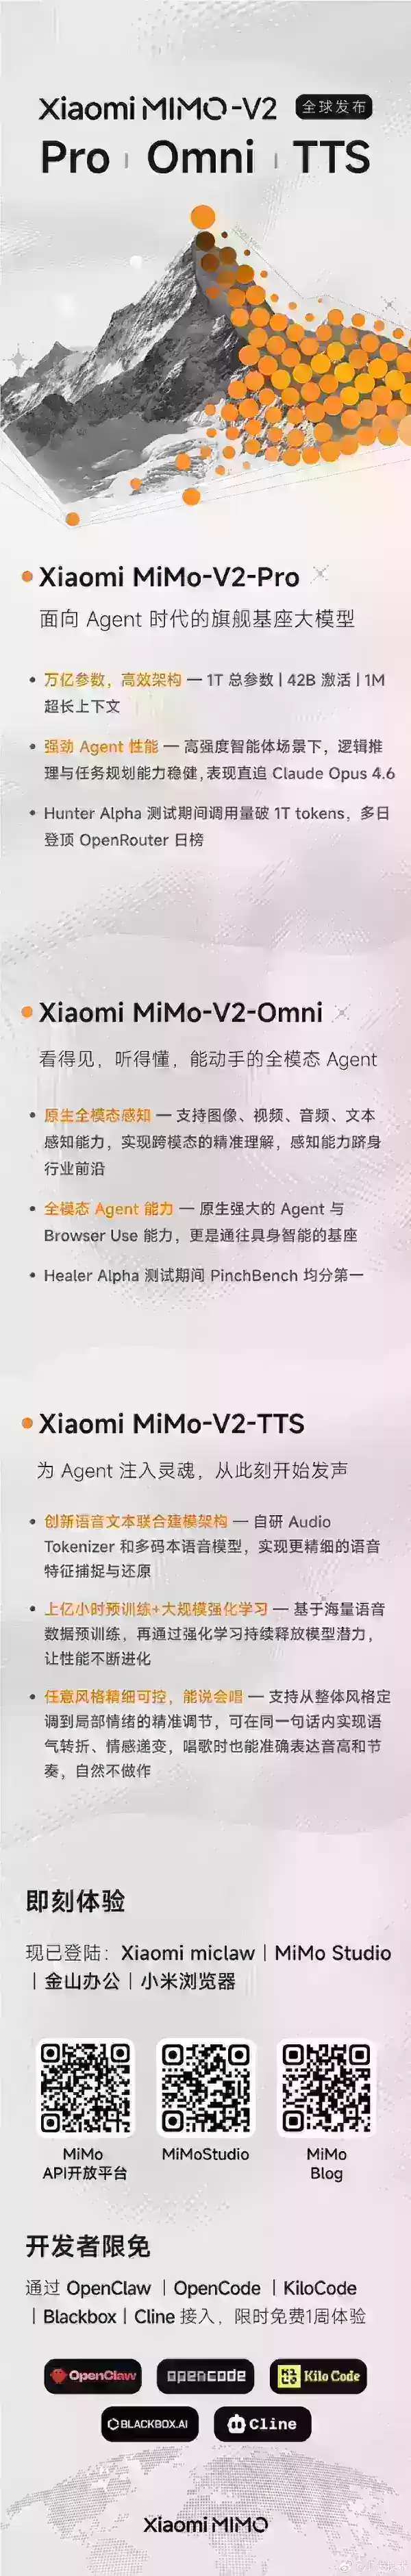
Xiaomi hat sein selbst entwickeltes groß angelegtes Sprachsynthese-Modell „MiMo-V2-TTS“ offiziell vorgestellt, das einen bedeutenden Fortschritt bei der hochgradig steuerbaren und ausdrucksstarken Stimmgenerierung darstellt. Das Modell basiert auf Xiaomis firmeneigenem „Audio Tokenizer“ und einem Multi-Codebook-Framework zur gemeinsamen Modellierung von Sprache und Text. Es nutzt ein umfangreiches Vortraining mit Hunderten von Millionen Stunden Sprachdaten, um präzise Anpassungen zu erzielen – vom allgemeinen Stil bis hin zu nuancierten emotionalen Details. Im Gegensatz zu herkömmlichen TTS-Systemen kann MiMo-V2-TTS Tonfallwechsel und emotionale Variationen innerhalb eines einzigen Satzes ausführen, wodurch es den natürlichen Rhythmus der menschlichen Sprache genau nachahmt und die Gesangs-Synthese mit präziser Tonhöhe und Rhythmus unterstützt. Technisch hat Xiaomi mehrdimensionales bestärkendes Lernen integriert, um die Stabilität und Ausdruckskraft der Ausgabe auszugleichen. Das Modell erkennt intelligent textuelle Hinweise wie Interpunktion, Intonationsmarker und Betonungsindikatoren und übersetzt diese in angemessene stimmliche Ausdrucksformen, ohne dass zusätzliche manuelle Annotationen erforderlich sind. Darüber hinaus weist das Modell eine starke regionenübergreifende Anpassungsfähigkeit auf, unterstützt mehrere Dialekte, darunter nordöstliches Mandarin, Sichuanesisch, Henanesisch, Kantonesisch und taiwanesische Akzente, und ist zu charakterorientierten Stimmdarbietungen fähig.
Als wichtiger Meilenstein in Xiaomis Roadmap für Sprachtechnologie wird MiMo-V2-TTS die mehrsprachige Unterstützung weiter ausbauen und sich tief in die multimodalen Verständnisfähigkeiten von MiMo-V2-Omni integrieren. Dieser Fortschritt von der eigenständigen Sprachsynthese hin zu koordinierter multimodaler Wahrnehmung und Ausdruck signalisiert einen Wandel bei KI-Agenten von grundlegender semantischer Interaktion hin zu einer persönlicheren und emotional ansprechenderen Mensch-Computer-Interaktion, was das Nutzererlebnis in Anwendungen wie Smart Cabins und Smart Homes erheblich verbessert.
Verwandter Artikel
 Der ehemalige OpenAI-Chefwissenschaftler Ilya stellt sein SSI vor und enthüllt das erste Modell
Die KI hat einen weiteren großen Meilenstein erreicht. Nach seinem Ausscheiden aus OpenAI gründete der ehemalige Chefwissenschaftler Ilya Sutskever Safe Superintelligence Inc. (SSI), die kürzlich Details zu ihrem ersten Modell enthüllt hat. Berichten
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Am 14. Mai 2026 gab die KI-Anwendungsentwicklungsplattform Lovable bekannt, dass sie an der 800.000-US-Dollar-Seed-Finanzierungsrunde des dänischen Hardware-Startups Atech beteiligt ist. Angeführt von Lovable zog die Runde erstklassige Wagniskapitalf
Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn
Empfehlungen zu verwandten Spezialthemen
Chatbot
 Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
 12 Tools
 xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai
Design & Kunst
Die besten KI-gestützten Kreativwerkzeuge für Künstler: Den Durchbruch durch visuelle Blockaden
2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai

 Kommentare (3)
![DavidThomas]()
Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
![DavidGreen]()
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
![ArthurSanchez]()
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔
Xiaomi hat sein selbst entwickeltes groß angelegtes Sprachsynthese-Modell „MiMo-V2-TTS“ offiziell vorgestellt, das einen bedeutenden Fortschritt bei der hochgradig steuerbaren und ausdrucksstarken Stimmgenerierung darstellt. Das Modell basiert auf Xiaomis firmeneigenem „Audio Tokenizer“ und einem Multi-Codebook-Framework zur gemeinsamen Modellierung von Sprache und Text. Es nutzt ein umfangreiches Vortraining mit Hunderten von Millionen Stunden Sprachdaten, um präzise Anpassungen zu erzielen – vom allgemeinen Stil bis hin zu nuancierten emotionalen Details. Im Gegensatz zu herkömmlichen TTS-Systemen kann MiMo-V2-TTS Tonfallwechsel und emotionale Variationen innerhalb eines einzigen Satzes ausführen, wodurch es den natürlichen Rhythmus der menschlichen Sprache genau nachahmt und die Gesangs-Synthese mit präziser Tonhöhe und Rhythmus unterstützt. Technisch hat Xiaomi mehrdimensionales bestärkendes Lernen integriert, um die Stabilität und Ausdruckskraft der Ausgabe auszugleichen. Das Modell erkennt intelligent textuelle Hinweise wie Interpunktion, Intonationsmarker und Betonungsindikatoren und übersetzt diese in angemessene stimmliche Ausdrucksformen, ohne dass zusätzliche manuelle Annotationen erforderlich sind. Darüber hinaus weist das Modell eine starke regionenübergreifende Anpassungsfähigkeit auf, unterstützt mehrere Dialekte, darunter nordöstliches Mandarin, Sichuanesisch, Henanesisch, Kantonesisch und taiwanesische Akzente, und ist zu charakterorientierten Stimmdarbietungen fähig.
Als wichtiger Meilenstein in Xiaomis Roadmap für Sprachtechnologie wird MiMo-V2-TTS die mehrsprachige Unterstützung weiter ausbauen und sich tief in die multimodalen Verständnisfähigkeiten von MiMo-V2-Omni integrieren. Dieser Fortschritt von der eigenständigen Sprachsynthese hin zu koordinierter multimodaler Wahrnehmung und Ausdruck signalisiert einen Wandel bei KI-Agenten von grundlegender semantischer Interaktion hin zu einer persönlicheren und emotional ansprechenderen Mensch-Computer-Interaktion, was das Nutzererlebnis in Anwendungen wie Smart Cabins und Smart Homes erheblich verbessert.








 Der ehemalige OpenAI-Chefwissenschaftler Ilya stellt sein SSI vor und enthüllt das erste Modell
Die KI hat einen weiteren großen Meilenstein erreicht. Nach seinem Ausscheiden aus OpenAI gründete der ehemalige Chefwissenschaftler Ilya Sutskever Safe Superintelligence Inc. (SSI), die kürzlich Details zu ihrem ersten Modell enthüllt hat. Berichten
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Am 14. Mai 2026 gab die KI-Anwendungsentwicklungsplattform Lovable bekannt, dass sie an der 800.000-US-Dollar-Seed-Finanzierungsrunde des dänischen Hardware-Startups Atech beteiligt ist. Angeführt von Lovable zog die Runde erstklassige Wagniskapitalf
 Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai

Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔












