


 Maison
Xiaomi dévoile MiMo-V2-TTS, son modèle d'IA développé en interne pour la synthèse vocale tenant compte des dialectes et des émotions
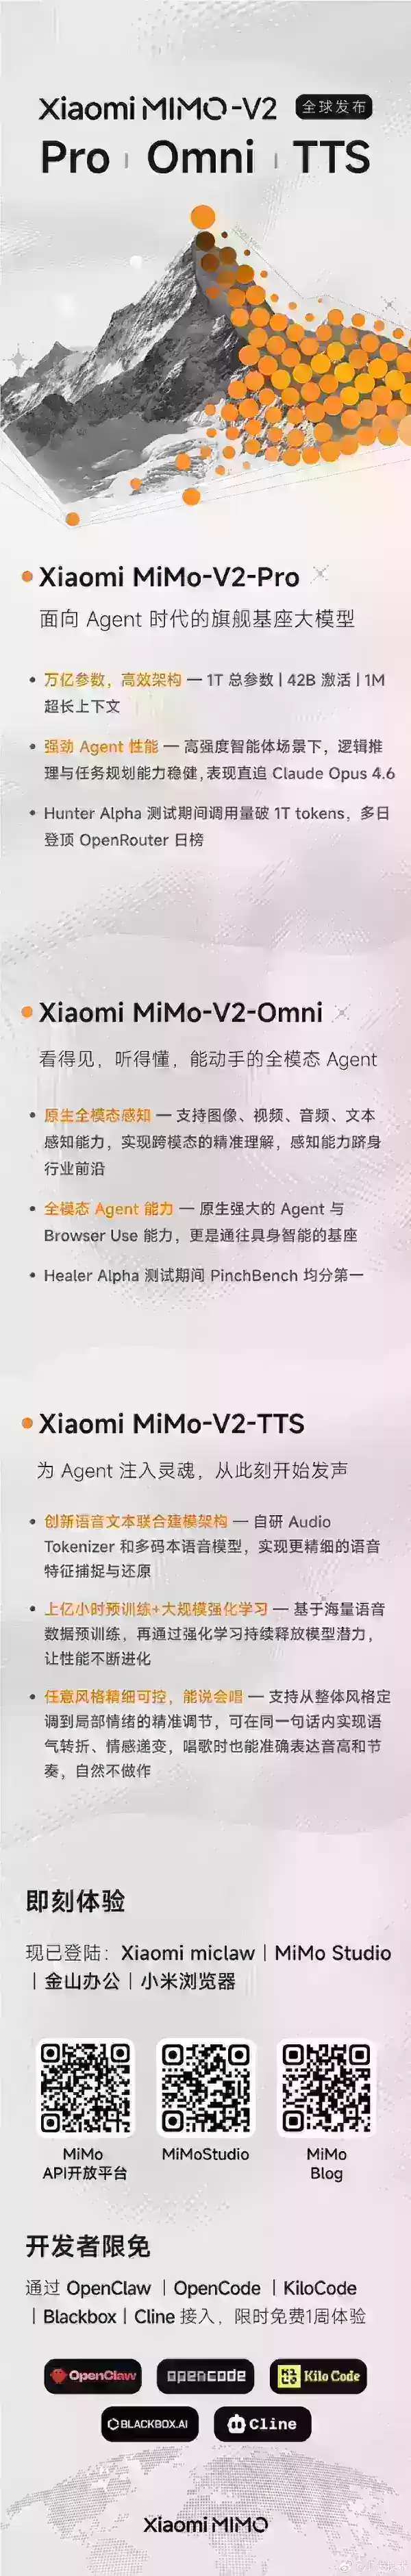
Xiaomi a officiellement lancé son modèle de synthèse vocale à grande échelle développé en interne, MiMo-V2-TTS, qui représente une avancée majeure en matière de génération vocale hautement contrôlable et expressive. S'appuyant sur l'Audio Tokenizer propriétaire de Xiaomi et sur un cadre de modélisation conjointe parole-texte à livres de codes multiples, ce modèle tire parti d'un pré-entraînement intensif sur des centaines de millions d'heures de données vocales pour permettre des ajustements précis, allant du style général aux nuances émotionnelles les plus subtiles. Contrairement aux systèmes TTS conventionnels, MiMo-V2-TTS est capable d'effectuer des changements de ton et des variations émotionnelles au sein d'une même phrase, imitant ainsi de près le rythme naturel de la parole humaine et prenant en charge la synthèse de chansons avec une hauteur et un rythme précis. Sur le plan technique, Xiaomi a intégré un apprentissage par renforcement multidimensionnel afin d'équilibrer la stabilité et l'expressivité du résultat. Le modèle reconnaît intelligemment les indices textuels tels que la ponctuation, les marqueurs d'intonation et les indicateurs d'accentuation, les traduisant en expressions vocales appropriées sans nécessiter d'annotation manuelle supplémentaire. De plus, le modèle fait preuve d'une forte adaptabilité interrégionale, prenant en charge de multiples dialectes, notamment le mandarin du nord-est, le sichuanais, le henanais, le cantonais et les accents taïwanais, et est capable de performances vocales adaptées à chaque personnage.
Étape clé de la feuille de route technologique vocale de Xiaomi, MiMo-V2-TTS élargira encore la prise en charge multilingue et s'intégrera étroitement aux capacités de compréhension multimodale de MiMo-V2-Omni. Cette évolution, de la synthèse vocale autonome vers une perception et une expression multimodales coordonnées, marque un tournant pour les agents IA : ils passent d'une interaction sémantique basique à une interaction homme-machine plus personnalisée et plus riche en émotions, améliorant considérablement l'expérience utilisateur dans des applications telles que les cabines intelligentes et les maisons connectées.
Article connexe
 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (3)
![DavidThomas]()
Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
![DavidGreen]()
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
![ArthurSanchez]()
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔
Xiaomi a officiellement lancé son modèle de synthèse vocale à grande échelle développé en interne, MiMo-V2-TTS, qui représente une avancée majeure en matière de génération vocale hautement contrôlable et expressive. S'appuyant sur l'Audio Tokenizer propriétaire de Xiaomi et sur un cadre de modélisation conjointe parole-texte à livres de codes multiples, ce modèle tire parti d'un pré-entraînement intensif sur des centaines de millions d'heures de données vocales pour permettre des ajustements précis, allant du style général aux nuances émotionnelles les plus subtiles. Contrairement aux systèmes TTS conventionnels, MiMo-V2-TTS est capable d'effectuer des changements de ton et des variations émotionnelles au sein d'une même phrase, imitant ainsi de près le rythme naturel de la parole humaine et prenant en charge la synthèse de chansons avec une hauteur et un rythme précis. Sur le plan technique, Xiaomi a intégré un apprentissage par renforcement multidimensionnel afin d'équilibrer la stabilité et l'expressivité du résultat. Le modèle reconnaît intelligemment les indices textuels tels que la ponctuation, les marqueurs d'intonation et les indicateurs d'accentuation, les traduisant en expressions vocales appropriées sans nécessiter d'annotation manuelle supplémentaire. De plus, le modèle fait preuve d'une forte adaptabilité interrégionale, prenant en charge de multiples dialectes, notamment le mandarin du nord-est, le sichuanais, le henanais, le cantonais et les accents taïwanais, et est capable de performances vocales adaptées à chaque personnage.
Étape clé de la feuille de route technologique vocale de Xiaomi, MiMo-V2-TTS élargira encore la prise en charge multilingue et s'intégrera étroitement aux capacités de compréhension multimodale de MiMo-V2-Omni. Cette évolution, de la synthèse vocale autonome vers une perception et une expression multimodales coordonnées, marque un tournant pour les agents IA : ils passent d'une interaction sémantique basique à une interaction homme-machine plus personnalisée et plus riche en émotions, améliorant considérablement l'expérience utilisateur dans des applications telles que les cabines intelligentes et les maisons connectées.








 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
 Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
 Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔












