


 Hogar
Xiaomi presenta MiMo-V2-TTS, su modelo de IA de desarrollo propio para la síntesis de voz con dialectos y emociones
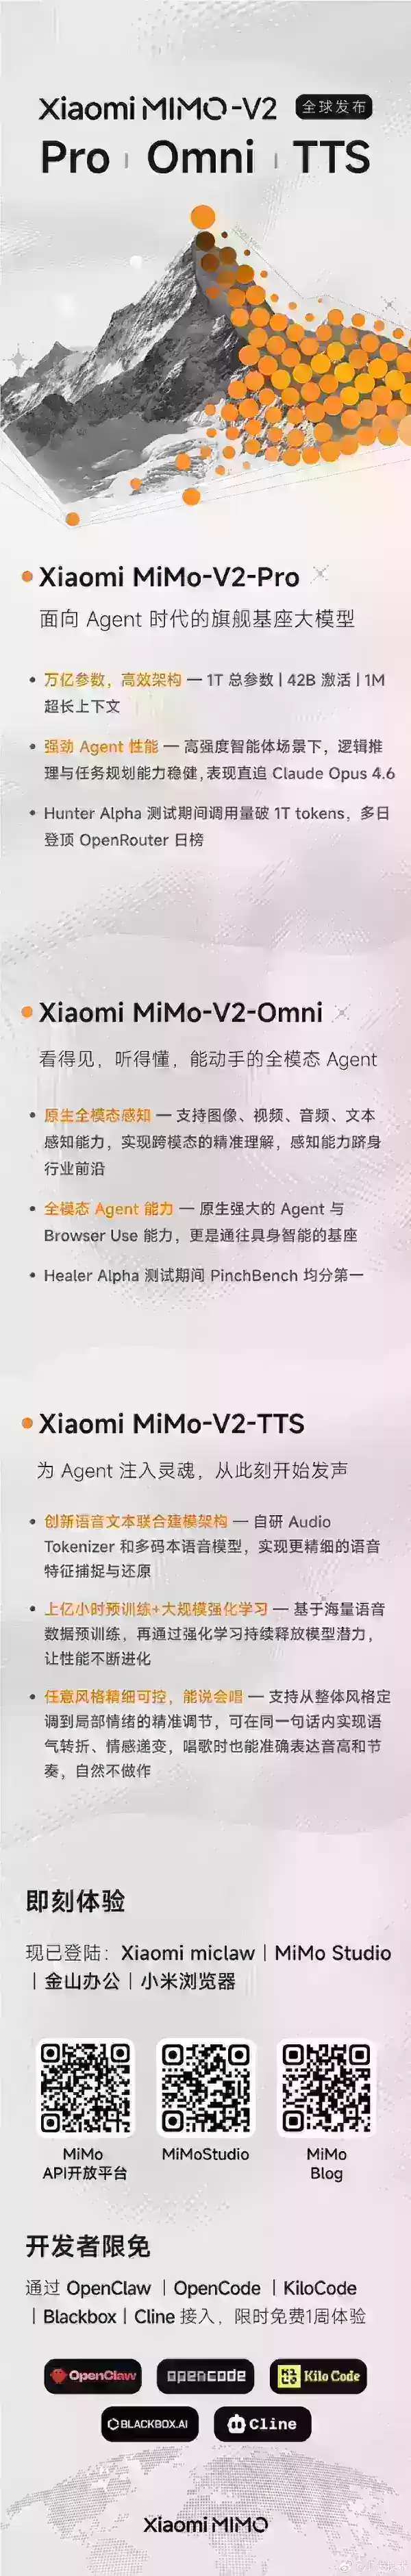
Xiaomi ha lanzado oficialmente su modelo de síntesis de voz a gran escala desarrollado internamente, MiMo-V2-TTS, que supone un gran avance en la generación de voces altamente controlables y expresivas. Basado en el «Audio Tokenizer» patentado por Xiaomi y en un marco de modelado conjunto de voz y texto con múltiples libros de códigos, el modelo aprovecha un extenso entrenamiento previo con cientos de millones de horas de datos de voz para lograr ajustes precisos, desde el estilo general hasta los matices emocionales más sutiles. A diferencia de los sistemas TTS convencionales, MiMo-V2-TTS puede ejecutar cambios de tono y variaciones emocionales dentro de una misma frase, imitando fielmente el ritmo natural del habla humana y permitiendo la síntesis de canciones con un tono y un ritmo precisos. Técnicamente, Xiaomi ha incorporado el aprendizaje por refuerzo multidimensional para equilibrar la estabilidad y la expresividad de la salida. El modelo reconoce de forma inteligente señales textuales como la puntuación, los marcadores de entonación y los indicadores de énfasis, traduciéndolos en expresiones vocales adecuadas sin necesidad de anotaciones manuales adicionales. Además, el modelo muestra una gran adaptabilidad interregional, admitiendo múltiples dialectos, incluidos el mandarín del noreste, el de Sichuan, el de Henan, el cantonés y los acentos taiwaneses, y es capaz de realizar interpretaciones vocales basadas en los personajes.
Como hito clave en la hoja de ruta de la tecnología de voz de Xiaomi, MiMo-V2-TTS ampliará aún más la compatibilidad multilingüe y se integrará profundamente con las capacidades de comprensión multimodal de MiMo-V2-Omni. Esta evolución desde la síntesis de voz independiente hacia la percepción y expresión multimodal coordinada marca un cambio en los agentes de IA, pasando de la interacción semántica básica a una interacción persona-ordenador más personal y con mayor resonancia emocional, lo que mejora significativamente la experiencia del usuario en aplicaciones como cabinas inteligentes y hogares inteligentes.
Artículo relacionado
 Stripe adquirirá OpenRouter a medida que el enrutamiento basado en modelos de IA cobra impulso
Stripe ha acordado adquirir OpenRouter, una plataforma de enrutamiento de modelos de IA que ofrece a los desarrolladores acceso a cientos de modelos a través de una única interfaz. El acuerdo amplía e
El exinvestigador de OpenAI, Barrett Zoph, regresa a Google para colaborar en el desarrollo de Gemini
Barret Zoph, que anteriormente abandonó de forma repentina la empresa para incorporarse a OpenAI debido a un desacuerdo con la directora general de Thinking Machines Lab, Miriam Mularati, ha vuelto a
Cómo Recursive Intelligence recaudó 335 millones de dólares con una valoración de 4.000 millones de dólares en cuatro meses
Las cofundadoras de la startup Ricursive Intelligence parecían destinadas a ser cofundadoras.Anna Goldie, directora ejecutiva, y Azalia Mirhoseini, directora técnica, son tan conocidas en la comunidad
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (3)
0/500
![DavidThomas]()
Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
![DavidGreen]()
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
![ArthurSanchez]()
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔
Xiaomi ha lanzado oficialmente su modelo de síntesis de voz a gran escala desarrollado internamente, MiMo-V2-TTS, que supone un gran avance en la generación de voces altamente controlables y expresivas. Basado en el «Audio Tokenizer» patentado por Xiaomi y en un marco de modelado conjunto de voz y texto con múltiples libros de códigos, el modelo aprovecha un extenso entrenamiento previo con cientos de millones de horas de datos de voz para lograr ajustes precisos, desde el estilo general hasta los matices emocionales más sutiles. A diferencia de los sistemas TTS convencionales, MiMo-V2-TTS puede ejecutar cambios de tono y variaciones emocionales dentro de una misma frase, imitando fielmente el ritmo natural del habla humana y permitiendo la síntesis de canciones con un tono y un ritmo precisos. Técnicamente, Xiaomi ha incorporado el aprendizaje por refuerzo multidimensional para equilibrar la estabilidad y la expresividad de la salida. El modelo reconoce de forma inteligente señales textuales como la puntuación, los marcadores de entonación y los indicadores de énfasis, traduciéndolos en expresiones vocales adecuadas sin necesidad de anotaciones manuales adicionales. Además, el modelo muestra una gran adaptabilidad interregional, admitiendo múltiples dialectos, incluidos el mandarín del noreste, el de Sichuan, el de Henan, el cantonés y los acentos taiwaneses, y es capaz de realizar interpretaciones vocales basadas en los personajes.
Como hito clave en la hoja de ruta de la tecnología de voz de Xiaomi, MiMo-V2-TTS ampliará aún más la compatibilidad multilingüe y se integrará profundamente con las capacidades de comprensión multimodal de MiMo-V2-Omni. Esta evolución desde la síntesis de voz independiente hacia la percepción y expresión multimodal coordinada marca un cambio en los agentes de IA, pasando de la interacción semántica básica a una interacción persona-ordenador más personal y con mayor resonancia emocional, lo que mejora significativamente la experiencia del usuario en aplicaciones como cabinas inteligentes y hogares inteligentes.








 Stripe adquirirá OpenRouter a medida que el enrutamiento basado en modelos de IA cobra impulso
Stripe ha acordado adquirir OpenRouter, una plataforma de enrutamiento de modelos de IA que ofrece a los desarrolladores acceso a cientos de modelos a través de una única interfaz. El acuerdo amplía e
 El exinvestigador de OpenAI, Barrett Zoph, regresa a Google para colaborar en el desarrollo de Gemini
Barret Zoph, que anteriormente abandonó de forma repentina la empresa para incorporarse a OpenAI debido a un desacuerdo con la directora general de Thinking Machines Lab, Miriam Mularati, ha vuelto a
 Cómo Recursive Intelligence recaudó 335 millones de dólares con una valoración de 4.000 millones de dólares en cuatro meses
Las cofundadoras de la startup Ricursive Intelligence parecían destinadas a ser cofundadoras.Anna Goldie, directora ejecutiva, y Azalia Mirhoseini, directora técnica, son tan conocidas en la comunidad

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔












