


 Дом
Xiaomi представила MiMo-V2-TTS — собственную модель искусственного интеллекта для синтеза речи с учетом диалектов и эмоций
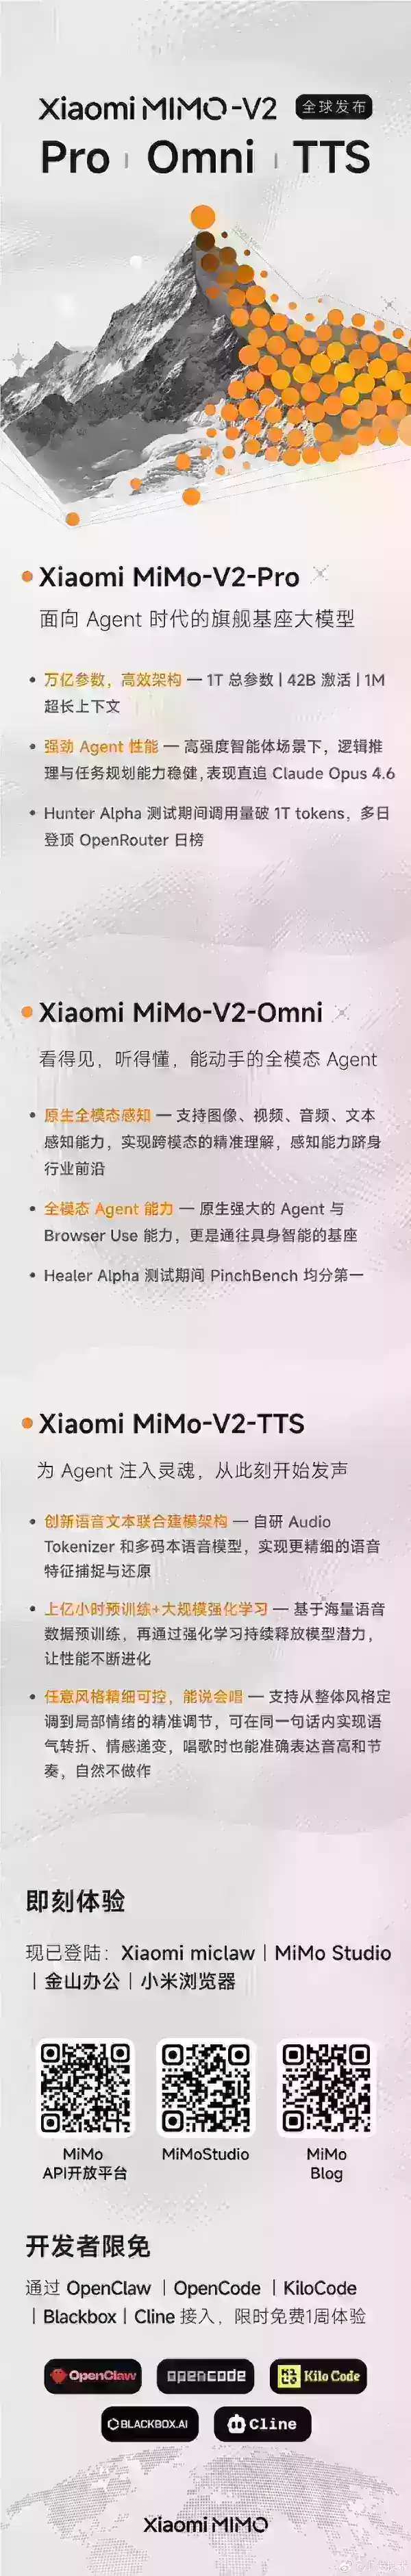
Компания Xiaomi официально представила разработанную собственными силами крупномасштабную модель синтеза речи MiMo-V2-TTS, которая стала значительным прорывом в области создания высококонтролируемого и выразительного голоса. Основанная на запатентованном Xiaomi алгоритме Audio Tokenizer и платформе совместного моделирования речи и текста с использованием нескольких кодовых книг, модель использует обширные данные предварительного обучения, охватывающие сотни миллионов часов речевых данных, для обеспечения точной настройки — от общего стиля до тонких эмоциональных нюансов. В отличие от традиционных систем TTS, MiMo-V2-TTS может выполнять смену тона и эмоциональные вариации в пределах одного предложения, точно имитируя естественный ритм человеческой речи и поддерживая синтез песен с точной высотой и ритмом. С технической точки зрения, Xiaomi внедрила многомерное обучение с подкреплением для баланса стабильности и выразительности результата. Модель интеллектуально распознает текстовые подсказки, такие как пунктуация, интонационные маркеры и индикаторы ударения, преобразуя их в соответствующие голосовые выражения без необходимости дополнительных ручных аннотаций. Кроме того, модель демонстрирует высокую межрегиональную адаптивность, поддерживая множество диалектов, включая северо-восточный мандаринский, сычуаньский, хэнаньский, кантонский и тайваньский акценты, а также способна к голосовому исполнению с учетом персонажа.
Являясь ключевой вехой в дорожной карте голосовых технологий Xiaomi, MiMo-V2-TTS будет и дальше расширять многоязычную поддержку и глубоко интегрироваться с мультимодальными возможностями понимания MiMo-V2-Omni. Этот переход от автономного синтеза речи к скоординированному мультимодальному восприятию и выражению сигнализирует о сдвиге в развитии ИИ-агентов от базового семантического взаимодействия к более личностному и эмоционально резонирующему человеко-компьютерному взаимодействию, что значительно улучшает пользовательский опыт в таких приложениях, как «умные» салоны автомобилей и «умные» дома.
Связанная статья
 Бывший главный научный сотрудник OpenAI Илья представляет SSI и раскрывает первую модель
Искусственный интеллект достиг еще одной важной вехи. После своего ухода из OpenAI бывший главный научный сотрудник Илья Сутскер основал компанию Safe Superintelligence Inc. (SSI), которая недавно раскрыла детали своей первой модели. Сообщения в зару
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
14 мая 2026 года платформа разработки приложений на базе искусственного интеллекта Lovable объявила о своем участии в раундеSeed-финансирования на сумму $800 000 для датского стартапа в области аппаратного обеспечения Atech. При ведущем участии Lovab
Anthropic расширяет инструменты для программирования Claude AI в Японии в рамках стратегии роста за рубежом
Anthropic, prominent U.S. artificial intelligence firm, is intensifying its global outreach. On Wednesday, the company hosted a major developer gathering, "Code with Claude," in Tokyo, drawing close to 500 software engineers. This initiative seeks to
Рекомендации по связанным специальным темам
чат-бот
 Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
 12 инструментов
 xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai
Анализ данных
Лучшие инструменты для очистки данных с использованием ИИ: быстрое устранение пропущенных значений и дубликатов
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для творческого мышления на основе ИИ для художников: преодоление визуальных блоков
В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai

 Комментарии (3)
![DavidThomas]()
Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
![DavidGreen]()
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
![ArthurSanchez]()
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔
Компания Xiaomi официально представила разработанную собственными силами крупномасштабную модель синтеза речи MiMo-V2-TTS, которая стала значительным прорывом в области создания высококонтролируемого и выразительного голоса. Основанная на запатентованном Xiaomi алгоритме Audio Tokenizer и платформе совместного моделирования речи и текста с использованием нескольких кодовых книг, модель использует обширные данные предварительного обучения, охватывающие сотни миллионов часов речевых данных, для обеспечения точной настройки — от общего стиля до тонких эмоциональных нюансов. В отличие от традиционных систем TTS, MiMo-V2-TTS может выполнять смену тона и эмоциональные вариации в пределах одного предложения, точно имитируя естественный ритм человеческой речи и поддерживая синтез песен с точной высотой и ритмом. С технической точки зрения, Xiaomi внедрила многомерное обучение с подкреплением для баланса стабильности и выразительности результата. Модель интеллектуально распознает текстовые подсказки, такие как пунктуация, интонационные маркеры и индикаторы ударения, преобразуя их в соответствующие голосовые выражения без необходимости дополнительных ручных аннотаций. Кроме того, модель демонстрирует высокую межрегиональную адаптивность, поддерживая множество диалектов, включая северо-восточный мандаринский, сычуаньский, хэнаньский, кантонский и тайваньский акценты, а также способна к голосовому исполнению с учетом персонажа.
Являясь ключевой вехой в дорожной карте голосовых технологий Xiaomi, MiMo-V2-TTS будет и дальше расширять многоязычную поддержку и глубоко интегрироваться с мультимодальными возможностями понимания MiMo-V2-Omni. Этот переход от автономного синтеза речи к скоординированному мультимодальному восприятию и выражению сигнализирует о сдвиге в развитии ИИ-агентов от базового семантического взаимодействия к более личностному и эмоционально резонирующему человеко-компьютерному взаимодействию, что значительно улучшает пользовательский опыт в таких приложениях, как «умные» салоны автомобилей и «умные» дома.








 Бывший главный научный сотрудник OpenAI Илья представляет SSI и раскрывает первую модель
Искусственный интеллект достиг еще одной важной вехи. После своего ухода из OpenAI бывший главный научный сотрудник Илья Сутскер основал компанию Safe Superintelligence Inc. (SSI), которая недавно раскрыла детали своей первой модели. Сообщения в зару
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
14 мая 2026 года платформа разработки приложений на базе искусственного интеллекта Lovable объявила о своем участии в раундеSeed-финансирования на сумму $800 000 для датского стартапа в области аппаратного обеспечения Atech. При ведущем участии Lovab
 Anthropic расширяет инструменты для программирования Claude AI в Японии в рамках стратегии роста за рубежом
Anthropic, prominent U.S. artificial intelligence firm, is intensifying its global outreach. On Wednesday, the company hosted a major developer gathering, "Code with Claude," in Tokyo, drawing close to 500 software engineers. This initiative seeks to

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

В 2026 году лучшие и наиболее популярные инструменты для творческого мышления с использованием ИИ для художников были отобраны XIX.AI, чтобы помочь создателям преодолеть визуальные блоки и мгновенно повысить креативность. Эти мощные инструменты, меняющие правила игры, предлагают реальные тесты, подробное сравнение бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите идеальный инструмент для ускорения создания контента и откройте свой ИИ-преимущество уже сегодня. Исследуйте сейчас!
14 инструментов
xix.ai

Xiaomi's new MiMo-V2-TTS looks promising for dialect support, but I'm still skeptical about how well it handles complex emotional shifts in real-time conversations. 🤔 The tech is impressive, yet the uncanny valley effect might linger for some users. Let's see if it can truly mimic the subtle nuances of human speech without sounding robotic after long usage. 🎙️✨
Wait, so Xiaomi's new model can synthesize voice with dialects AND emotions? That's either incredibly useful for localization or terrifying for deepfakes. I wonder how they handle tonal languages like Chinese... also, rip voice actors? 😬
Finally! Xiaomi's MiMo-V2-TTS sounds interesting, but I wonder if it can handle my Scottish accent? 🏴 Also, privacy concerns about voice data? 🤔












