


 首頁
OpenAI 發布 GeneBench-Pro 基準測試,以提升 AI 生物分析能力
隨著生物技術的快速發展,如何高效且精確地分析複雜的生物數據,已成為研究人員面臨的一大挑戰。 為了讓人工智慧模型在這個領域具備更強大的分析能力,OpenAI 近期推出了一項名為 GeneBench-Pro 的新基準測試。這項基準測試旨在評估人工智慧在基因組學和蛋白質組學等領域的實際研究能力,特別是面對雜亂且不完整數據時進行判斷與決策的能力。
GeneBench-Pro 與傳統基準測試截然不同。傳統測試往往著重於模型的記憶容量以及遵循固定任務序列的能力,而 GeneBench-Pro 則強調其在真實世界研究中的實用性。 其任務建構於「模糊、不完整且雜訊充斥」的數據環境之上,讓模型能在此類條件下進行探索與分析,從而更準確地反映其判斷能力。
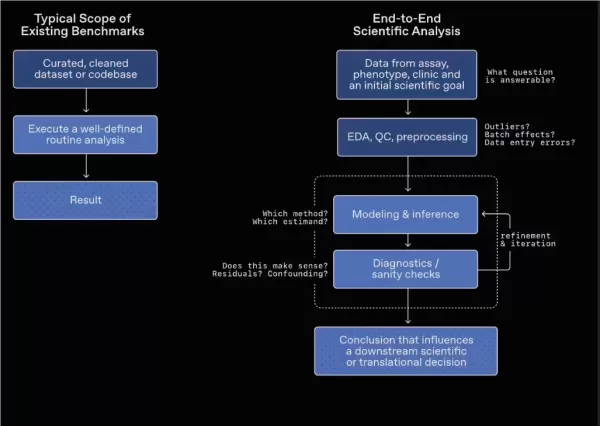
此基準測試涵蓋廣泛的生物學領域,包括基因組學、定量生物學及轉譯醫學,共計 129 道題目橫跨統計遺傳學、群體遺傳學、功能基因組學及蛋白質體學等子領域。 每道題目均提供接近真實研究環境的資料集,要求模型獨立選擇分析方法、根據簡要的實驗背景調整策略,並最終得出結論。
為避免傳統長流程測試中常見的評分偏誤,OpenAI 在設計 GeneBench-Pro 時採用了合成數據。此方法使 OpenAI 能更嚴密地控制數據生成過程,確保模型表現反映的是真正的理解,而非透過猜測或捷徑獲得的正確答案。
OpenAI 已在 Hugging Face 平台上開源了 GeneBench-Pro 的 10 道代表性樣本題目,讓外部研究人員能透過互動式介面進行探索。未來,OpenAI 計畫將其中 50 道題目交由 Artificial Analysis 進行獨立評估,以驗證不同模型在此基準測試中的實際表現。
相關文章
 MiniMax 2.5 登頂全球使用量榜首,月營收超 1.5 億美元;旗艦版 M3 預計上半年釋出
中國大語言模型正以其在成本效益和工程卓越方面的聲譽,在全球開發者生態系統中產生強勁勢頭。截至 2026 年 3 月 3 日,全球領先的 API 聚合平臺 OpenRouter 的資料顯示,國產模型呈現出前所未有的主導地位:MiniMax M2.5 位居全球呼叫量榜首,緊隨其後的是 Kimi K2.5 和 GLM-5。這一“前三甲”陣容表明,中國提供商已透過更優的 AI 部署效率和強勁的開發者採用率,超越了國際競爭對手。七天內處理 3.07 萬億 Token:MiniMax 的快速擴張Min
Meta 的 Muse 在早期移動釋出中超越 ChatGPT
新資料顯示,Meta 最新的 AI 應用 Muse 可能成為這家社交巨頭的下一個重大成功。根據 Appfigures 最近的估算,Muse 在前 12 天內的移動裝置下載次數超過了 ChatGPT 在釋出後 12 天內的下載量。(該資料僅涵蓋美國和加拿大市場。)該公司還發現,Muse 的日活躍使用者數超過了 ChatGPT 在同一階段的使用者數。在此之前,由於兩款應用的釋出策略不同,直接比較這兩款應用一直具有挑戰性。ChatGPT 在全球範圍內釋出,但僅在 iOS 平臺上提供;而 Muse 在蘋果
TechCrunch Disrupt 2026:Clay 公司的卡里姆·阿明談 GTM 工程師的崛起
兩年前,在大多數組織中幾乎找不到 GTM 工程師的身影。如今,這個職位正在整個科技產業中嶄露頭角,相關專業人士透過運用人工智慧與自動化技術,建構出以往需要僱用多名人員、使用多種工具,並仰賴勞動密集型手動工作流程才能實現的營收引擎。是什麼觸發了這場變革?這對企業的客戶獲取與業務擴張又將產生什麼影響?在 TechCrunch Disrupt 2026 大會上,Clay 共同創辦人暨執行長卡里姆·阿明(
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (0)
0/500
隨著生物技術的快速發展,如何高效且精確地分析複雜的生物數據,已成為研究人員面臨的一大挑戰。 為了讓人工智慧模型在這個領域具備更強大的分析能力,OpenAI 近期推出了一項名為 GeneBench-Pro 的新基準測試。這項基準測試旨在評估人工智慧在基因組學和蛋白質組學等領域的實際研究能力,特別是面對雜亂且不完整數據時進行判斷與決策的能力。
GeneBench-Pro 與傳統基準測試截然不同。傳統測試往往著重於模型的記憶容量以及遵循固定任務序列的能力,而 GeneBench-Pro 則強調其在真實世界研究中的實用性。 其任務建構於「模糊、不完整且雜訊充斥」的數據環境之上,讓模型能在此類條件下進行探索與分析,從而更準確地反映其判斷能力。
此基準測試涵蓋廣泛的生物學領域,包括基因組學、定量生物學及轉譯醫學,共計 129 道題目橫跨統計遺傳學、群體遺傳學、功能基因組學及蛋白質體學等子領域。 每道題目均提供接近真實研究環境的資料集,要求模型獨立選擇分析方法、根據簡要的實驗背景調整策略,並最終得出結論。
為避免傳統長流程測試中常見的評分偏誤,OpenAI 在設計 GeneBench-Pro 時採用了合成數據。此方法使 OpenAI 能更嚴密地控制數據生成過程,確保模型表現反映的是真正的理解,而非透過猜測或捷徑獲得的正確答案。
OpenAI 已在 Hugging Face 平台上開源了 GeneBench-Pro 的 10 道代表性樣本題目,讓外部研究人員能透過互動式介面進行探索。未來,OpenAI 計畫將其中 50 道題目交由 Artificial Analysis 進行獨立評估,以驗證不同模型在此基準測試中的實際表現。








 MiniMax 2.5 登頂全球使用量榜首,月營收超 1.5 億美元;旗艦版 M3 預計上半年釋出
中國大語言模型正以其在成本效益和工程卓越方面的聲譽,在全球開發者生態系統中產生強勁勢頭。截至 2026 年 3 月 3 日,全球領先的 API 聚合平臺 OpenRouter 的資料顯示,國產模型呈現出前所未有的主導地位:MiniMax M2.5 位居全球呼叫量榜首,緊隨其後的是 Kimi K2.5 和 GLM-5。這一“前三甲”陣容表明,中國提供商已透過更優的 AI 部署效率和強勁的開發者採用率,超越了國際競爭對手。七天內處理 3.07 萬億 Token:MiniMax 的快速擴張Min
 Meta 的 Muse 在早期移動釋出中超越 ChatGPT
新資料顯示,Meta 最新的 AI 應用 Muse 可能成為這家社交巨頭的下一個重大成功。根據 Appfigures 最近的估算,Muse 在前 12 天內的移動裝置下載次數超過了 ChatGPT 在釋出後 12 天內的下載量。(該資料僅涵蓋美國和加拿大市場。)該公司還發現,Muse 的日活躍使用者數超過了 ChatGPT 在同一階段的使用者數。在此之前,由於兩款應用的釋出策略不同,直接比較這兩款應用一直具有挑戰性。ChatGPT 在全球範圍內釋出,但僅在 iOS 平臺上提供;而 Muse 在蘋果
 TechCrunch Disrupt 2026:Clay 公司的卡里姆·阿明談 GTM 工程師的崛起
兩年前,在大多數組織中幾乎找不到 GTM 工程師的身影。如今,這個職位正在整個科技產業中嶄露頭角,相關專業人士透過運用人工智慧與自動化技術,建構出以往需要僱用多名人員、使用多種工具,並仰賴勞動密集型手動工作流程才能實現的營收引擎。是什麼觸發了這場變革?這對企業的客戶獲取與業務擴張又將產生什麼影響?在 TechCrunch Disrupt 2026 大會上,Clay 共同創辦人暨執行長卡里姆·阿明(

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai












