


 Maison
OpenAI lance le benchmark GeneBench-Pro pour dynamiser l'analyse biologique par l'IA
Face aux progrès rapides de la biotechnologie, l'analyse efficace et précise de données biologiques complexes est devenue un défi majeur pour les chercheurs. Afin de doter les modèles d’IA de compétences analytiques plus solides dans ce domaine, OpenAI a récemment lancé un nouveau benchmark appelé GeneBench-Pro. Ce benchmark est conçu pour évaluer les capacités pratiques de l’IA en matière de recherche dans des domaines tels que la génomique et la protéomique, en particulier sa capacité à émettre des jugements et à prendre des décisions face à des données désordonnées et incomplètes.
GeneBench-Pro se distingue des benchmarks traditionnels. Alors que les tests conventionnels se concentrent souvent sur la capacité de mémoire d’un modèle et sa capacité à suivre des séquences de tâches fixes, GeneBench-Pro met l’accent sur l’utilité de l’IA dans la recherche en situation réelle. Ses tâches s’articulent autour d’un environnement de données « flou, incomplet et bruité », permettant au modèle d’explorer et d’analyser dans de telles conditions, ce qui reflète plus fidèlement ses capacités de jugement.
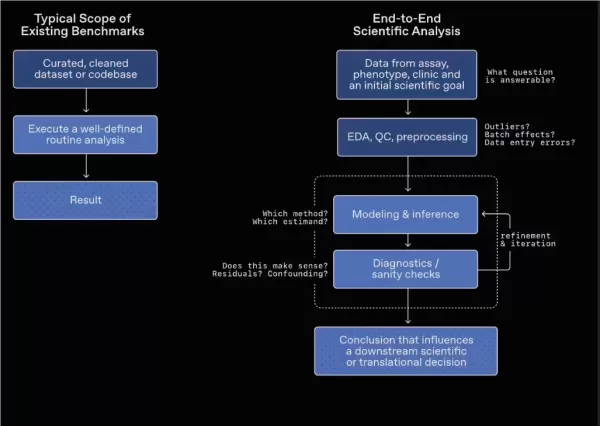
Ce benchmark couvre un large éventail de domaines biologiques, notamment la génomique, la biologie quantitative et la médecine translationnelle, avec 129 questions couvrant des sous-domaines tels que la génétique statistique, la génétique des populations, la génomique fonctionnelle et la protéomique. Chaque question fournit un ensemble de données proche d’un environnement de recherche réel, exigeant du modèle qu’il choisisse de manière autonome des méthodes d’analyse, adapte ses stratégies en fonction de brèves descriptions expérimentales et, enfin, tire des conclusions.
Afin d’éviter les biais de notation courants dans les tests traditionnels à long terme, OpenAI a utilisé des données synthétiques lors de la conception de GeneBench-Pro. Cette approche permet à OpenAI d’exercer un contrôle plus strict sur le processus de génération des données, garantissant ainsi que les performances du modèle reflètent une véritable compréhension plutôt que des réponses correctes obtenues par devinette ou par des raccourcis.
OpenAI a mis en open source 10 questions représentatives tirées de GeneBench-Pro sur la plateforme Hugging Face, permettant ainsi aux chercheurs externes de les explorer via une interface interactive. À l’avenir, OpenAI prévoit de confier 50 de ces questions à Artificial Analysis pour une évaluation indépendante, afin de vérifier les performances réelles des différents modèles sur ce benchmark.
Article connexe
 MiniMax 2.5 en tête des utilisations mondiales avec plus de 150 millions de dollars de revenus mensuels ; version phare M3 prévue pour le premier semestre
Les grands modèles de langage chinois génèrent une dynamique intense à travers l'écosystème mondial des développeurs, portés par leur réputation d'efficacité en matière de coûts et d'excellence en ingénierie.Au 3 mars 2026, les données d'OpenRouter,
Le lancement précoce de Muse de Meta sur mobile dépasse celui de ChatGPT
De nouvelles données suggèrent que la dernière application d’intelligence artificielle de Meta, Muse, pourrait devenir le prochain grand succès du géant des réseaux sociaux. Selon des estimations récentes d’Appfigures, Muse a été téléchargée sur les
TechCrunch Disrupt 2026 : Kareem Amin, de Clay, revient sur l'essor du métier d'ingénieur GTM
Il y a deux ans, les ingénieurs GTM étaient pratiquement inexistants dans la plupart des entreprises. Aujourd’hui, ce métier se développe dans l’ensemble du secteur technologique, où des professionnel
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Face aux progrès rapides de la biotechnologie, l'analyse efficace et précise de données biologiques complexes est devenue un défi majeur pour les chercheurs. Afin de doter les modèles d’IA de compétences analytiques plus solides dans ce domaine, OpenAI a récemment lancé un nouveau benchmark appelé GeneBench-Pro. Ce benchmark est conçu pour évaluer les capacités pratiques de l’IA en matière de recherche dans des domaines tels que la génomique et la protéomique, en particulier sa capacité à émettre des jugements et à prendre des décisions face à des données désordonnées et incomplètes.
GeneBench-Pro se distingue des benchmarks traditionnels. Alors que les tests conventionnels se concentrent souvent sur la capacité de mémoire d’un modèle et sa capacité à suivre des séquences de tâches fixes, GeneBench-Pro met l’accent sur l’utilité de l’IA dans la recherche en situation réelle. Ses tâches s’articulent autour d’un environnement de données « flou, incomplet et bruité », permettant au modèle d’explorer et d’analyser dans de telles conditions, ce qui reflète plus fidèlement ses capacités de jugement.
Ce benchmark couvre un large éventail de domaines biologiques, notamment la génomique, la biologie quantitative et la médecine translationnelle, avec 129 questions couvrant des sous-domaines tels que la génétique statistique, la génétique des populations, la génomique fonctionnelle et la protéomique. Chaque question fournit un ensemble de données proche d’un environnement de recherche réel, exigeant du modèle qu’il choisisse de manière autonome des méthodes d’analyse, adapte ses stratégies en fonction de brèves descriptions expérimentales et, enfin, tire des conclusions.
Afin d’éviter les biais de notation courants dans les tests traditionnels à long terme, OpenAI a utilisé des données synthétiques lors de la conception de GeneBench-Pro. Cette approche permet à OpenAI d’exercer un contrôle plus strict sur le processus de génération des données, garantissant ainsi que les performances du modèle reflètent une véritable compréhension plutôt que des réponses correctes obtenues par devinette ou par des raccourcis.
OpenAI a mis en open source 10 questions représentatives tirées de GeneBench-Pro sur la plateforme Hugging Face, permettant ainsi aux chercheurs externes de les explorer via une interface interactive. À l’avenir, OpenAI prévoit de confier 50 de ces questions à Artificial Analysis pour une évaluation indépendante, afin de vérifier les performances réelles des différents modèles sur ce benchmark.








 MiniMax 2.5 en tête des utilisations mondiales avec plus de 150 millions de dollars de revenus mensuels ; version phare M3 prévue pour le premier semestre
Les grands modèles de langage chinois génèrent une dynamique intense à travers l'écosystème mondial des développeurs, portés par leur réputation d'efficacité en matière de coûts et d'excellence en ingénierie.Au 3 mars 2026, les données d'OpenRouter,
 Le lancement précoce de Muse de Meta sur mobile dépasse celui de ChatGPT
De nouvelles données suggèrent que la dernière application d’intelligence artificielle de Meta, Muse, pourrait devenir le prochain grand succès du géant des réseaux sociaux. Selon des estimations récentes d’Appfigures, Muse a été téléchargée sur les
 TechCrunch Disrupt 2026 : Kareem Amin, de Clay, revient sur l'essor du métier d'ingénieur GTM
Il y a deux ans, les ingénieurs GTM étaient pratiquement inexistants dans la plupart des entreprises. Aujourd’hui, ce métier se développe dans l’ensemble du secteur technologique, où des professionnel

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












