


 Heim
OpenAI veröffentlicht den GeneBench-Pro-Benchmark zur Förderung der biologischen Analyse mittels KI
Angesichts des rasanten Fortschritts in der Biotechnologie ist die effiziente und präzise Analyse komplexer biologischer Daten zu einer großen Herausforderung für Forscher geworden. Um KI-Modelle mit besseren Analysefähigkeiten in diesem Bereich auszustatten, hat OpenAI kürzlich einen neuen Benchmark namens GeneBench-Pro eingeführt. Dieser Benchmark dient dazu, die praktischen Forschungsfähigkeiten von KI in Bereichen wie Genomik und Proteomik zu bewerten, insbesondere ihre Fähigkeit, bei unübersichtlichen und unvollständigen Daten Urteile zu fällen und Entscheidungen zu treffen.
GeneBench-Pro unterscheidet sich von herkömmlichen Benchmarks. Während sich konventionelle Tests oft auf die Speicherkapazität eines Modells und dessen Fähigkeit konzentrieren, festgelegte Aufgabenabläufe zu befolgen, legt GeneBench-Pro den Schwerpunkt auf den praktischen Nutzen in der realen Forschung. Die Aufgaben basieren auf einer „unscharfen, unvollständigen und verrauschten“ Datenumgebung, sodass das Modell unter solchen Bedingungen explorieren und analysieren kann, was seine Beurteilungsfähigkeiten genauer widerspiegelt.
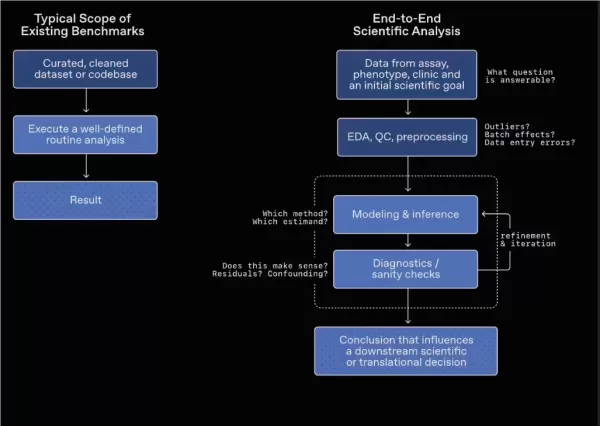
Dieser Benchmark deckt ein breites Spektrum biologischer Fachgebiete ab, darunter Genomik, quantitative Biologie und translationale Medizin, mit 129 Fragestellungen, die Teilgebiete wie statistische Genetik, Populationsgenetik, funktionelle Genomik und Proteomik umfassen. Jede Frage liefert einen Datensatz, der einer realen Forschungsumgebung nahekommt, und erfordert vom Modell, eigenständig Analysemethoden auszuwählen, Strategien auf der Grundlage kurzer experimenteller Hintergründe anzupassen und schließlich Schlussfolgerungen zu ziehen.
Um Bewertungsverzerrungen zu vermeiden, die bei herkömmlichen Langzeittests häufig auftreten, verwendete OpenAI bei der Entwicklung von GeneBench-Pro synthetische Daten. Dieser Ansatz ermöglicht OpenAI eine strengere Kontrolle über den Datengenerierungsprozess und stellt sicher, dass die Modellleistung echtes Verständnis widerspiegelt und nicht auf richtigen Antworten beruht, die durch Raten oder Abkürzungen erzielt wurden.
OpenAI hat 10 repräsentative Beispielfragen aus GeneBench-Pro auf der Hugging-Face-Plattform als Open-Source-Material veröffentlicht, sodass externe Forscher diese über eine interaktive Schnittstelle untersuchen können. Für die Zukunft plant OpenAI, 50 dieser Fragen an „Artificial Analysis“ zur unabhängigen Bewertung zu übergeben, um die tatsächliche Leistung verschiedener Modelle bei diesem Benchmark zu überprüfen.
Verwandter Artikel
 MiniMax 2.5 führt die globale Nutzung an mit monatlichen Einnahmen von über 150 Millionen US-Dollar; M3-Flaggschiff-Version für Veröffentlichung im ersten Halbjahr geplant
Chinesische Large-Language-Modelle entfalten im globalen Entwickler-Ökosystem eine intensive Dynamik, angetrieben von ihrem Ruf hinsichtlich Kosteneffizienz und ingenieurtechnischer Exzellenz.Stand 3. März 2026 offenbart die Datenbasis der weltweit f
Metas Muse überholt ChatGPT bei der frühen mobilen Einführung
Neue Daten deuten darauf hin, dass Metas neueste KI-App „Muse“ zum nächsten großen Erfolg des Social-Media-Riesen werden könnte. Schätzungen von Appfigures zufolge wurde „Muse“ in den ersten zwölf Tagen nach dem Start auf Mobilgeräten häufiger herunt
TechCrunch Disrupt 2026: Kareem Amin von Clay über den Aufstieg des GTM-Ingenieurs
Vor zwei Jahren gab es in den meisten Unternehmen so gut wie keine GTM-Ingenieure. Heute etabliert sich diese Rolle zunehmend im gesamten Technologiesektor, wobei Fachkräfte KI und Automatisierung nut
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Angesichts des rasanten Fortschritts in der Biotechnologie ist die effiziente und präzise Analyse komplexer biologischer Daten zu einer großen Herausforderung für Forscher geworden. Um KI-Modelle mit besseren Analysefähigkeiten in diesem Bereich auszustatten, hat OpenAI kürzlich einen neuen Benchmark namens GeneBench-Pro eingeführt. Dieser Benchmark dient dazu, die praktischen Forschungsfähigkeiten von KI in Bereichen wie Genomik und Proteomik zu bewerten, insbesondere ihre Fähigkeit, bei unübersichtlichen und unvollständigen Daten Urteile zu fällen und Entscheidungen zu treffen.
GeneBench-Pro unterscheidet sich von herkömmlichen Benchmarks. Während sich konventionelle Tests oft auf die Speicherkapazität eines Modells und dessen Fähigkeit konzentrieren, festgelegte Aufgabenabläufe zu befolgen, legt GeneBench-Pro den Schwerpunkt auf den praktischen Nutzen in der realen Forschung. Die Aufgaben basieren auf einer „unscharfen, unvollständigen und verrauschten“ Datenumgebung, sodass das Modell unter solchen Bedingungen explorieren und analysieren kann, was seine Beurteilungsfähigkeiten genauer widerspiegelt.
Dieser Benchmark deckt ein breites Spektrum biologischer Fachgebiete ab, darunter Genomik, quantitative Biologie und translationale Medizin, mit 129 Fragestellungen, die Teilgebiete wie statistische Genetik, Populationsgenetik, funktionelle Genomik und Proteomik umfassen. Jede Frage liefert einen Datensatz, der einer realen Forschungsumgebung nahekommt, und erfordert vom Modell, eigenständig Analysemethoden auszuwählen, Strategien auf der Grundlage kurzer experimenteller Hintergründe anzupassen und schließlich Schlussfolgerungen zu ziehen.
Um Bewertungsverzerrungen zu vermeiden, die bei herkömmlichen Langzeittests häufig auftreten, verwendete OpenAI bei der Entwicklung von GeneBench-Pro synthetische Daten. Dieser Ansatz ermöglicht OpenAI eine strengere Kontrolle über den Datengenerierungsprozess und stellt sicher, dass die Modellleistung echtes Verständnis widerspiegelt und nicht auf richtigen Antworten beruht, die durch Raten oder Abkürzungen erzielt wurden.
OpenAI hat 10 repräsentative Beispielfragen aus GeneBench-Pro auf der Hugging-Face-Plattform als Open-Source-Material veröffentlicht, sodass externe Forscher diese über eine interaktive Schnittstelle untersuchen können. Für die Zukunft plant OpenAI, 50 dieser Fragen an „Artificial Analysis“ zur unabhängigen Bewertung zu übergeben, um die tatsächliche Leistung verschiedener Modelle bei diesem Benchmark zu überprüfen.








 MiniMax 2.5 führt die globale Nutzung an mit monatlichen Einnahmen von über 150 Millionen US-Dollar; M3-Flaggschiff-Version für Veröffentlichung im ersten Halbjahr geplant
Chinesische Large-Language-Modelle entfalten im globalen Entwickler-Ökosystem eine intensive Dynamik, angetrieben von ihrem Ruf hinsichtlich Kosteneffizienz und ingenieurtechnischer Exzellenz.Stand 3. März 2026 offenbart die Datenbasis der weltweit f
 Metas Muse überholt ChatGPT bei der frühen mobilen Einführung
Neue Daten deuten darauf hin, dass Metas neueste KI-App „Muse“ zum nächsten großen Erfolg des Social-Media-Riesen werden könnte. Schätzungen von Appfigures zufolge wurde „Muse“ in den ersten zwölf Tagen nach dem Start auf Mobilgeräten häufiger herunt
 TechCrunch Disrupt 2026: Kareem Amin von Clay über den Aufstieg des GTM-Ingenieurs
Vor zwei Jahren gab es in den meisten Unternehmen so gut wie keine GTM-Ingenieure. Heute etabliert sich diese Rolle zunehmend im gesamten Technologiesektor, wobei Fachkräfte KI und Automatisierung nut

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












