


 家
OpenAI、AIによる生物学的解析を促進するため「GeneBench-Pro」ベンチマークを公開
バイオテクノロジーの急速な進歩に伴い、複雑な生物学的データを効率的かつ正確に分析することは、研究者にとって大きな課題となっています。 この分野においてAIモデルにより強力な分析能力を備えさせるため、OpenAIは最近、「GeneBench-Pro」と呼ばれる新しいベンチマークを導入しました。このベンチマークは、ゲノミクスやプロテオミクスなどの分野におけるAIの実用的な研究能力、特に乱雑で不完全なデータに直面した際の判断・意思決定能力を評価するために設計されています。
GeneBench-Proは、従来のベンチマークとは一線を画しています。従来のテストは、モデルの記憶容量や固定されたタスクシーケンスに従う能力に焦点を当てることが多いのに対し、GeneBench-Proは実世界の研究における有用性を重視しています。 そのタスクは、「曖昧で、不完全で、ノイズの多い」データ環境を前提として構築されており、モデルがそのような条件下で探索・分析を行うことを可能にすることで、その判断能力をより正確に反映しています。
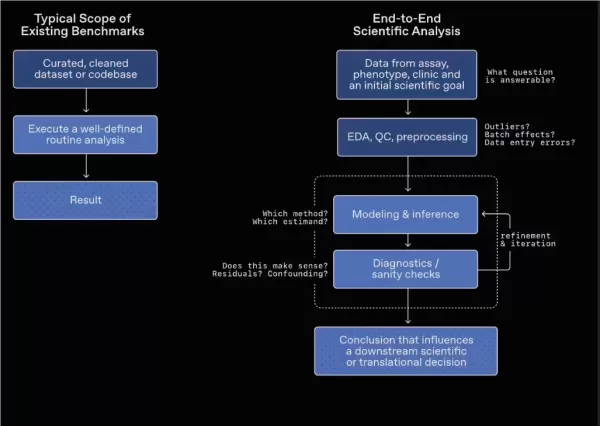
このベンチマークは、ゲノミクス、定量的生物学、トランスレーショナル・メディシンなど、幅広い生物学分野を網羅しており、統計遺伝学、集団遺伝学、機能ゲノミクス、プロテオミクスといったサブ分野にわたる129の課題が含まれています。 各問題には、実際の研究環境に近いデータセットが用意されており、モデルは独自に分析手法を選択し、簡潔な実験背景に基づいて戦略を調整し、最終的に結論を導き出すことが求められます。
従来の長期プロセス型テストでよく見られる採点バイアスを回避するため、OpenAIはGeneBench-Proの設計に合成データを採用しました。このアプローチにより、OpenAIはデータ生成プロセスを厳密に制御でき、モデルのパフォーマンスが、推測や近道によって得られた正解ではなく、真の理解を反映していることを保証します。
OpenAIは、Hugging Faceプラットフォーム上でGeneBench-Proの代表的なサンプル問題10問をオープンソース化し、外部の研究者がインタラクティブなインターフェースを通じてこれらを検証できるようにした。将来的には、OpenAIはこれらの問題のうち50問をArtificial Analysisに割り当て、独立した評価を行わせることで、このベンチマークにおける各モデルの実際の性能を検証する計画である。
関連記事
 MiniMax 2.5が月間収益1億5000万ドル超を記録し、グローバル利用でトップに躍進。フラッグシップ版「M3」は上半期にリリース予定
中国の大規模言語モデルは、コスト効率性とエンジニアリングの卓越性という評判を背景に、グローバルな開発者エコシステム全体で強い勢いを生み出している。2026年3月3日時点での、世界最大のAPI集約プラットフォームであるOpenRouterのデータによると、国内モデルによる前例のない支配力が明らかになっている:MiniMax M2.5がグローバルな呼び出し数で首位に立ち、Kimi K2.5とGLM-5がこれに続く。この「トップ3」のラインナップは、中国の企業がAIデプロイメントにおける優れた効率性
MetaのMuseは、モバイルでの早期ローンチにおいてChatGPTを上回る
最新のデータによると、Metaの最新AIアプリ「Muse」が、同社のソーシャルメディア巨人の次の大きな成功となる可能性があることが示唆されている。Appfiguresの最近の見積もりによれば、Museは最初の12日間でモバイルデバイスにダウンロードされた回数が、ChatGPTがローンチ後の12日間でダウンロードされた回数を超えている。(このデータは米国とカナダの市場のみをカバーしている。)同社はまた、Museが同じ段階にあるChatGPTよりも多くのデイリーアクティブユーザー(DAU)を持ってい
TechCrunch Disrupt 2026:Clay社のカリーム・アミン氏が語る、GTMエンジニアの台頭
2年前、ほとんどの組織にはGTMエンジニアは事実上存在しませんでした。今日、この役割はテクノロジー業界全体で台頭しつつあり、専門家たちはAIや自動化を活用して、以前は複数の人員、ばらばらのツール、そして労力を要する手作業のワークフローを必要としていた収益創出の仕組みを構築しています。この変化のきっかけは何だったのか、そして企業が顧客を獲得し、事業を拡大していく上でどのような意味を持つのだろうか?T
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
バイオテクノロジーの急速な進歩に伴い、複雑な生物学的データを効率的かつ正確に分析することは、研究者にとって大きな課題となっています。 この分野においてAIモデルにより強力な分析能力を備えさせるため、OpenAIは最近、「GeneBench-Pro」と呼ばれる新しいベンチマークを導入しました。このベンチマークは、ゲノミクスやプロテオミクスなどの分野におけるAIの実用的な研究能力、特に乱雑で不完全なデータに直面した際の判断・意思決定能力を評価するために設計されています。
GeneBench-Proは、従来のベンチマークとは一線を画しています。従来のテストは、モデルの記憶容量や固定されたタスクシーケンスに従う能力に焦点を当てることが多いのに対し、GeneBench-Proは実世界の研究における有用性を重視しています。 そのタスクは、「曖昧で、不完全で、ノイズの多い」データ環境を前提として構築されており、モデルがそのような条件下で探索・分析を行うことを可能にすることで、その判断能力をより正確に反映しています。
このベンチマークは、ゲノミクス、定量的生物学、トランスレーショナル・メディシンなど、幅広い生物学分野を網羅しており、統計遺伝学、集団遺伝学、機能ゲノミクス、プロテオミクスといったサブ分野にわたる129の課題が含まれています。 各問題には、実際の研究環境に近いデータセットが用意されており、モデルは独自に分析手法を選択し、簡潔な実験背景に基づいて戦略を調整し、最終的に結論を導き出すことが求められます。
従来の長期プロセス型テストでよく見られる採点バイアスを回避するため、OpenAIはGeneBench-Proの設計に合成データを採用しました。このアプローチにより、OpenAIはデータ生成プロセスを厳密に制御でき、モデルのパフォーマンスが、推測や近道によって得られた正解ではなく、真の理解を反映していることを保証します。
OpenAIは、Hugging Faceプラットフォーム上でGeneBench-Proの代表的なサンプル問題10問をオープンソース化し、外部の研究者がインタラクティブなインターフェースを通じてこれらを検証できるようにした。将来的には、OpenAIはこれらの問題のうち50問をArtificial Analysisに割り当て、独立した評価を行わせることで、このベンチマークにおける各モデルの実際の性能を検証する計画である。








 MiniMax 2.5が月間収益1億5000万ドル超を記録し、グローバル利用でトップに躍進。フラッグシップ版「M3」は上半期にリリース予定
中国の大規模言語モデルは、コスト効率性とエンジニアリングの卓越性という評判を背景に、グローバルな開発者エコシステム全体で強い勢いを生み出している。2026年3月3日時点での、世界最大のAPI集約プラットフォームであるOpenRouterのデータによると、国内モデルによる前例のない支配力が明らかになっている:MiniMax M2.5がグローバルな呼び出し数で首位に立ち、Kimi K2.5とGLM-5がこれに続く。この「トップ3」のラインナップは、中国の企業がAIデプロイメントにおける優れた効率性
 MetaのMuseは、モバイルでの早期ローンチにおいてChatGPTを上回る
最新のデータによると、Metaの最新AIアプリ「Muse」が、同社のソーシャルメディア巨人の次の大きな成功となる可能性があることが示唆されている。Appfiguresの最近の見積もりによれば、Museは最初の12日間でモバイルデバイスにダウンロードされた回数が、ChatGPTがローンチ後の12日間でダウンロードされた回数を超えている。(このデータは米国とカナダの市場のみをカバーしている。)同社はまた、Museが同じ段階にあるChatGPTよりも多くのデイリーアクティブユーザー(DAU)を持ってい
 TechCrunch Disrupt 2026:Clay社のカリーム・アミン氏が語る、GTMエンジニアの台頭
2年前、ほとんどの組織にはGTMエンジニアは事実上存在しませんでした。今日、この役割はテクノロジー業界全体で台頭しつつあり、専門家たちはAIや自動化を活用して、以前は複数の人員、ばらばらのツール、そして労力を要する手作業のワークフローを必要としていた収益創出の仕組みを構築しています。この変化のきっかけは何だったのか、そして企業が顧客を獲得し、事業を拡大していく上でどのような意味を持つのだろうか?T

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












