


 首頁
Google 推出 Gemini Embedding2:原生多模態模型整合語義空間
Google 近期推出了其全新的原生多模態嵌入模型「Gemini Embedding2」。該模型能將文字、圖像、影片、音訊及 PDF 文件映射至一個共享的語義向量空間,旨在簡化複雜的 AI 資料工作流程,並提升多模態檢索與理解能力。這代表著 Google 在嵌入技術上的重大進展,從單一模態的文字處理邁向統一的多模態語義建模。
此前,在 2025 年 7 月,Google 推出了gemini-embedding-001文字嵌入模型。該模型支援超過 100 種語言,並在 MTEB 多語言基準測試中取得頂尖成績。 全新的 Gemini Embedding2 基於 Gemini 架構,但大幅擴展了其應用範圍。它現在可處理五種不同模態——文字、圖像、影片、音訊和 PDF——並將其投影至單一向量空間。這使得不同類型媒體之間能夠進行直接的語義比較,無需使用多個專用模型或額外的處理步驟。此功能對於語義搜尋、檢索增強生成(RAG)、情緒分析及資料聚類等應用尤為寶貴。
在輸入能力方面,新模型支援多達 8192 個文字標記,是先前 2048 個標記限制的四倍。它每筆請求可處理多達六張 PNG 或 JPEG 圖片、長度達 120 秒的影片,以及最多六頁的 PDF 文件。 值得注意的是,Gemini Embedding2 原生支援音訊處理,無需進行語音轉文字轉換,從而避免了轉錄過程中的潛在資訊損失。Google 還推出了「交錯輸入」技術,讓開發者能在單次請求中結合多種模態——例如將圖片與描述性文字混合——以更精準地捕捉它們之間的語義關聯。
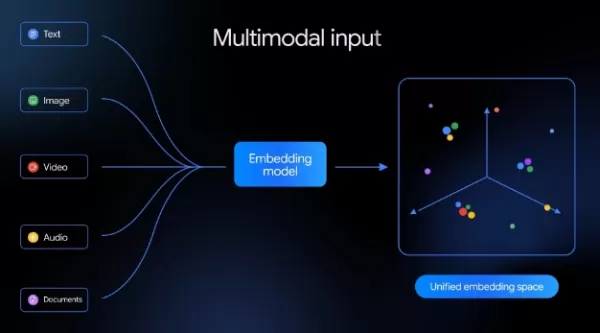
在架構上,該模型持續採用「套娃式表徵學習」(MRL)。此技術利用分層結構動態調整向量維度。預設嵌入維度為 3072,並提供 1536 和 768 兩種可選配置,讓開發者能靈活地在檢索準確度與儲存效率之間取得平衡。
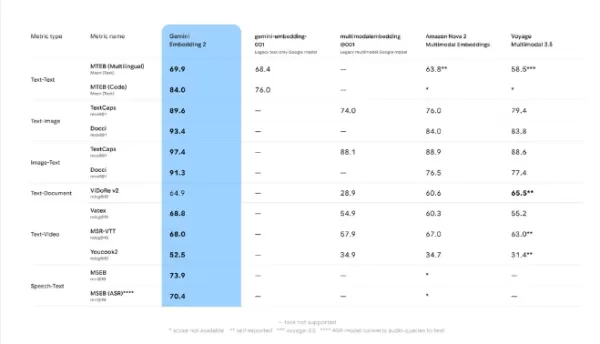
Google 的基準測試結果顯示,Gemini Embedding2 在文字、圖像、影片和語音任務中均展現領先的表現。例如,在文字-影片檢索任務中,其得分達 68.8,超越了 Amazon Nova2 多模態嵌入模型(60.3)和 Voyage Multimodal3.5(55.2)。 在文字-圖像對比中,其得分達 93.4,顯著領先於亞馬遜模型的 84.0 分。
開發者目前可透過Gemini API和Vertex AI 存取 Gemini Embedding2。該模型已整合至 LangChain、LlamaIndex、Haystack、Weaviate、Qdrant、ChromaDB 及 Vector Search 等熱門框架與向量資料庫。為協助開發者快速上手,Google 提供了互動式 Colab 筆記本及輕量級多模態語義搜尋示範。
多模態嵌入技術的競爭日趨白熱化。值得注意的是,今年二月底,AI 搜尋引擎 Perplexity 釋出了其開源嵌入模型pplx-embed-v1和pplx-embed-context-v1。
相關文章
 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo
相關專題推薦
聊天機器人
 用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
 10 個工具
 xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

 評論 (0)
0/500
Google 近期推出了其全新的原生多模態嵌入模型「Gemini Embedding2」。該模型能將文字、圖像、影片、音訊及 PDF 文件映射至一個共享的語義向量空間,旨在簡化複雜的 AI 資料工作流程,並提升多模態檢索與理解能力。這代表著 Google 在嵌入技術上的重大進展,從單一模態的文字處理邁向統一的多模態語義建模。
此前,在 2025 年 7 月,Google 推出了gemini-embedding-001文字嵌入模型。該模型支援超過 100 種語言,並在 MTEB 多語言基準測試中取得頂尖成績。 全新的 Gemini Embedding2 基於 Gemini 架構,但大幅擴展了其應用範圍。它現在可處理五種不同模態——文字、圖像、影片、音訊和 PDF——並將其投影至單一向量空間。這使得不同類型媒體之間能夠進行直接的語義比較,無需使用多個專用模型或額外的處理步驟。此功能對於語義搜尋、檢索增強生成(RAG)、情緒分析及資料聚類等應用尤為寶貴。
在輸入能力方面,新模型支援多達 8192 個文字標記,是先前 2048 個標記限制的四倍。它每筆請求可處理多達六張 PNG 或 JPEG 圖片、長度達 120 秒的影片,以及最多六頁的 PDF 文件。 值得注意的是,Gemini Embedding2 原生支援音訊處理,無需進行語音轉文字轉換,從而避免了轉錄過程中的潛在資訊損失。Google 還推出了「交錯輸入」技術,讓開發者能在單次請求中結合多種模態——例如將圖片與描述性文字混合——以更精準地捕捉它們之間的語義關聯。
在架構上,該模型持續採用「套娃式表徵學習」(MRL)。此技術利用分層結構動態調整向量維度。預設嵌入維度為 3072,並提供 1536 和 768 兩種可選配置,讓開發者能靈活地在檢索準確度與儲存效率之間取得平衡。
Google 的基準測試結果顯示,Gemini Embedding2 在文字、圖像、影片和語音任務中均展現領先的表現。例如,在文字-影片檢索任務中,其得分達 68.8,超越了 Amazon Nova2 多模態嵌入模型(60.3)和 Voyage Multimodal3.5(55.2)。 在文字-圖像對比中,其得分達 93.4,顯著領先於亞馬遜模型的 84.0 分。
開發者目前可透過Gemini API和Vertex AI 存取 Gemini Embedding2。該模型已整合至 LangChain、LlamaIndex、Haystack、Weaviate、Qdrant、ChromaDB 及 Vector Search 等熱門框架與向量資料庫。為協助開發者快速上手,Google 提供了互動式 Colab 筆記本及輕量級多模態語義搜尋示範。
多模態嵌入技術的競爭日趨白熱化。值得注意的是,今年二月底,AI 搜尋引擎 Perplexity 釋出了其開源嵌入模型pplx-embed-v1和pplx-embed-context-v1。








 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
 儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai












